
机器学习与深度学习 / 系统课时
保存训练检查点
保存训练检查点
训练任务可能因断电、资源抢占或程序异常中断。本课将把模型参数、优化器状态、训练轮次和指标一起保存,并演示如何恢复这些状态,使训练能够从中断位置继续,而不是重新开始。
学习目标
- 理解检查点与仅保存模型参数的区别
- 使用
torch.save保存完整训练状态 - 使用
torch.load恢复模型、优化器、轮次和指标
检查点需要保存什么
仅保存 model.state_dict() 适合推理部署,但不足以无缝续训。优化器内部可能保存动量、二阶矩等状态;若这些状态丢失,即使模型参数恢复,后续优化轨迹也可能发生变化。
一个实用检查点通常至少包含四类信息:模型参数、优化器状态、已完成轮次和关键指标。恢复时,程序先重建相同结构的模型与优化器,再把保存的状态分别加载进去。
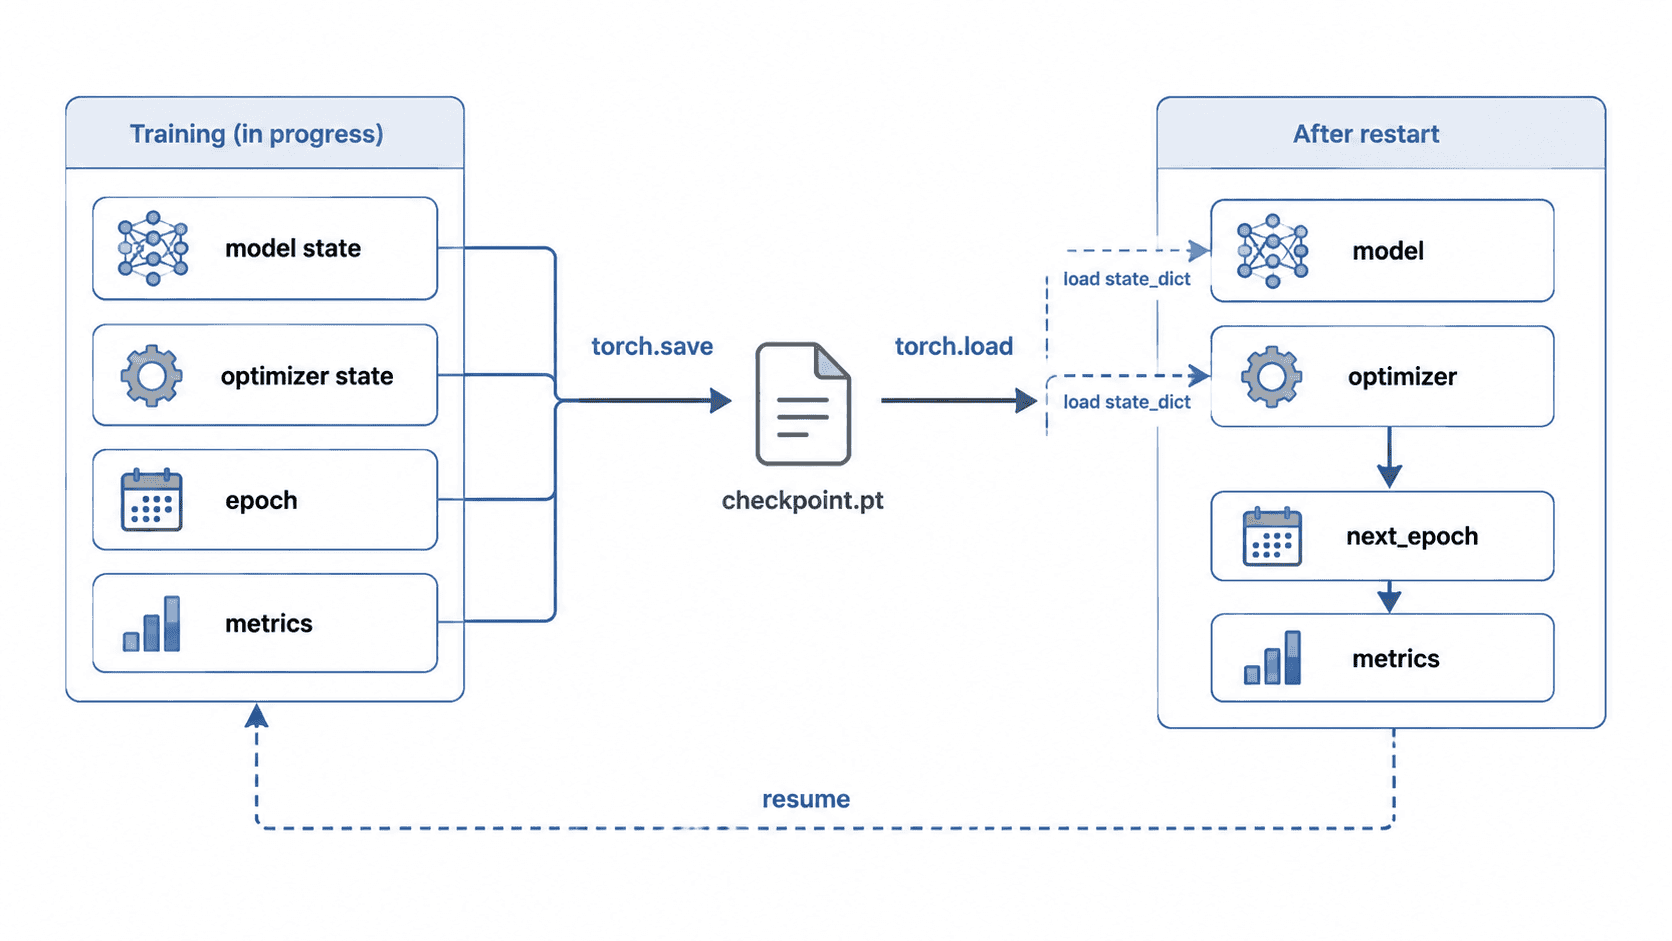
保存并恢复完整状态
下面的程序执行一次参数更新,将状态保存到 checkpoints/demo.pt,随后创建新的模型与优化器并恢复。示例使用固定随机种子,重点验证检查点内容和续训起点。
from pathlib import Path

import torch
from torch import nn
from torch.optim import SGD

def build_model() -> nn.Module:
    return nn.Sequential(
        nn.Linear(2, 4),
        nn.ReLU(),
        nn.Linear(4, 1),
    )

torch.manual_seed(42)

model = build_model()
optimizer = SGD(model.parameters(), lr=0.1, momentum=0.9)
criterion = nn.MSELoss()

features = torch.tensor([[1.0, 2.0], [2.0, 3.0]])
targets = torch.tensor([[5.0], [8.0]])

# 执行一次更新,让模型与优化器都产生可保存状态
optimizer.zero_grad()
loss = criterion(model(features), targets)
loss.backward()
optimizer.step()

checkpoint_path = Path("checkpoints/demo.pt")
checkpoint_path.parent.mkdir(parents=True, exist_ok=True)

torch.save(
    {
        "model_state": model.state_dict(),
        "optimizer_state": optimizer.state_dict(),
        "epoch": 0,
        "metrics": {
            "train_loss": float(loss.item()),
            "val_loss": 12.5,
        },
    },
    checkpoint_path,
)

# 恢复前仍需创建结构兼容的模型与优化器
restored_model = build_model()
restored_optimizer = SGD(
    restored_model.parameters(),
    lr=0.1,
    momentum=0.9,
)

loaded = torch.load(checkpoint_path, map_location="cpu")
restored_model.load_state_dict(loaded["model_state"])
restored_optimizer.load_state_dict(loaded["optimizer_state"])

next_epoch = loaded["epoch"] + 1
print("checkpoint saved:", checkpoint_path.exists())
print("restored epoch:", next_epoch)
print("restored metric keys:", sorted(loaded["metrics"]))
预期输出:
checkpoint saved: True
restored epoch: 1
restored metric keys: ['train_loss', 'val_loss']
state_dict() 只保存参数与状态,不保存 Python 类定义,因此模型构建代码必须仍然存在,并且网络层名称与形状要兼容。保存的 epoch 表示已经完成的轮次,所以续训起点通常是 epoch + 1。
设备与文件策略
map_location="cpu" 可避免检查点在 GPU 环境保存后,因当前机器没有对应 GPU 而加载失败。若要在 GPU 上续训,可把 map_location 设置为目标设备,并让模型参数与优化器状态位于兼容设备。
训练中常同时维护 last.pt 和 best.pt。前者每轮覆盖,用于恢复最近进度;后者只在验证指标变好时更新,用于保留当前最佳模型。生产任务还可先写临时文件,再通过重命名替换正式文件,降低中途退出导致文件损坏的风险。
常见边界
加载外部来源的检查点存在安全风险,只应使用可信文件。模型结构、优化器类型或参数组发生变化时,旧状态可能无法直接加载;这类升级应显式编写兼容逻辑,而不是忽略异常继续训练。
恢复后还应确认数据划分、随机种子和学习率计划是否与原任务一致。检查点只能恢复已保存的状态,不能自动还原未记录的训练环境。