
机器学习与深度学习 / 系统课时
Transformer 编码器
Transformer 编码器
Transformer 编码器把一段序列中的每个位置都转换为融合上下文的信息表示。本课将拆解自注意力、前馈网络、残差连接和层归一化的协作方式,并用 PyTorch 构建可直接接入文本任务的编码器。
学习目标
- 说明 Transformer 编码器层的四个核心组成部分
- 理解张量形状、注意力头数和填充掩码的约束
- 使用
nn.TransformerEncoder完成一次前向计算
编码器解决什么问题
传统循环网络按时间步依次处理序列,后一个位置依赖前一个位置的计算结果。Transformer 编码器改用自注意力,让所有位置在同一层中直接读取其他位置的信息,因此更适合并行计算,也更容易建立长距离依赖。
输入通常是形状为 [batch_size, seq_len, d_model] 的向量序列。编码器不会直接输出类别,而是生成同形状的上下文表示,后续可以继续堆叠、池化或交给分类头。
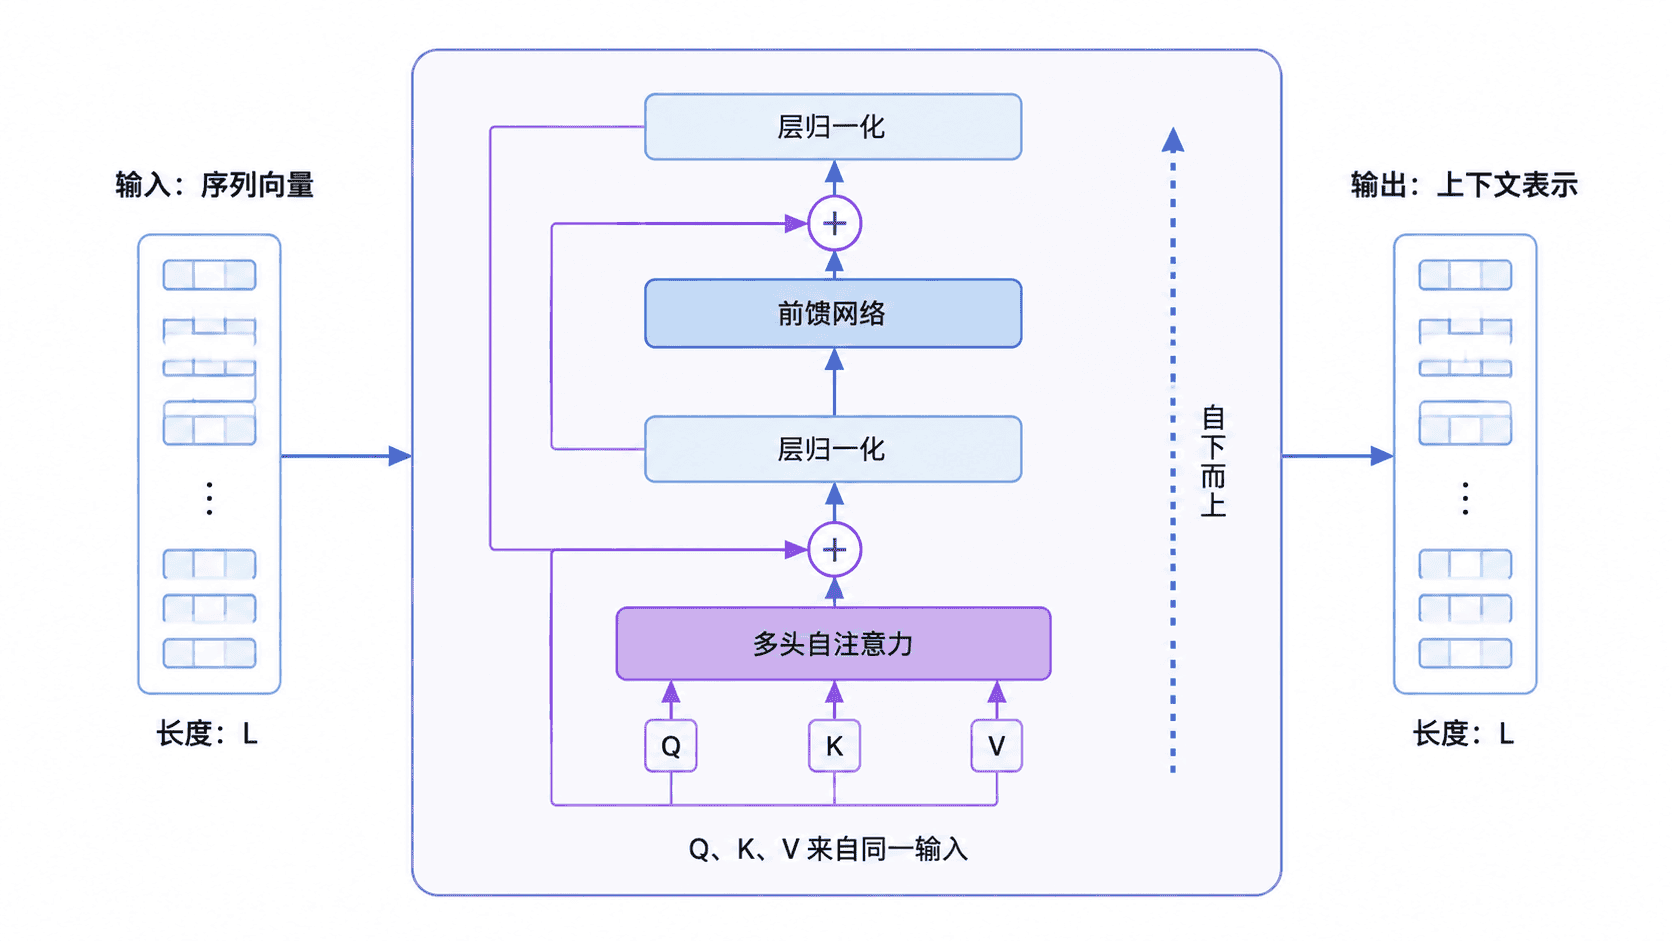
一个编码器层如何工作
多头自注意力
自注意力先把输入映射为查询 Q、键 K 和值 V,再根据查询与键的相似度对值进行加权汇总。单个注意力头的核心计算为:
多头机制会把特征维度分成若干子空间并行计算,使不同头可以关注位置关系、局部搭配或语义关联。由于特征要均匀拆分,d_model 必须能被 nhead 整除。
前馈网络
每个位置经过同一个两层全连接网络,位置之间不在这一步交换信息。常见结构是先升维、应用激活函数,再降回 d_model,从而对注意力得到的特征做非线性变换。
残差连接与层归一化
注意力子层和前馈子层外部都带有残差连接,保证原始信息和梯度能沿短路径传播。层归一化负责稳定每个位置的特征分布,使多层编码器更容易训练。
使用 PyTorch 构建编码器
下面的示例创建两层编码器,并传入一个包含填充位置的批次。src_key_padding_mask 中的 True 表示该位置是填充标记,不应作为其他位置读取的键和值。
python
import torch
from torch import nn

torch.manual_seed(7)

class TextTransformerEncoder(nn.Module):
    def __init__(self) -> None:
        super().__init__()
        encoder_layer = nn.TransformerEncoderLayer(
            d_model=16,
            nhead=4,
            dim_feedforward=32,
            dropout=0.0,
            batch_first=True,
        )
        self.encoder = nn.TransformerEncoder(
            encoder_layer=encoder_layer,
            num_layers=2,
            norm=nn.LayerNorm(16),
            enable_nested_tensor=False,
        )

    def forward(
        self,
        inputs: torch.Tensor,
        padding_mask: torch.Tensor,
    ) -> torch.Tensor:
        # 掩码只阻止注意力读取填充位置,不会改变输出张量的长度。
        return self.encoder(
            inputs,
            src_key_padding_mask=padding_mask,
        )

model = TextTransformerEncoder()
inputs = torch.randn(2, 5, 16)
padding_mask = torch.tensor(
    [
        [False, False, False, False, False],
        [False, False, False, True, True],
    ]
)

outputs = model(inputs, padding_mask)

print("output_shape:", tuple(outputs.shape))
print("mask_shape:", tuple(padding_mask.shape))
print("all_finite:", outputs.isfinite().all().item())
预期输出:
text
output_shape: (2, 5, 16)
mask_shape: (2, 5)
all_finite: True
输出仍保留批次大小、序列长度和特征维度。编码器负责更新每个位置的表示,而是否取首位向量、做平均池化或使用专门的分类标记,应由下游任务决定。
关键边界与常见错误
batch_first=True时输入顺序是[batch, seq, feature];未启用时默认是[seq, batch, feature]。- 填充掩码形状应为
[batch, seq],并使用布尔值;把有效位置标为True会让模型屏蔽真实内容。 - 编码器没有自动加入词嵌入和位置信息。文本任务通常先把词元映射为嵌入,并显式叠加位置编码。
- 对输出直接求平均时必须排除填充位置,否则短文本会被大量零填充稀释。
按自己的节奏,确认真正理解。