
机器学习与深度学习 / 系统课时
批量与并发推理
批量与并发推理
本课解决在线推理中“请求很多但设备吃不满”与“批次变大却延迟升高”的矛盾。你将实现一个带等待窗口、队列上限和单工作线程的动态批处理器,并学会用延迟、吞吐量和资源占用共同验收配置。
学习目标
- 解释请求并发、模型执行并发与批量推理的区别
- 使用队列和时间窗口把多个请求合并为动态批次
- 根据 p95/p99 延迟、吞吐量和队列状态调整并发参数
为什么不能只增加线程
接口可以同时接收很多请求,但模型设备不一定适合被同样数量的线程直接调用。尤其在单张 GPU 上,多个线程争抢同一模型,可能增加上下文切换、显存峰值和尾延迟,却没有形成足够大的矩阵计算。
动态批处理的做法是:请求线程只负责入队,由固定的推理工作线程在短时间窗内收集请求,合并张量后执行一次前向传播,再把结果拆回各自的 Future。这样把“网络并发”与“模型执行”解耦。
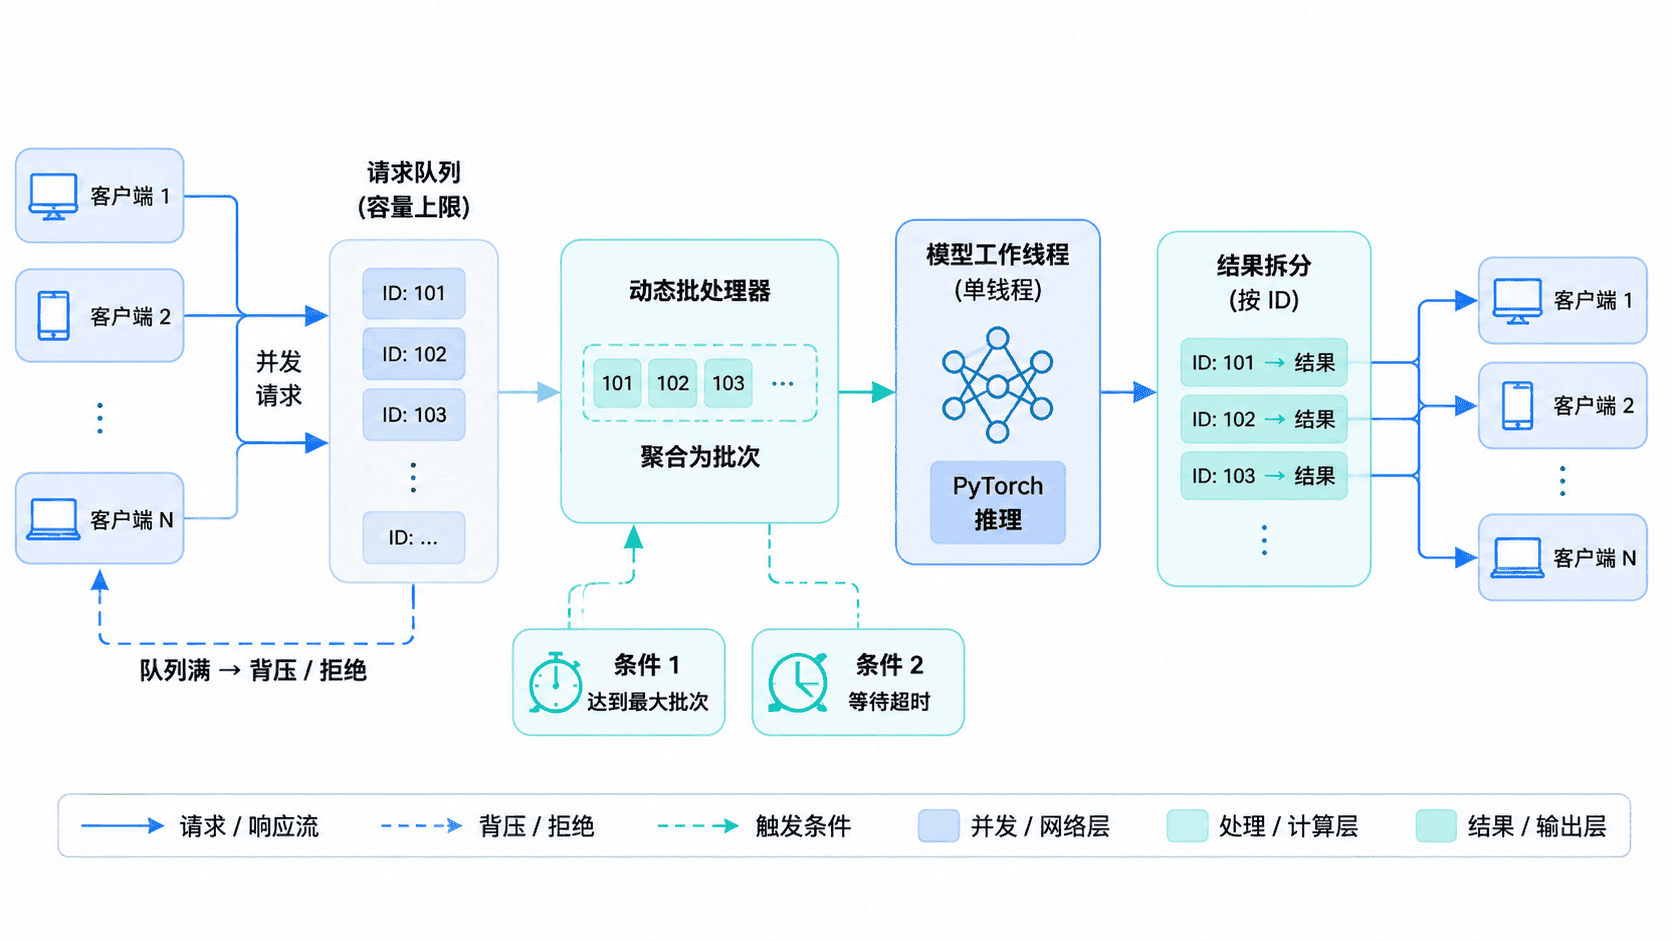
动态批处理的三个参数
max_batch_size 决定一次前向传播最多合并多少个样本。值过小,设备利用率不足;值过大,单次计算和显存占用上升。
max_wait_ms 决定第一个请求最多等待多久来凑批。它直接影响低流量时的额外排队延迟,因此不能只追求满批率。
max_queue_size 是过载保护。队列达到上限后应快速失败、限流或降级,而不是无限堆积,避免请求超时后仍继续消耗计算资源。
调参时必须成对观察批次大小与等待窗口:先确定可接受的延迟目标,再在目标内提高平均批次和吞吐量。
实现动态批处理器
下面示例要求 Python 3.10 及以上并已安装 PyTorch。请求线程并发提交数据,后台线程统一调用模型;示例模型把输入乘以 2,便于验证请求与结果是否正确对应。
import queue
import threading
import time
from concurrent.futures import Future, ThreadPoolExecutor
from dataclasses import dataclass

import torch
from torch import nn

class Doubler(nn.Module):
    def forward(self, x: torch.Tensor) -> torch.Tensor:
        return x * 2

@dataclass
class Request:
    tensor: torch.Tensor
    future: Future

class DynamicBatcher:
    def __init__(
        self,
        model: nn.Module,
        max_batch_size: int = 4,
        max_wait_ms: int = 20,
        max_queue_size: int = 16,
    ) -> None:
        self.model = model.eval()
        self.max_batch_size = max_batch_size
        self.max_wait_seconds = max_wait_ms / 1000
        self.requests: queue.Queue[Request | None] = queue.Queue(max_queue_size)
        self.worker = threading.Thread(target=self._run, daemon=True)
        self.worker.start()

    def submit(self, tensor: torch.Tensor) -> Future:
        future: Future = Future()
        request = Request(tensor=tensor, future=future)
        try:
            # 队列满时快速失败,避免无界排队拖垮服务。
            self.requests.put(request, timeout=0.1)
        except queue.Full as exc:
            raise RuntimeError("推理队列已满,请稍后重试") from exc
        return future

    def _run(self) -> None:
        while True:
            first = self.requests.get()
            if first is None:
                return

            batch = [first]
            deadline = time.perf_counter() + self.max_wait_seconds

            # 满批或等待窗口结束后立即执行,不固定等待完整时长。
            while len(batch) < self.max_batch_size:
                remaining = deadline - time.perf_counter()
                if remaining <= 0:
                    break
                try:
                    item = self.requests.get(timeout=remaining)
                except queue.Empty:
                    break
                if item is None:
                    self.requests.put(None)
                    break
                batch.append(item)

            inputs = torch.stack([item.tensor for item in batch])
            with torch.inference_mode():
                outputs = self.model(inputs)

            # 按批内顺序把输出写回对应请求。
            for item, output in zip(batch, outputs):
                item.future.set_result(output)

    def close(self) -> None:
        self.requests.put(None)
        self.worker.join()

def main() -> None:
    service = DynamicBatcher(Doubler(), max_batch_size=4, max_wait_ms=20)

    with ThreadPoolExecutor(max_workers=8) as pool:
        submit_tasks = [
            pool.submit(service.submit, torch.tensor([float(i)]))
            for i in range(8)
        ]
        inference_futures = [task.result() for task in submit_tasks]
        results = [
            (request_id, future.result().item())
            for request_id, future in enumerate(inference_futures)
        ]

    service.close()

    for request_id, value in results:
        print(f"request {request_id} -> {value:.1f}")

if __name__ == "__main__":
    main()
预期输出
request 0 -> 0.0
request 1 -> 2.0
request 2 -> 4.0
request 3 -> 6.0
request 4 -> 8.0
request 5 -> 10.0
request 6 -> 12.0
request 7 -> 14.0
model.eval() 切换推理行为,torch.inference_mode() 关闭该工作线程中的梯度记录。请求线程只操作队列和 Future,因此模型前向传播始终由一个位置统一控制;实际部署到 GPU 时,还要把批量输入移动到同一设备。
用指标决定是否扩容
不要只看平均延迟。平均值可能掩盖队列拥塞,至少应同时记录 p50、p95、p99 延迟、每秒请求数、平均批次大小、队列等待时间、队列拒绝数以及 CPU、GPU 和显存占用。
| 现象 | 常见原因 | 优先调整 |
|---|---|---|
| GPU 利用率低且队列短 | 批次太小或请求稀疏 | 适度增大等待窗口或合并相近尺寸请求 |
| p99 很高且队列持续增长 | 到达速率超过处理能力 | 限流、增加实例或降低单次计算成本 |
| 吞吐量上升但显存溢出 | 最大批次过大 | 减小批次并检查输入尺寸 |
| 队列经常满但设备不忙 | 前后处理或数据搬运阻塞 | 分离预处理、使用固定形状或并行 I/O |
生产压测应逐级增加并发,找到延迟目标首次被突破的位置。达到上限后,优先扩展独立模型实例,而不是让单实例继续无限排队。