
机器学习与深度学习 / 系统课时
神经网络的基本结构
神经网络的基本结构
神经网络把输入经过若干层计算转换为输出。理解层、权重、偏置和激活函数之间的关系后,你就能读懂最小 PyTorch 模型,并知道一次前向传播实际做了什么。
学习目标
- 说明输入层、隐藏层和输出层各自承担的职责
- 理解权重、偏置与激活函数在单层计算中的作用
- 使用 PyTorch 构建并验证一个可运行的前馈神经网络
三类层如何协作
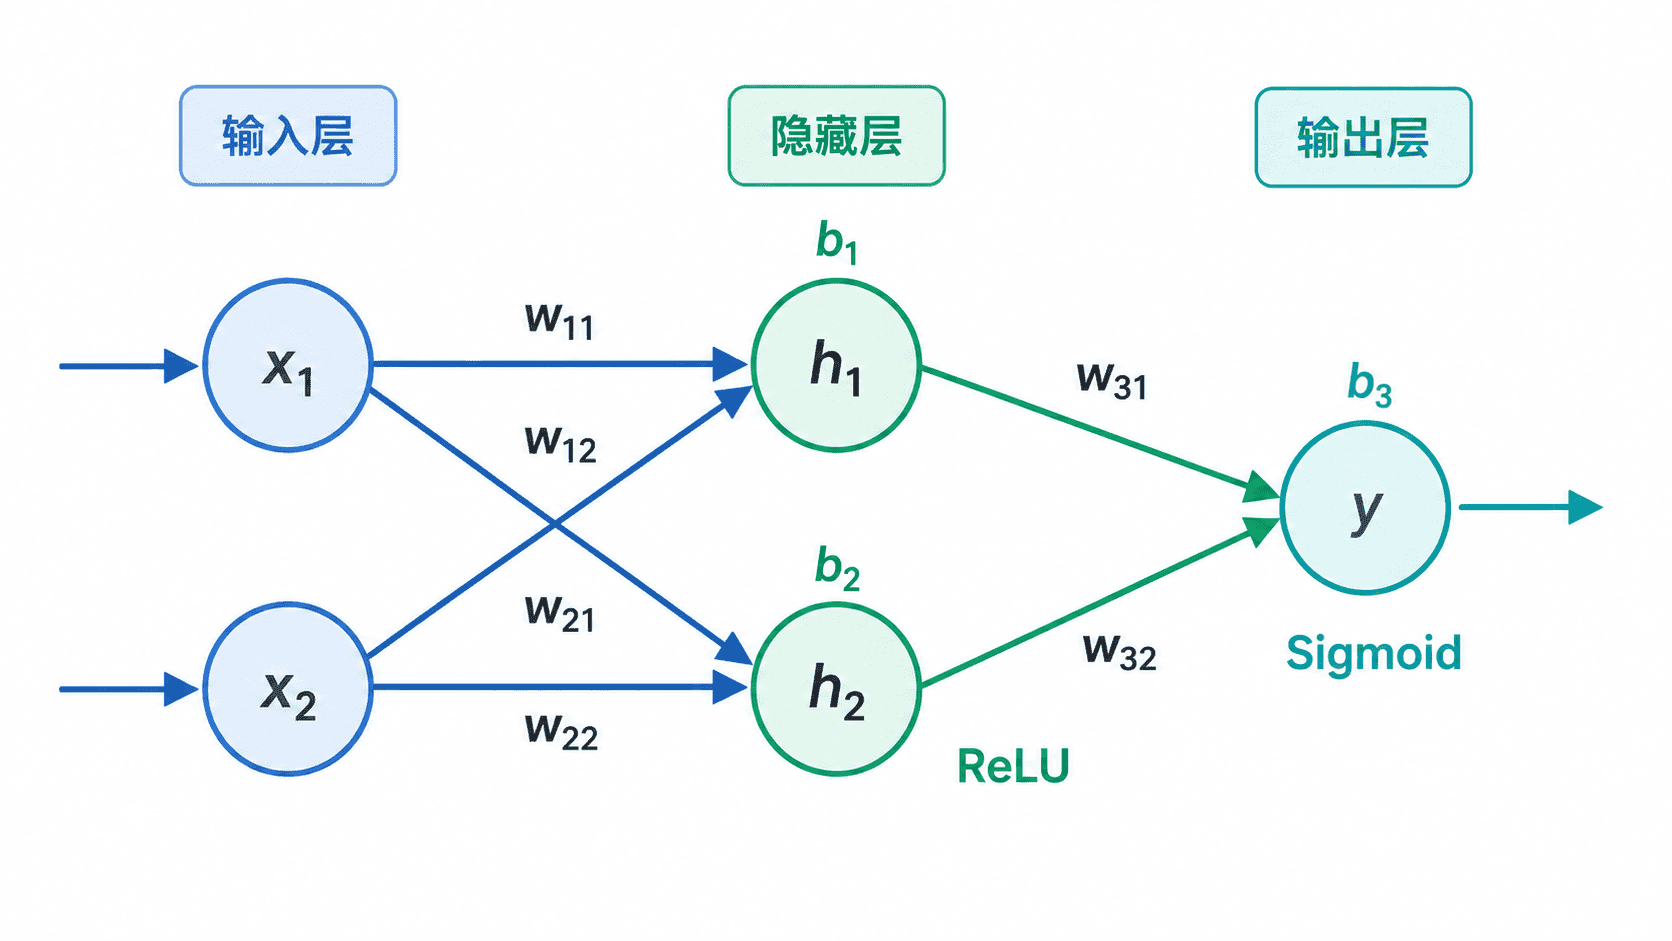
输入层接收样本特征,本身通常不负责可训练变换;隐藏层逐级组合特征,形成更适合当前任务的表示;输出层把最终表示转换为类别分数、概率或连续数值。
一个网络可以没有隐藏层,但那通常只能表达线性关系。加入隐藏层和非线性激活函数后,网络才能组合出更复杂的决策边界。
单层计算的本质
一层神经网络先对输入做加权求和并加上偏置,再通过激活函数得到输出。可以写成:
z = Wx + b
$$。
a = f(z) $$
其中, 是输入, 是权重矩阵, 是偏置, 是激活函数。训练过程会不断调整 和 ;激活函数负责引入非线性,否则多层线性变换仍然等价于一层线性变换。
用 PyTorch 完成一次前向传播
下面的示例使用两个输入、两个隐藏节点和一个输出节点。为了让结果稳定可核对,代码手动设置权重与偏置,而不是使用随机初始化。运行前需已安装 PyTorch。
python
import torch
from torch import nn

class TinyNetwork(nn.Module):
    def __init__(self) -> None:
        super().__init__()
        self.hidden = nn.Linear(2, 2)
        self.output = nn.Linear(2, 1)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        # 隐藏层使用 ReLU,引入非线性表达能力
        hidden_value = torch.relu(self.hidden(x))
        return torch.sigmoid(self.output(hidden_value))

model = TinyNetwork()

with torch.no_grad():
    # 固定参数,便于复现并核对每一层的计算结果
    model.hidden.weight.copy_(torch.tensor([[0.5, -0.5], [1.0, 0.25]]))
    model.hidden.bias.copy_(torch.tensor([0.1, -0.2]))
    model.output.weight.copy_(torch.tensor([[0.8, -0.4]]))
    model.output.bias.copy_(torch.tensor([0.3]))

sample = torch.tensor([[1.0, 2.0]])
hidden = torch.relu(model.hidden(sample))
prediction = model(sample)

print("hidden:", [round(value, 4) for value in hidden[0].tolist()])
print("output:", [round(value, 4) for value in prediction[0].tolist()])
预期输出:
text
hidden: [0.0, 1.3]
output: [0.4452]
第一个隐藏节点的加权结果为负数,因此经过 ReLU 后变为 0;第二个隐藏节点保留 1.3。输出层再对隐藏表示做线性变换,并通过 Sigmoid 将结果压缩到 0 和 1 之间。
结构中的关键边界
层数多不等于效果一定更好。隐藏层过少可能无法表达复杂关系,过多则会增加训练难度、推理延迟和过拟合风险。实际设计应从满足任务的最小结构开始,再根据验证集表现调整。
输出层的节点数和激活函数取决于任务。二分类常使用一个输出节点配合 Sigmoid;多分类通常使用多个输出节点,并在训练时结合适合的损失函数;回归任务常直接输出连续值。
常见错误:把激活函数当作可有可无的装饰。若隐藏层之间没有非线性激活,多层网络会退化为一次线性变换,无法获得预期的表达能力。
按自己的节奏,确认真正理解。