
机器学习与深度学习 / 系统课时
激活函数
激活函数
激活函数决定神经网络能否表达非线性关系,也会影响梯度传播和输出含义。本课将比较 ReLU、Sigmoid、Tanh 与 GELU,并通过 PyTorch 示例建立可直接使用的选择规则。
学习目标
- 理解激活函数在网络层之间的作用
- 比较四种常用激活函数的输出特征
- 根据隐藏层、输出层和模型结构选择函数
激活函数解决什么问题
线性层完成的是 。如果多层线性变换之间没有激活函数,无论叠加多少层,最终仍可合并成一次线性变换,模型无法表示弯曲的分类边界或复杂特征。
加入 后,网络获得非线性表达能力。激活函数还会改变输出范围和梯度大小,因此不能只看“是否可用”,还要看它放在隐藏层、输出层还是特定架构中。
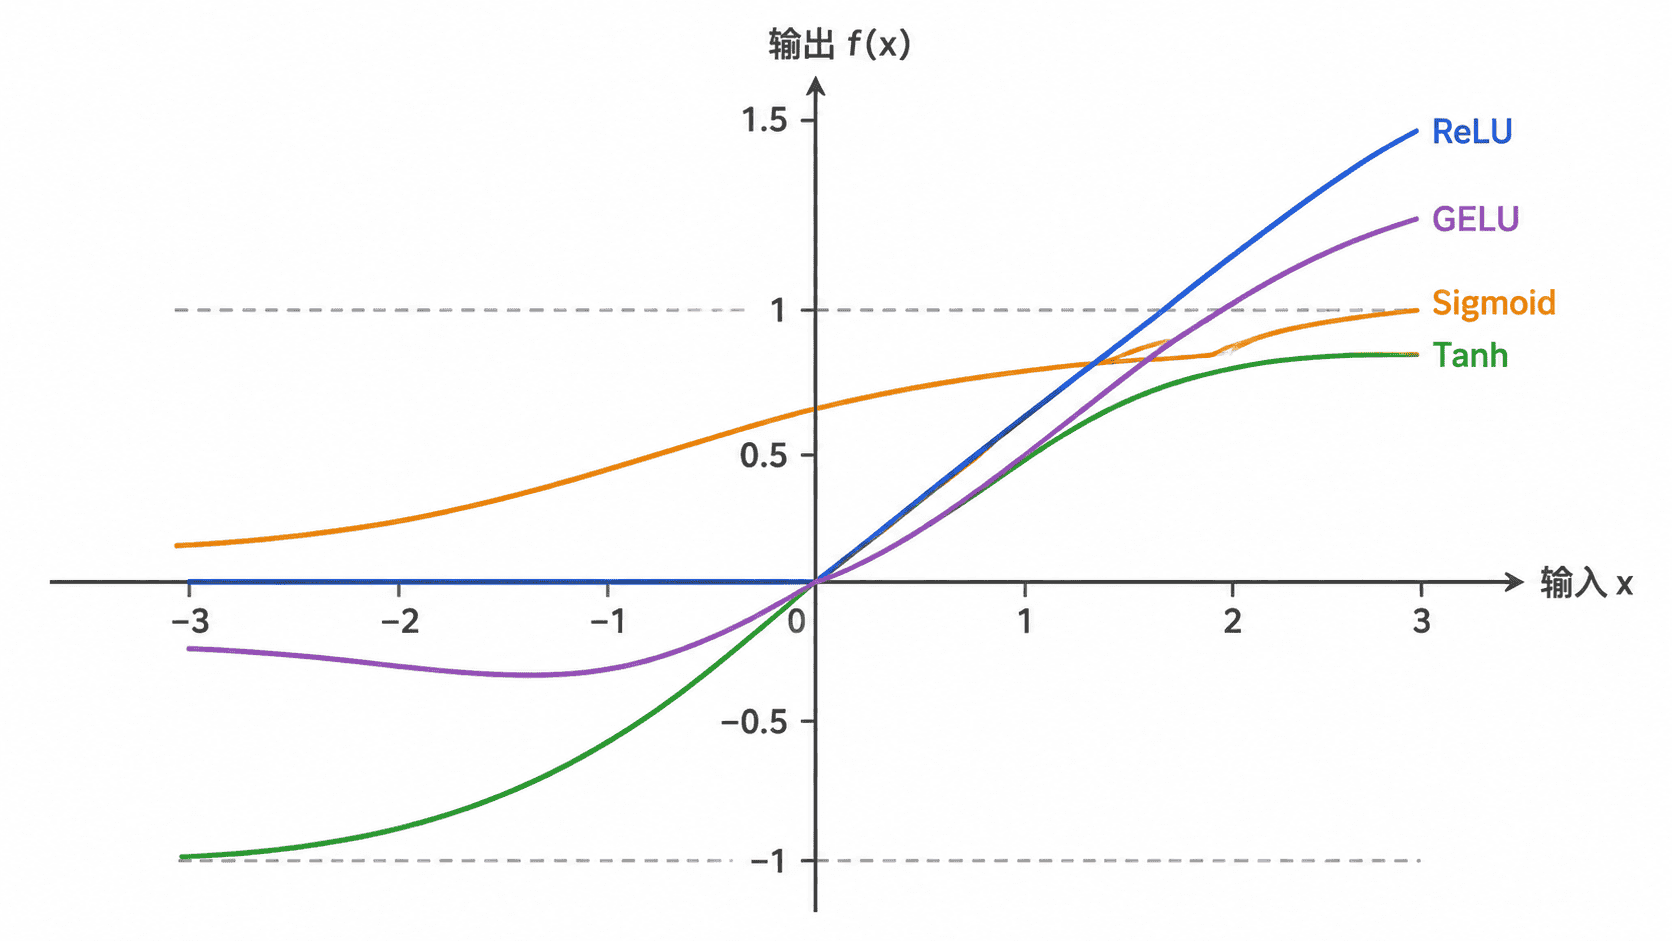
四种函数如何比较
| 函数 | 输出特征 | 优点 | 常见位置 |
|---|---|---|---|
| ReLU | 负数变为 0,正数保持不变 | 计算简单,正区间梯度稳定 | CNN、MLP 的隐藏层 |
| Sigmoid | 输出位于 0 到 1 | 适合表达二元概率或门控比例 | 二分类推理输出、门控结构 |
| Tanh | 输出位于 -1 到 1 | 以 0 为中心,正负响应对称 | 部分循环网络和小型模型 |
| GELU | 按输入大小平滑缩放 | 连续平滑,对小负值不过早截断 | Transformer、现代 MLP |
ReLU 通常是普通隐藏层的起点。Sigmoid 和 Tanh 在绝对值较大时容易进入饱和区,梯度会变小;GELU 比 ReLU 更平滑,但计算成本也略高。
用 PyTorch 观察输出
下面对同一组输入应用四种激活函数。示例固定输入,因此输出可直接核对。
python
import torch
from torch import nn

def rounded(values: torch.Tensor) -> list[float]:
    # 统一保留四位小数,便于比较不同函数的响应
    return [float(f"{value:.4f}") for value in values.tolist()]

def main() -> None:
    x = torch.tensor([-2.0, -1.0, 0.0, 1.0, 2.0])
    activations = {
        "ReLU": nn.ReLU(),
        "Sigmoid": nn.Sigmoid(),
        "Tanh": nn.Tanh(),
        "GELU": nn.GELU(),
    }

    for name, activation in activations.items():
        print(f"{name}: {rounded(activation(x))}")

if __name__ == "__main__":
    main()
预期输出
text
ReLU: [0.0, 0.0, 0.0, 1.0, 2.0]
Sigmoid: [0.1192, 0.2689, 0.5, 0.7311, 0.8808]
Tanh: [-0.964, -0.7616, 0.0, 0.7616, 0.964]
GELU: [-0.0455, -0.1587, 0.0, 0.8413, 1.9545]
结果显示,ReLU 会完全截断负值;Sigmoid 和 Tanh 会压缩较大输入;GELU 则保留少量负响应,并对正值进行平滑缩放。
选择位置与损失函数
隐藏层没有特殊要求时,可先选 ReLU;Transformer 风格的前馈网络通常选 GELU。若 ReLU 出现大量神经元长期输出 0,可再评估 LeakyReLU 等变体,而不是盲目更换整套结构。
输出层必须与损失函数配套。使用 BCEWithLogitsLoss 时,模型应直接输出 logits,不要在训练图中额外添加 Sigmoid;使用 CrossEntropyLoss 时同样直接输出 logits,不要提前做 Softmax。需要展示概率时,再在推理阶段转换。
nn.ReLU(inplace=True) 会原地改写张量,可能与残差连接或自动求导所需的中间值冲突。初学和调试阶段优先保留默认的 inplace=False。
按自己的节奏,确认真正理解。