
机器学习与深度学习 / 系统课时
排查数据加载瓶颈
排查数据加载瓶颈
训练时 GPU 利用率低、每个批次间隔明显或吞吐量不稳定,问题不一定在模型。本课将把数据路径拆成读取、预处理、进程间供给和主机到设备传输四段,并通过计时基准定位真正的等待点。
学习目标
- 区分数据等待、传输和模型计算耗时
- 评估
num_workers、pin_memory与预取配置 - 按证据修复磁盘、CPU 或传输瓶颈
先确认等待发生在哪里
排查的第一步不是直接增大 num_workers,而是测量一个训练步骤中各阶段的时间。若获取下一个批次耗时高,重点检查存储读取、解码和预处理;若主机到设备传输耗时高,再检查页锁定内存、批次大小和异步复制。
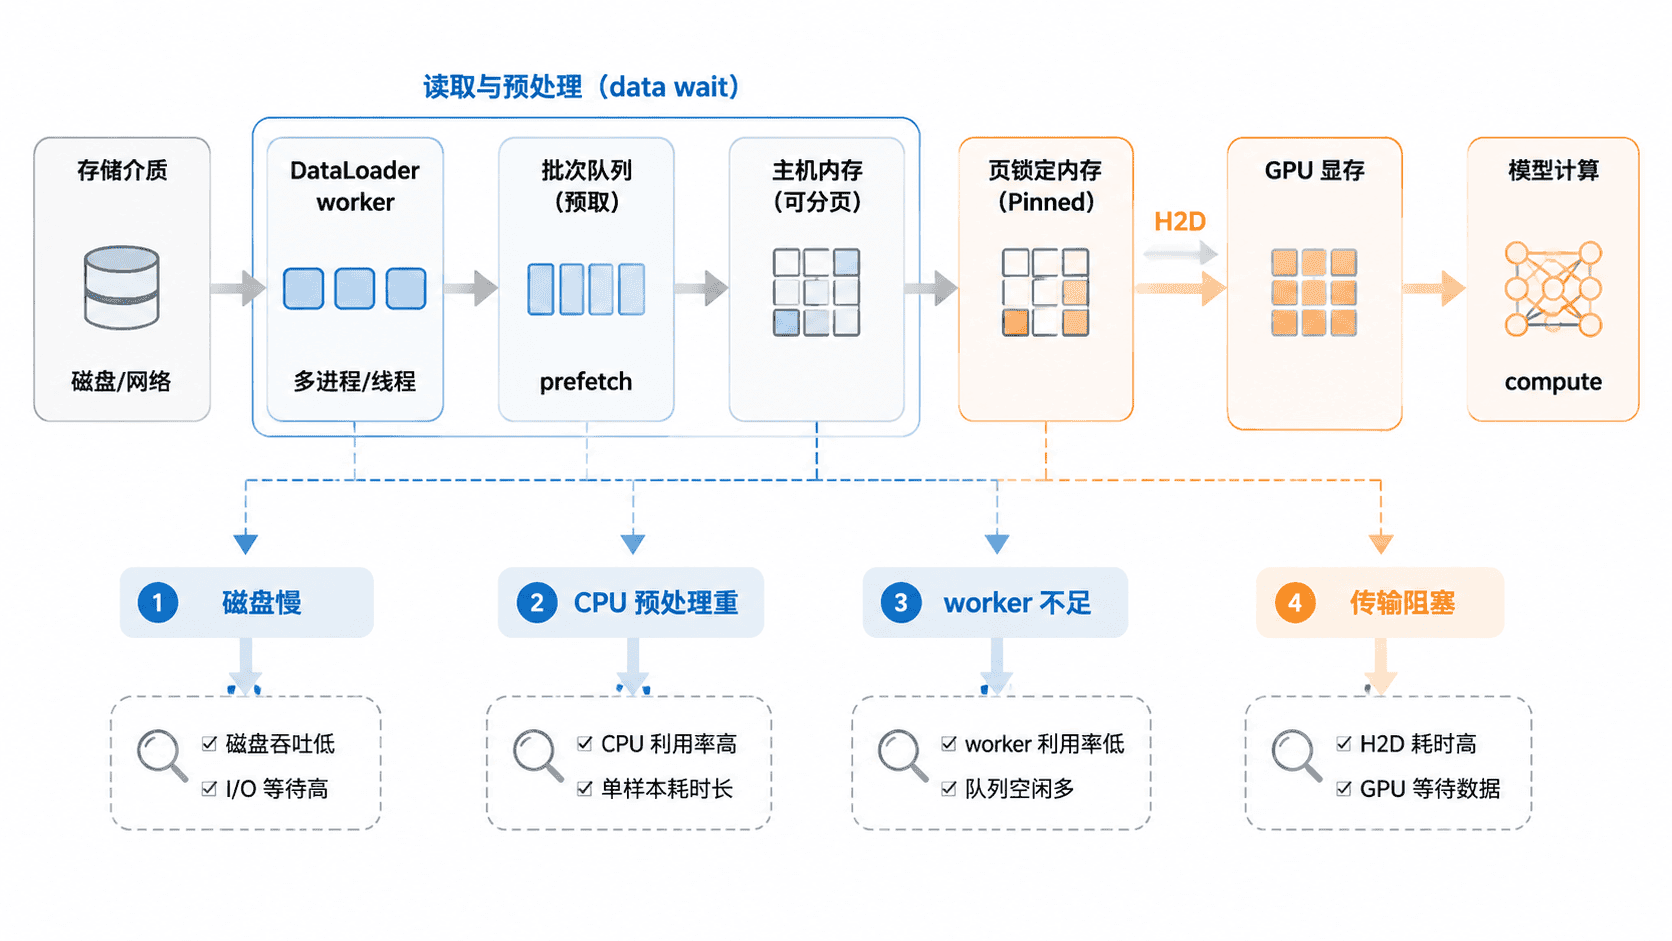
单看总迭代时间容易误判,因为数据加载器可能在后台预取。应先预热若干批次,再连续记录多个批次的平均值,同时固定批量大小、数据范围和模型状态,确保不同配置可以比较。
建立可重复的计时基准
下面的完整脚本分别测试单进程和双进程加载,并记录数据等待、主机到设备传输、计算耗时与吞吐量。示例数据集用短暂停顿模拟读取延迟,实际项目中应替换为真实数据集。
import time

import torch
from torch.utils.data import DataLoader, Dataset

class SlowDataset(Dataset):
    def __init__(self, size=4096, feature_size=256):
        self.data = torch.randn(size, feature_size)

    def __len__(self):
        return len(self.data)

    def __getitem__(self, index):
        time.sleep(0.002)  # 模拟磁盘读取或解码等待
        return torch.sin(self.data[index])

def build_loader(dataset, num_workers, pin_memory):
    options = {
        "dataset": dataset,
        "batch_size": 64,
        "shuffle": False,
        "num_workers": num_workers,
        "pin_memory": pin_memory,
    }

    # 只有多进程加载时才能启用持久 worker 和预取。
    if num_workers > 0:
        options["persistent_workers"] = True
        options["prefetch_factor"] = 2

    return DataLoader(**options)

def benchmark(loader, device, warmup_steps=3, measure_steps=20):
    iterator = iter(loader)

    for _ in range(warmup_steps):
        next(iterator)

    data_wait = 0.0
    transfer = 0.0
    compute = 0.0
    sample_count = 0

    for _ in range(measure_steps):
        start = time.perf_counter()
        batch = next(iterator)
        after_load = time.perf_counter()

        batch = batch.to(
            device,
            non_blocking=device.type == "cuda" and loader.pin_memory,
        )
        if device.type == "cuda":
            torch.cuda.synchronize()
        after_transfer = time.perf_counter()

        result = (batch * batch).mean()
        if device.type == "cuda":
            torch.cuda.synchronize()
        after_compute = time.perf_counter()

        data_wait += after_load - start
        transfer += after_transfer - after_load
        compute += after_compute - after_transfer
        sample_count += batch.size(0)

    total = data_wait + transfer + compute
    return {
        "data_wait_ms": data_wait * 1000 / measure_steps,
        "h2d_ms": transfer * 1000 / measure_steps,
        "compute_ms": compute * 1000 / measure_steps,
        "samples_per_sec": sample_count / total,
        "last_result": result.item(),
    }

def main():
    dataset = SlowDataset()
    device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
    configurations = [(0, False), (2, False)]

    if device.type == "cuda":
        configurations.append((2, True))

    print(f"device={device.type}")
    for workers, pin_memory in configurations:
        loader = build_loader(dataset, workers, pin_memory)
        metrics = benchmark(loader, device)
        print(
            f"workers={workers}, pin_memory={pin_memory}, "
            f"data_wait_ms={metrics['data_wait_ms']:.2f}, "
            f"h2d_ms={metrics['h2d_ms']:.2f}, "
            f"compute_ms={metrics['compute_ms']:.2f}, "
            f"samples_per_sec={metrics['samples_per_sec']:.1f}"
        )

if __name__ == "__main__":
    main()
预期输出
device=<cpu 或 cuda>
workers=0, pin_memory=False, data_wait_ms=<TIME_MS>, h2d_ms=<TIME_MS>, compute_ms=<TIME_MS>, samples_per_sec=<SAMPLES_PER_SECOND>
workers=2, pin_memory=False, data_wait_ms=<TIME_MS>, h2d_ms=<TIME_MS>, compute_ms=<TIME_MS>, samples_per_sec=<SAMPLES_PER_SECOND>
workers=2, pin_memory=True, data_wait_ms=<TIME_MS>, h2d_ms=<TIME_MS>, compute_ms=<TIME_MS>, samples_per_sec=<SAMPLES_PER_SECOND>
最后一行只会在检测到 CUDA 时出现。具体时间和吞吐量取决于 CPU、存储、PyTorch 版本及系统负载;判断依据是同一环境下不同配置的相对变化,而不是示例数值。
根据指标定位根因
若 data_wait_ms 很高且增加 worker 后明显下降,说明单进程供给不足。若增加到某个数量后不再改善,甚至变慢,通常是 CPU 争用、进程通信开销或存储带宽已经饱和。
若读取少量大文件明显快于读取大量小文件,瓶颈多半来自文件系统元数据和随机访问。可考虑合并样本、建立索引、使用顺序读取格式或把热点数据放到更快的本地存储,但应先用真实数据验证收益。
若预处理占满 CPU,应减少 Python 层循环,把可批量化的操作交给张量库,或提前缓存稳定结果。随机增强不能盲目离线化,否则会降低样本多样性。
调整进程与传输配置
num_workers 没有通用最优值,应从 0、2、4 等小范围逐步测试。多进程启动和进程间复制也有成本,数据很小或预处理很轻时,num_workers=0 可能更快、更容易调试。
CUDA 训练可组合使用 pin_memory=True 与 .to(device, non_blocking=True),让主机到设备复制具备异步执行条件。只有页锁定内存、异步参数和后续计算能够重叠时,才可能看到实际收益;单独开启某个参数并不保证加速。
persistent_workers=True 可避免每轮重新创建 worker,适合多轮训练,但会让 worker 常驻并占用资源。prefetch_factor 增大会提高预取批次数,也会增加主机内存占用,调整后必须同时观察吞吐量和内存峰值。
修复后的验证方式
修复后应在相同数据、批量大小和测量步数下重新运行基准,并至少比较平均吞吐量、数据等待时间和资源利用率。只看 GPU 利用率峰值不足以证明问题解决,因为短暂满载仍可能伴随长时间空等。
生产训练还应连续观察多个 epoch。若首个 epoch 慢、后续明显变快,可能受操作系统文件缓存影响;若耗时周期性抖动,则继续检查垃圾回收、共享存储竞争、数据分片不均和后台任务。