
机器学习与深度学习 / 系统课时
批量大小与学习率
批量大小与学习率
本课解决训练配置中最常见的一组联动问题:批量大小改变后,学习率是否也要调整。你将理解二者对显存、参数更新频率、梯度噪声和泛化的影响,并能在 PyTorch 中配置微批量与梯度累积。
学习目标
- 解释批量大小对显存占用、更新次数和梯度稳定性的影响
- 理解学习率过大或过小时的典型训练现象
- 使用线性缩放作为起点,并通过验证集确定最终配置
批量大小改变了什么
批量大小是一次前向传播和反向传播使用的样本数。批量越大,单次计算通常更能利用并行硬件,但激活值和梯度占用的显存也越多;在数据量固定时,每个 epoch 的参数更新次数会减少。
较小批量带来更明显的梯度波动,这种噪声有时有助于跳出狭窄的局部区域并改善泛化,但训练吞吐可能较低。较大批量的梯度更稳定,吞吐通常更高,却可能需要学习率预热、更多数据或更细致的正则化。
学习率决定更新幅度
学习率控制每次参数更新的步长。学习率过小,损失下降缓慢,有限训练时间内可能表现为欠拟合;学习率过大,损失会震荡、突然升高,甚至出现 nan。
判断学习率不能只看训练损失。训练下降很快但验证指标变差,可能说明更新过激或正则不足;训练和验证都几乎不动,则应检查学习率、梯度是否存在以及输入尺度是否合理。
两者需要联动调整
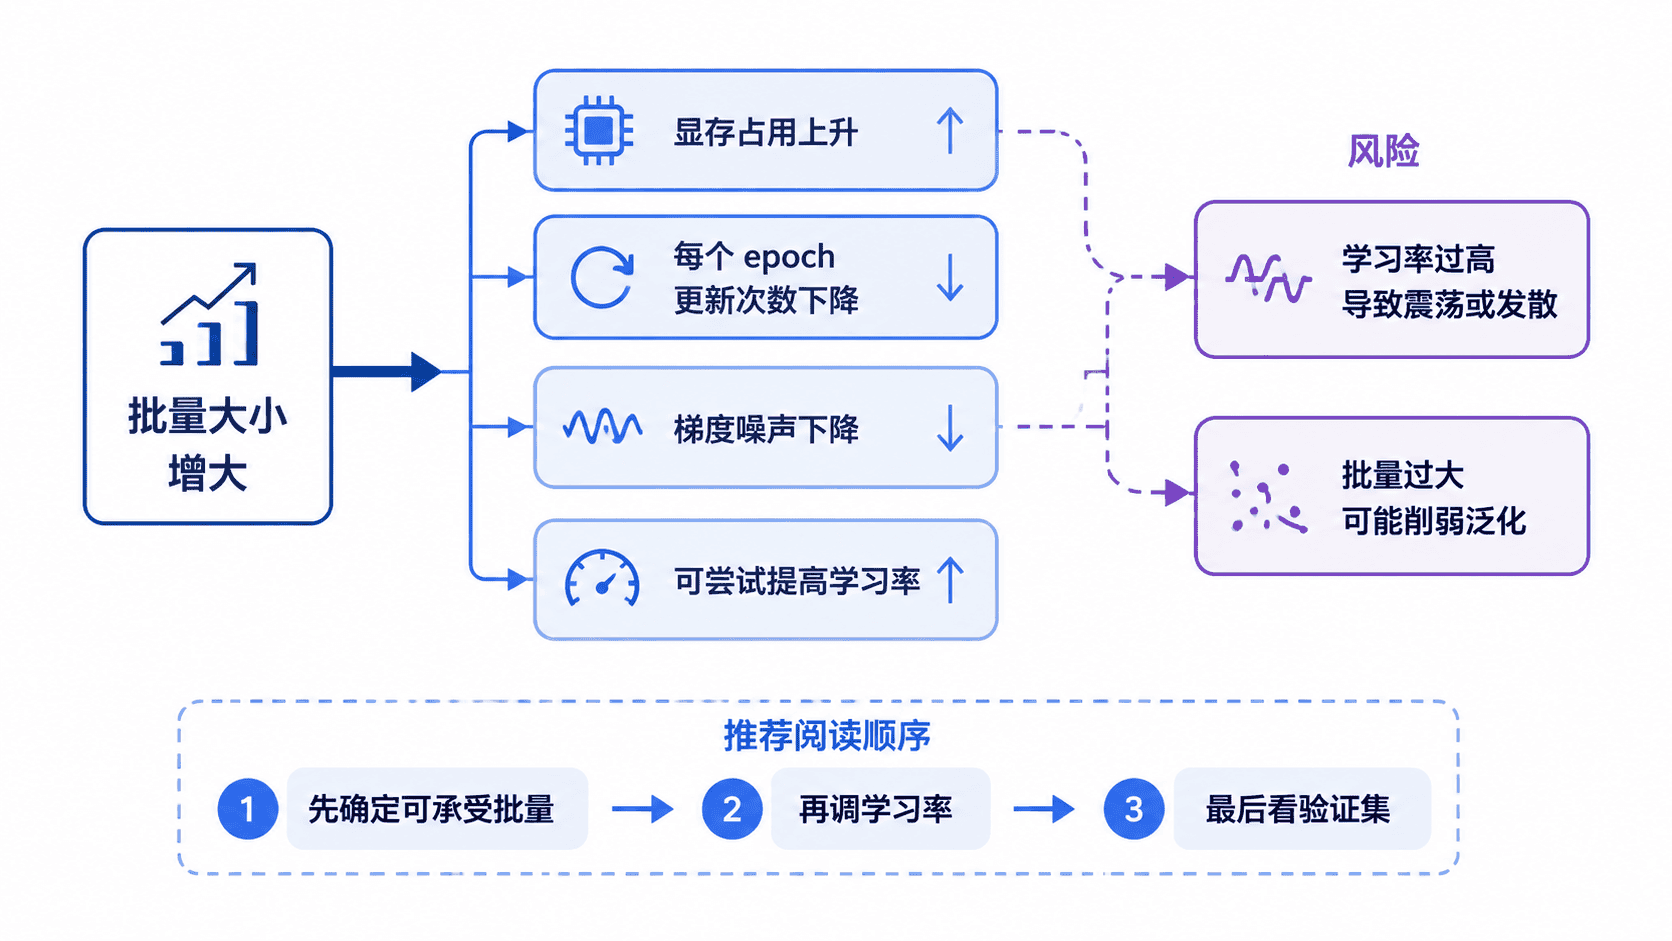
一种常见起点是线性缩放:批量放大为原来的 倍时,先尝试把学习率也放大为 倍。例如批量从 32 增加到 128,可先把学习率从 0.001 调整到 0.004。
这只是起始假设,不是固定定律。优化器类型、归一化层、数据规模和任务难度都会改变合适范围。批量很大时通常还要使用学习率预热,避免训练初期参数更新过猛。
在 PyTorch 中配置有效批量
显存无法容纳目标批量时,可以使用梯度累积。下面的完整示例用微批量 32 累积 4 次,得到有效批量 128,并按线性规则设置 SGD 学习率。
import torch
from torch import nn
from torch.utils.data import DataLoader, TensorDataset

def main() -> None:
    dataset_size = 10_000
    feature_count = 20
    micro_batch_size = 32
    target_effective_batch = 128
    base_batch_size = 32
    base_learning_rate = 0.001

    # 有效批量等于微批量乘以梯度累积次数
    accumulation_steps = target_effective_batch // micro_batch_size
    learning_rate = base_learning_rate * (
        target_effective_batch / base_batch_size
    )

    features = torch.zeros(dataset_size, feature_count)
    targets = torch.zeros(dataset_size, 1)
    loader = DataLoader(
        TensorDataset(features, targets),
        batch_size=micro_batch_size,
        shuffle=False,
    )

    model = nn.Linear(feature_count, 1)
    optimizer = torch.optim.SGD(model.parameters(), lr=learning_rate)

    print(f"micro batch size: {micro_batch_size}")
    print(f"gradient accumulation steps: {accumulation_steps}")
    print(f"effective batch size: {micro_batch_size * accumulation_steps}")
    print(f"learning rate: {learning_rate:.6f}")
    print(f"batches per epoch: {len(loader)}")
    print(f"optimizer lr: {optimizer.param_groups[0]['lr']:.6f}")

if __name__ == "__main__":
    main()
预期输出:
micro batch size: 32
gradient accumulation steps: 4
effective batch size: 128
learning rate: 0.004000
batches per epoch: 313
optimizer lr: 0.004000
真正训练时,应将每个微批量的损失除以 accumulation_steps 后再调用 backward(),累计到指定次数再执行 optimizer.step() 和 optimizer.zero_grad()。否则梯度总量会被放大,实际更新幅度与预期不一致。
推荐的调参顺序
先选择不会触发显存不足、吞吐表现合理的批量大小,再在固定批量下搜索学习率。比较实验时应尽量保持总参数更新次数一致,而不是只保持 epoch 数一致,因为批量变化会改变每轮更新次数。
可以先用较稀疏的学习率范围试验,例如按 3 倍或 10 倍变化找到可用区间,再在最佳区间内细调。最终选择依据应是验证集主指标、训练稳定性和实际吞吐,而不是只看每秒处理样本数。
常见配置错误
批量增大后直接沿用原学习率,可能导致收敛速度明显变慢;机械地按比例放大学习率,又可能造成训练初期发散。线性缩放后仍需观察前几个 epoch,并在必要时加入预热。
批量很小时,BatchNorm 的统计量可能不稳定。此时可以增加梯度累积获得更大的有效批量,但要注意梯度累积不会扩大 BatchNorm 单次看到的样本数,因此它不能完全等价于真实大批量。