
机器学习与深度学习 / 系统课时
模型量化基础
模型量化基础
本课解决模型部署中“体积太大、内存不足或推理太慢”的问题。你将理解浮点数映射到低位整数的过程,完成一次可运行的 INT8 量化实验,并建立量化前后必须同时检查精度、体积和目标硬件性能的验收方法。
学习目标
- 说明量化参数、整数编码与反量化误差的关系
- 区分仅量化权重、动态量化、静态量化与量化感知训练
- 使用 PyTorch 张量完成 INT8 量化并计算体积与误差
量化改变了什么
训练模型通常使用 FP32、BF16 或 FP16 保存权重和激活。量化通过比例因子 scale 和可选零点 zero_point,把连续浮点值映射到有限的整数格点。推理时可以直接使用低精度算子,也可以先反量化为近似浮点值参与计算。
对称 INT8 量化常用的核心关系是:先计算 scale = max(abs(x)) / 127,再执行 q = clamp(round(x / scale), -127, 127);恢复值为 x_hat = q * scale。舍入和截断使 x_hat 不会与原值完全相同,这就是量化误差。
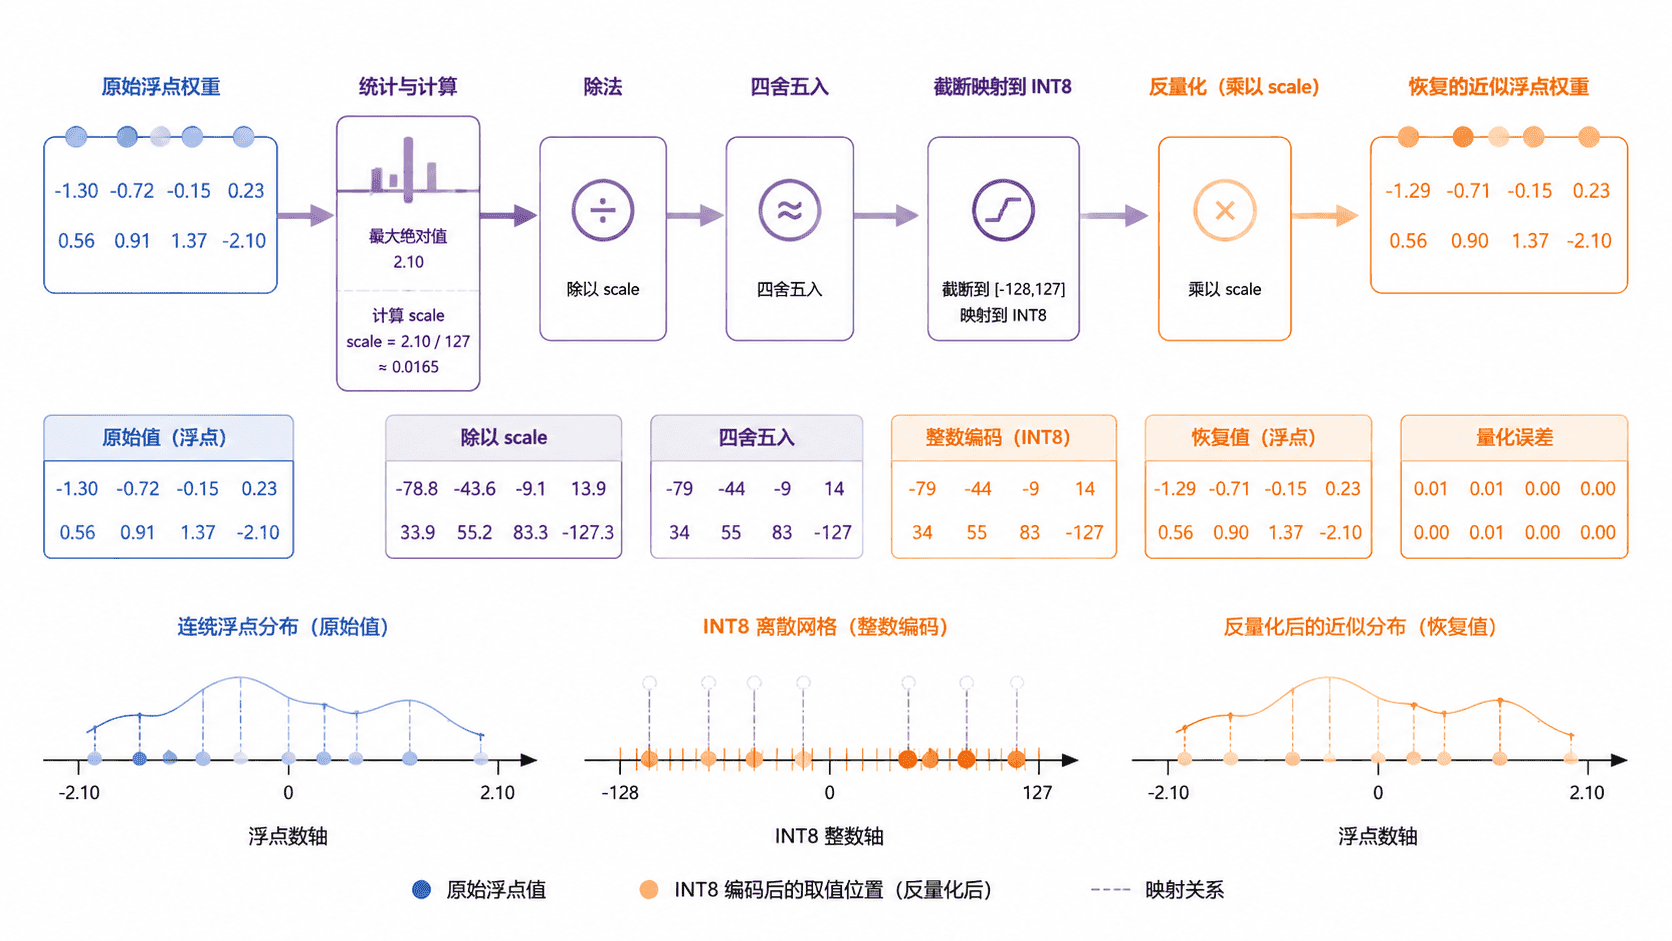
精度、体积与速度的权衡
位宽降低后,权重数据理论上更小,但实际模型还要保存比例因子、零点、分组信息和运行时元数据,因此文件大小不会总是严格按位宽比例缩小。
| 表示方式 | 每个数的位宽 | 权重载荷理论比例 | 主要特点 |
|---|---|---|---|
| FP32 | 32 位 | 1 | 精度基线,体积最大 |
| BF16 / FP16 | 16 位 | 1/2 | 常用于混合精度和 GPU 推理 |
| INT8 | 8 位 | 1/4 | 体积与精度较均衡,依赖低精度算子 |
| INT4 | 4 位 | 1/8 | 压缩更强,对分组方式和硬件支持更敏感 |
仅权重量化只压缩权重,激活仍保持较高精度;动态量化在运行时根据输入计算激活量化参数;静态量化通过校准数据预先确定范围;量化感知训练在训练或微调阶段模拟量化误差,通常用于控制更明显的精度下降。
量化不保证自动加速。只有目标设备、算子形状和推理运行时真正提供对应低精度内核时,减少的数据搬运与计算量才可能转化为更低延迟。
手写一次 INT8 量化
下面示例不依赖额外量化库,只使用 PyTorch 在 CPU 上演示对称逐张量量化。它适合验证数学过程,不等同于生产运行时的打包格式或低精度算子。
import torch

def symmetric_int8_quantize(
    tensor: torch.Tensor,
) -> tuple[torch.Tensor, torch.Tensor, torch.Tensor]:
    max_abs = tensor.abs().max()
    if max_abs == 0:
        scale = torch.tensor(1.0, dtype=torch.float32)
    else:
        scale = max_abs / 127

    # INT8 对称范围使用 -127 到 127,避免正负范围不一致。
    quantized = torch.clamp(
        torch.round(tensor / scale),
        -127,
        127,
    ).to(torch.int8)
    restored = quantized.float() * scale
    return quantized, restored, scale

def main() -> None:
    torch.manual_seed(7)
    weights = torch.randn(128, 256, dtype=torch.float32)

    quantized, restored, scale = symmetric_int8_quantize(weights)

    fp32_bytes = weights.nelement() * weights.element_size()
    # 估算中计入一个 float32 比例因子,不包含文件格式元数据。
    int8_bytes = (
        quantized.nelement() * quantized.element_size()
        + scale.element_size()
    )
    mean_error = (weights - restored).abs().mean().item()
    max_error = (weights - restored).abs().max().item()

    print(f"quantized dtype: {quantized.dtype}")
    print(f"fp32 bytes: {fp32_bytes}")
    print(f"int8 bytes: {int8_bytes}")
    print(f"estimated compression: {fp32_bytes / int8_bytes:.2f}x")
    print(f"mean absolute error: {mean_error:.6f}")
    print(f"max absolute error: {max_error:.6f}")

if __name__ == "__main__":
    main()
预期输出
quantized dtype: torch.int8
fp32 bytes: 131072
int8 bytes: 32772
estimated compression: 4.00x
mean absolute error: <VALUE>
max absolute error: <VALUE>
两个误差值会随 PyTorch 版本和运行平台产生细微差异,实际结果应为非负小数。固定的字节数来自 128 × 256 个 FP32 元素、同数量 INT8 元素以及一个 4 字节比例因子。
这个实验只证明张量可以被压缩并近似恢复,不能证明完整模型的任务指标不变。真实模型还可能包含卷积、归一化、Embedding、注意力和不支持量化的算子。
量化模型的验收顺序
先保存未量化模型的基线结果,包括验证集指标、模型文件大小、峰值内存、预热后的 p50/p95 延迟和吞吐量。随后在同一数据集、同一硬件、同一批次和同一运行时下测试量化版本。
精度验收要使用业务指标,而不是只比较单个张量误差。分类模型关注准确率、召回率或 F1,回归模型关注 MAE 或 RMSE,生成模型还要检查困惑度、任务评测和人工样例。
性能验收必须包含预热,并分开记录模型加载时间与稳定推理时间。若模型更小但延迟没有下降,应检查是否发生算子回退、量化与反量化开销过高、批次不合适,或硬件没有对应内核。
当前 PyTorch 量化能力主要向 TorchAO 集中,生产项目应根据设备和运行时选择 TorchAO、导出后端或专用推理引擎;不要把本课的手写张量示例直接替换进业务模型。