
机器学习与深度学习 / 系统课时
顺序模型与模块组合
顺序模型与模块组合
网络层增多后,直接把所有层写进 forward() 会让结构难以复用和检查。本课将使用 Sequential、ModuleList 与 ModuleDict 组织子模块,并正确实现循环、残差和多任务分支。
学习目标
- 区分三种模块容器的职责和执行方式
- 使用顺序容器搭建直线型网络
- 在
forward()中实现循环与条件分支
三种容器分别负责什么
nn.Sequential 不仅保存模块,还会按声明顺序自动把前一层输出传给后一层。它适合输入和输出沿一条固定路径流动的网络片段。
nn.ModuleList 像列表一样保存模块,但不会自动执行;nn.ModuleDict 通过字符串键保存模块,也不会自动选择分支。两者的关键价值是让其中的子模块被 PyTorch 正确注册,从而出现在参数遍历、设备迁移和模型保存结果中。
| 容器 | 是否自动前向传递 | 访问方式 | 适用结构 |
|---|---|---|---|
Sequential |
是 | 顺序执行 | 固定直线流水线 |
ModuleList |
否 | 整数索引或循环 | 重复层、动态深度 |
ModuleDict |
否 | 字符串键 | 多分支、多任务头 |
组合直线、循环与分支
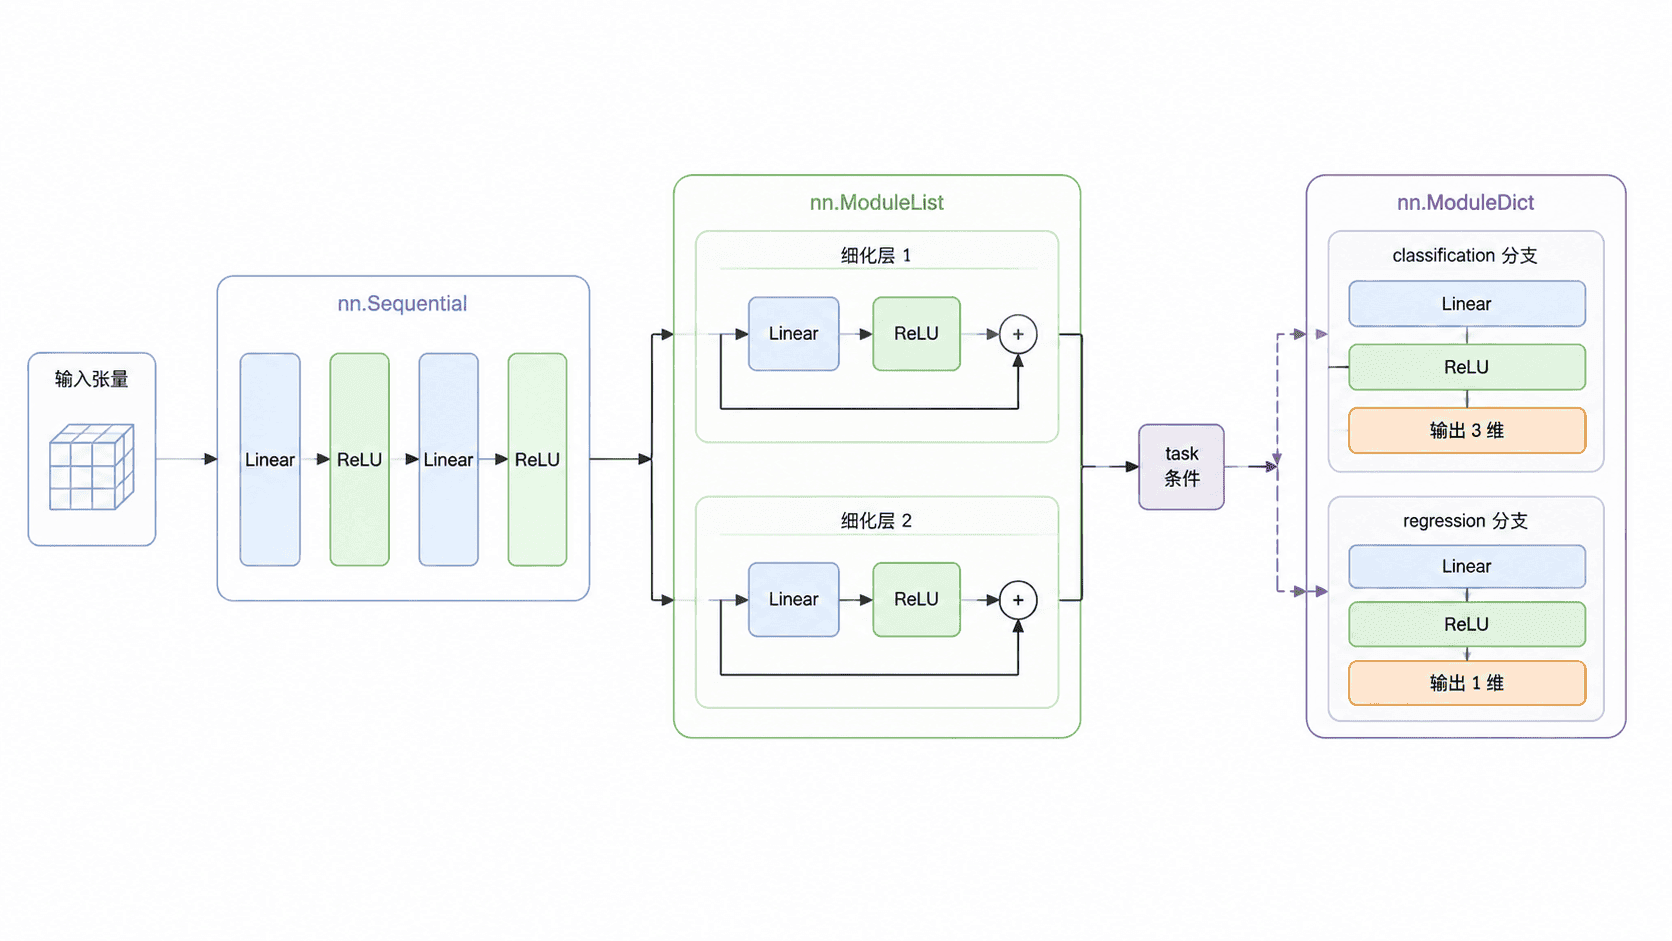
下面的模型先用 Sequential 提取共享特征,再循环执行 ModuleList 中的残差细化层,最后从 ModuleDict 选择分类头或回归头。
import torch
from torch import nn

class MultiTaskNet(nn.Module):
    def __init__(self) -> None:
        super().__init__()
        self.backbone = nn.Sequential(
            nn.Linear(4, 8),
            nn.ReLU(),
            nn.Linear(8, 8),
            nn.ReLU(),
        )
        self.refiners = nn.ModuleList(
            [nn.Linear(8, 8) for _ in range(2)]
        )
        self.heads = nn.ModuleDict(
            {
                "classification": nn.Linear(8, 3),
                "regression": nn.Linear(8, 1),
            }
        )

    def forward(self, x: torch.Tensor, task: str) -> torch.Tensor:
        x = self.backbone(x)

        # ModuleList 只注册层,具体循环与残差连接由 forward 决定
        for layer in self.refiners:
            x = torch.relu(layer(x)) + x

        if task not in self.heads:
            raise ValueError(f"unsupported task: {task}")
        return self.heads[task](x)

def main() -> None:
    torch.manual_seed(7)
    model = MultiTaskNet()
    inputs = torch.ones(2, 4)

    with torch.no_grad():
        classification = model(inputs, "classification")
        regression = model(inputs, "regression")

    print("classification:", tuple(classification.shape))
    print("regression:", tuple(regression.shape))
    print("parameter_count:", sum(p.numel() for p in model.parameters()))

if __name__ == "__main__":
    main()
预期输出
classification: (2, 3)
regression: (2, 1)
parameter_count: 292
两个任务共享相同主干和细化层,但输出维度由所选任务头决定。参数总数包含三个容器内的全部线性层,说明这些子模块已经完成注册。
为什么分支要写在 forward 中
Sequential 只能自然表达单输入沿固定顺序传递的结构。条件判断、循环次数、跳跃连接、多个输入或多个输出,都应由自定义模块的 forward() 明确描述。
不要使用普通 Python 列表保存需要训练的层,例如 self.layers = [nn.Linear(...)]。这种写法不会把列表中的层注册为子模块,优化器可能拿不到其参数;应改用 nn.ModuleList。按名称选择分支时,则使用 nn.ModuleDict 比手动维护多个属性更清晰。
如何验证组合是否正确
先用小批量假数据执行一次前向传播,检查每个分支的输出形状。随后通过 model.parameters() 或 model.state_dict() 确认参数是否完整;模型迁移到 GPU 时,容器内已注册的子模块也会随 model.to(device) 一起迁移。
当分支名来自接口或配置时,应像示例一样验证键是否存在,并对未知任务抛出明确异常。这样可以避免程序在更深层的矩阵运算中才出现难以定位的形状错误。