
机器学习与深度学习 / 系统课时
图像增强
图像增强
图像增强通过对同一训练图像进行随机裁剪、翻转、旋转和颜色扰动,让模型在不增加人工标注的情况下看到更多变化。本课将完成一套可运行的训练增强流程,并明确验证集为何不能使用随机增强。
学习目标
- 理解图像增强提升泛化能力的原因
- 使用
torchvision.transforms组合常见增强操作 - 区分训练集增强与验证集预处理
图像增强解决什么问题
训练图片数量有限时,模型容易记住拍摄角度、背景位置和亮度等偶然特征。图像增强在每次读取样本时随机改变外观,相当于从原图附近持续采样新样本,使模型更关注目标本身。
增强不能改变标签语义。例如,猫的水平翻转通常仍是猫,但数字 6 旋转后可能接近 9。选择增强策略时,必须先确认变换不会破坏任务定义。
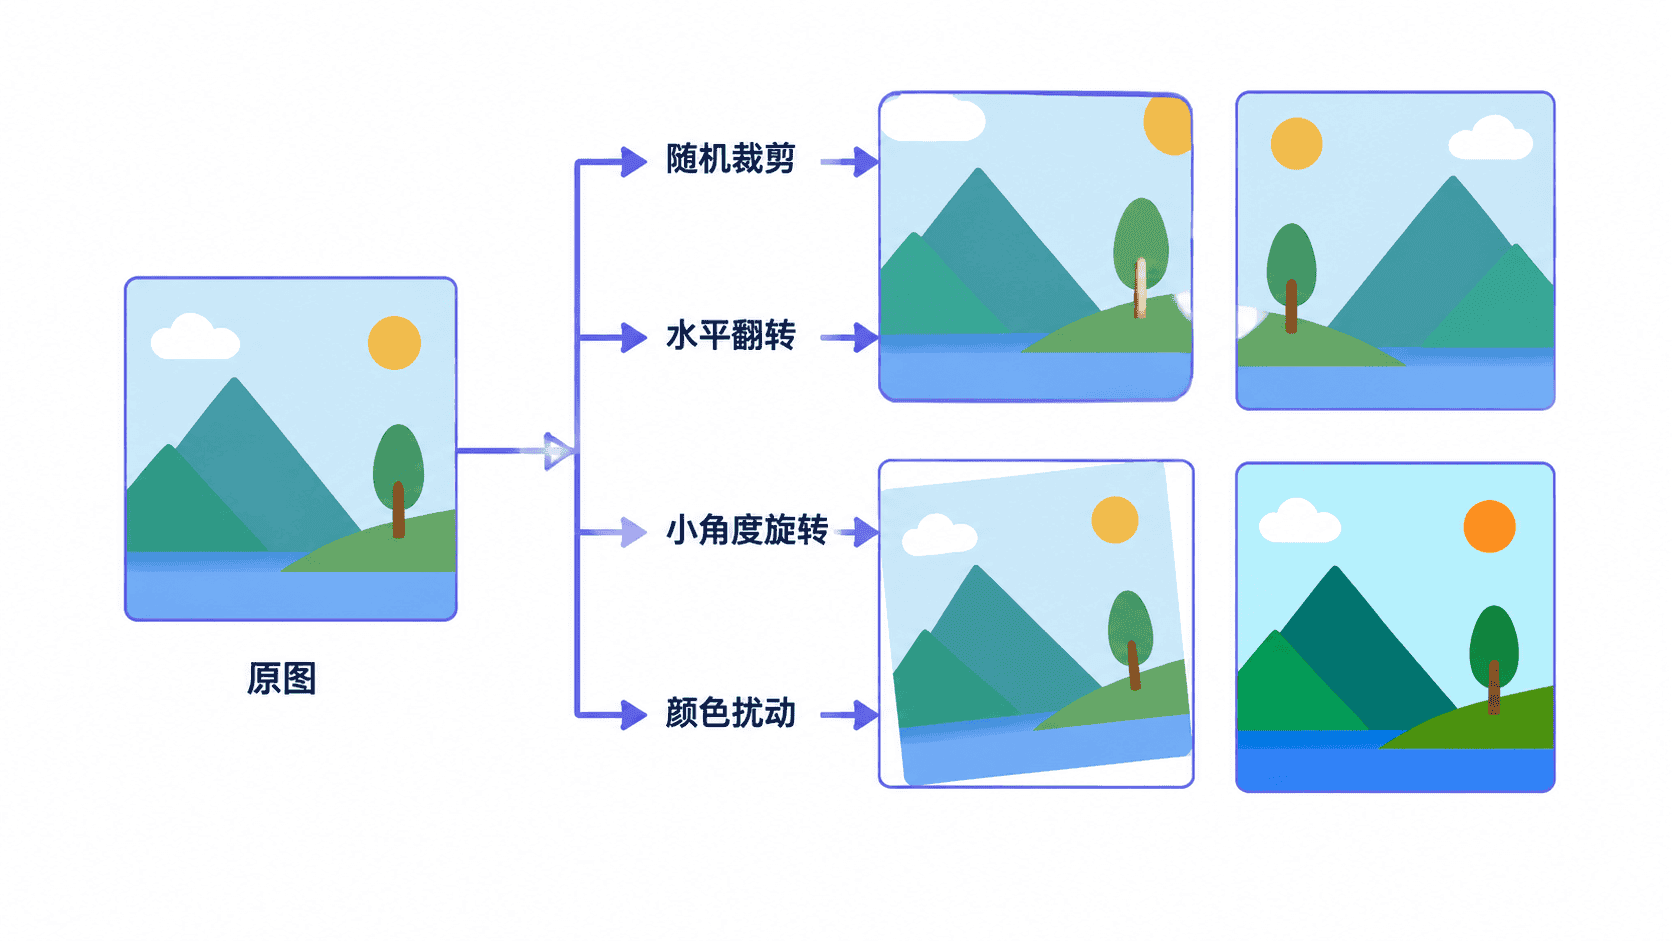
组合训练增强
下面的示例先创建一张内存图像,再依次执行随机裁剪、翻转、旋转和颜色变换。ToTensor 最后把图像转换为形状为 (C, H, W)、数值范围为 [0, 1] 的张量。
python
import random

import torch
from PIL import Image, ImageDraw
from torchvision import transforms

random.seed(7)
torch.manual_seed(7)

# 构造一张无需外部文件的测试图像
image = Image.new("RGB", (180, 140), "white")
draw = ImageDraw.Draw(image)
draw.rectangle((40, 30, 140, 110), fill="royalblue")

train_transform = transforms.Compose([
    transforms.RandomResizedCrop(128, scale=(0.7, 1.0)),
    transforms.RandomHorizontalFlip(p=0.5),
    transforms.RandomRotation(degrees=15),
    transforms.ColorJitter(
        brightness=0.2,
        contrast=0.2,
        saturation=0.2,
    ),
    transforms.ToTensor(),
])

augmented = train_transform(image)

print(tuple(augmented.shape))
print(0.0 <= float(augmented.min()) <= float(augmented.max()) <= 1.0)
预期输出:
text
(3, 128, 128)
True
随机增强每次运行都可能生成不同像素,但输出尺寸和数值范围应保持稳定。实际训练时,把 train_transform 传给训练集对应的 Dataset 即可。
训练集与验证集要分开
训练集需要随机变化,验证集则要稳定地衡量模型能力。验证阶段通常只做尺寸调整、中心裁剪和张量转换,避免同一模型因随机增强得到波动的评估结果。
python
from torchvision import transforms

val_transform = transforms.Compose([
    transforms.Resize(144),
    transforms.CenterCrop(128),
    transforms.ToTensor(),
])
这是配置片段,生效后每张验证图片都会经过固定预处理。验证方法是对同一图片重复调用 val_transform,两次结果应完全一致。
Tips:先从水平翻转、轻微裁剪和小范围颜色扰动开始。增强过强会让训练样本偏离真实数据分布,导致准确率下降。
常见边界
随机裁剪可能把目标主体完全切掉,因此 scale 不宜过小。旋转后出现的空白区域也可能成为模型捷径,需要结合真实场景调整角度和填充方式。
对于文字识别、方向判断和医学影像等任务,翻转或颜色变换可能改变语义。增强策略不是越多越好,而是要模拟部署环境中真实可能出现的变化。
按自己的节奏,确认真正理解。