
机器学习与深度学习 / 系统课时
记录训练指标
记录训练指标
训练是否有效,不能只看最后一次损失。本课将把损失、评估指标、学习率、运行时间和资源占用统一写入训练历史,并用一个可运行的 PyTorch 示例验证记录结果。
学习目标
- 区分批次级与轮次级指标,确定合理的记录频率
- 使用结构化日志保存训练、验证和资源指标
- 识别指标记录中的常见失真与性能问题
训练历史应该记录什么
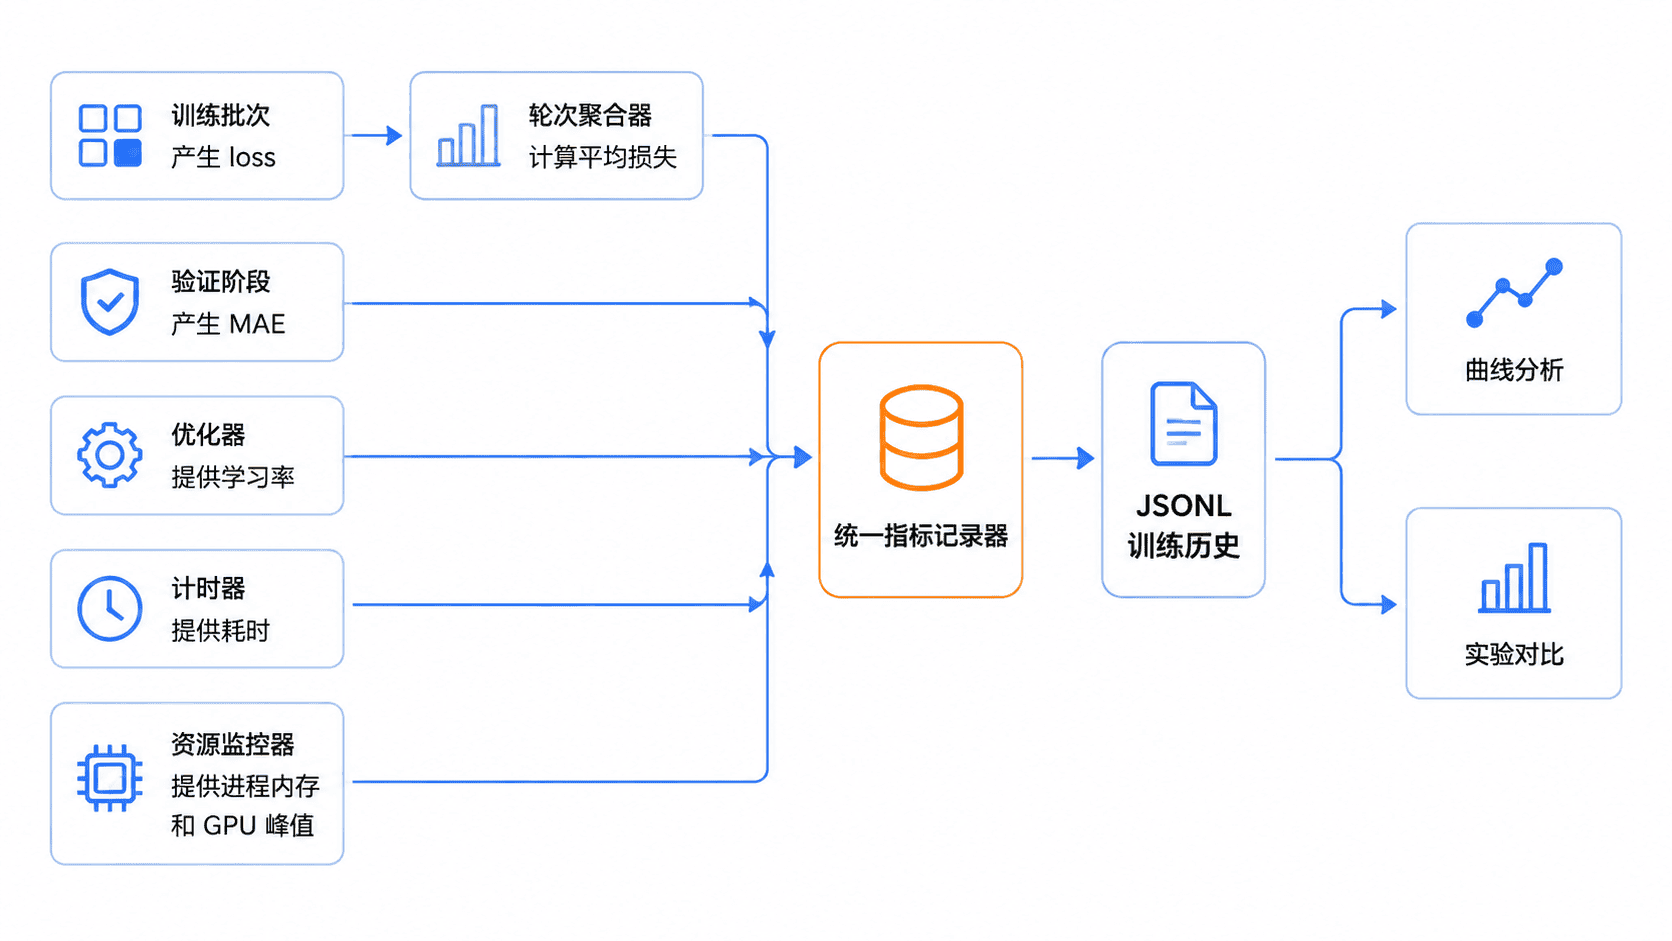
一份可分析的训练历史至少要回答五个问题:模型学得怎样、泛化怎样、优化器当时使用什么学习率、每轮耗时多少,以及训练消耗了多少资源。只保存 loss 会让学习率突变、验证集退化和资源瓶颈难以定位。
批次级指标适合观察梯度异常和瞬时抖动,但记录过密会增加磁盘与可视化开销。轮次级指标更适合长期对比。常见做法是每若干批次记录训练损失,每轮结束记录训练均值、验证指标、学习率、耗时和内存峰值。
设计稳定的指标结构
每条记录应包含固定字段和明确单位,例如 epoch、train_loss、val_mae、lr、elapsed_seconds、rss_mb 与 cuda_peak_mb。字段名一旦确定就不要随实验变化,否则后续脚本很难合并多次运行结果。
指标必须在正确时点读取。学习率应记录本轮实际使用的值;验证指标应在 model.eval() 与无梯度环境中计算;GPU 峰值应在每轮开始前重置,再在本轮结束后读取。损失均值还要按样本数加权,避免最后一个小批次造成偏差。
实现结构化指标记录
下面的脚本训练一个线性回归模型,并将每轮指标追加到 runs/metrics.jsonl。示例依赖 PyTorch 和 psutil,JSONL 每行都是独立 JSON,即使训练中断,已经写入的历史仍可读取。
import json
import time
from pathlib import Path

import psutil
import torch
from torch import nn
from torch.utils.data import DataLoader, TensorDataset

class JsonlMetricLogger:
    def __init__(self, path: str) -> None:
        self.path = Path(path)
        self.path.parent.mkdir(parents=True, exist_ok=True)

    def log(self, metrics: dict) -> None:
        # 逐行追加并立即落盘,降低训练中断时丢失历史的风险。
        with self.path.open("a", encoding="utf-8") as file:
            file.write(json.dumps(metrics, ensure_ascii=False) + "\n")

def main() -> None:
    torch.manual_seed(42)
    device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

    x = torch.linspace(-1, 1, 256).unsqueeze(1)
    y = 3 * x + 0.5
    train_loader = DataLoader(
        TensorDataset(x[:200], y[:200]), batch_size=32, shuffle=True
    )
    val_x, val_y = x[200:].to(device), y[200:].to(device)

    model = nn.Linear(1, 1).to(device)
    optimizer = torch.optim.SGD(model.parameters(), lr=0.1)
    scheduler = torch.optim.lr_scheduler.StepLR(
        optimizer, step_size=2, gamma=0.5
    )
    loss_fn = nn.MSELoss()
    logger = JsonlMetricLogger("runs/metrics.jsonl")
    process = psutil.Process()

    for epoch in range(1, 6):
        model.train()
        started_at = time.perf_counter()
        loss_sum = 0.0
        sample_count = 0

        if device.type == "cuda":
            torch.cuda.reset_peak_memory_stats(device)

        for batch_x, batch_y in train_loader:
            batch_x, batch_y = batch_x.to(device), batch_y.to(device)
            optimizer.zero_grad(set_to_none=True)
            loss = loss_fn(model(batch_x), batch_y)
            loss.backward()
            optimizer.step()

            # 按样本数累加,保证不同大小批次的均值计算正确。
            batch_size = batch_x.size(0)
            loss_sum += loss.item() * batch_size
            sample_count += batch_size

        model.eval()
        with torch.inference_mode():
            val_mae = (model(val_x) - val_y).abs().mean().item()

        metrics = {
            "epoch": epoch,
            "train_loss": loss_sum / sample_count,
            "val_mae": val_mae,
            "lr": optimizer.param_groups[0]["lr"],
            "elapsed_seconds": time.perf_counter() - started_at,
            "rss_mb": process.memory_info().rss / 1024**2,
            "cuda_peak_mb": (
                torch.cuda.max_memory_allocated(device) / 1024**2
                if device.type == "cuda"
                else 0.0
            ),
        }
        logger.log(metrics)
        print(
            f"epoch={epoch} "
            f"loss={metrics['train_loss']:.6f} "
            f"val_mae={metrics['val_mae']:.6f} "
            f"lr={metrics['lr']:.4f} "
            f"time={metrics['elapsed_seconds']:.3f}s"
        )
        scheduler.step()

if __name__ == "__main__":
    main()
预期输出
epoch=1 loss=<VALUE> val_mae=<VALUE> lr=0.1000 time=<TIME>s
epoch=2 loss=<VALUE> val_mae=<VALUE> lr=0.1000 time=<TIME>s
epoch=3 loss=<VALUE> val_mae=<VALUE> lr=0.0500 time=<TIME>s
epoch=4 loss=<VALUE> val_mae=<VALUE> lr=0.0500 time=<TIME>s
epoch=5 loss=<VALUE> val_mae=<VALUE> lr=0.0250 time=<TIME>s
<VALUE> 会随 PyTorch 版本和计算设备产生轻微差异,<TIME> 取决于机器性能。运行后,runs/metrics.jsonl 应包含 5 行记录,并且每行都能被标准 JSON 解析器独立读取。
验证记录是否可信
先检查记录数量是否等于完成的轮数,再检查字段类型和单位是否一致。训练损失持续下降而验证指标变差,通常意味着过拟合;损失突然跳变时,应同时查看学习率是否刚刚变化。
资源指标需要结合采样口径理解。进程常驻内存不会等同于整机内存,GPU 的 max_memory_allocated 只统计张量分配,不包含驱动和部分缓存。跨机器比较时,应同时保存设备型号、软件版本和批次大小。
常见错误与改进
不要直接记录最后一个批次的损失来代表整轮训练,也不要在验证阶段忘记切换 eval()。频繁同步 GPU 数值到 CPU 还会拖慢训练,因此批次级日志应控制频率,轮次级指标再做完整汇总。
生产训练可以在 JSONL 之外接入 TensorBoard 或实验平台,但本地结构化文件仍值得保留。它不依赖服务可用性,便于归档,也能作为外部平台记录失败时的兜底数据。