
机器学习与深度学习 / 系统课时
系统化调参方法
系统化调参方法
系统化调参的目标不是尝试更多组合,而是让每次实验都能回答一个明确问题。本课将建立统一基线,按数据、模型、优化器和训练策略逐层排查,并用可执行配置检查保证实验之间真正可比较。
学习目标
- 建立包含数据版本、指标和训练预算的稳定基线
- 按固定顺序设计单变量调参实验
- 用结构化记录判断配置应保留、回滚还是继续验证
先固定基线与评价协议
调参前先完成一个能够稳定复现的基线。基线不要求结果最好,但必须能正常训练,并固定训练集、验证集、随机种子、评价指标、训练轮数上限和硬件条件。否则两次结果的差异可能来自数据划分或运行环境,而不是被修改的参数。
评价协议应同时包含主指标和约束指标。例如分类任务可以把验证集 F1 作为主指标,同时记录训练时长、显存峰值和推理延迟。只有主指标提高且资源代价可接受,实验结果才值得保留。
按四层顺序缩小搜索空间
推荐先检查数据,再调整模型,然后优化优化器,最后修改训练策略。数据错误会污染后续所有实验;模型容量决定可达到的上限;优化器与学习率影响收敛路径;训练轮数、早停和批大小用于控制训练过程与资源消耗。
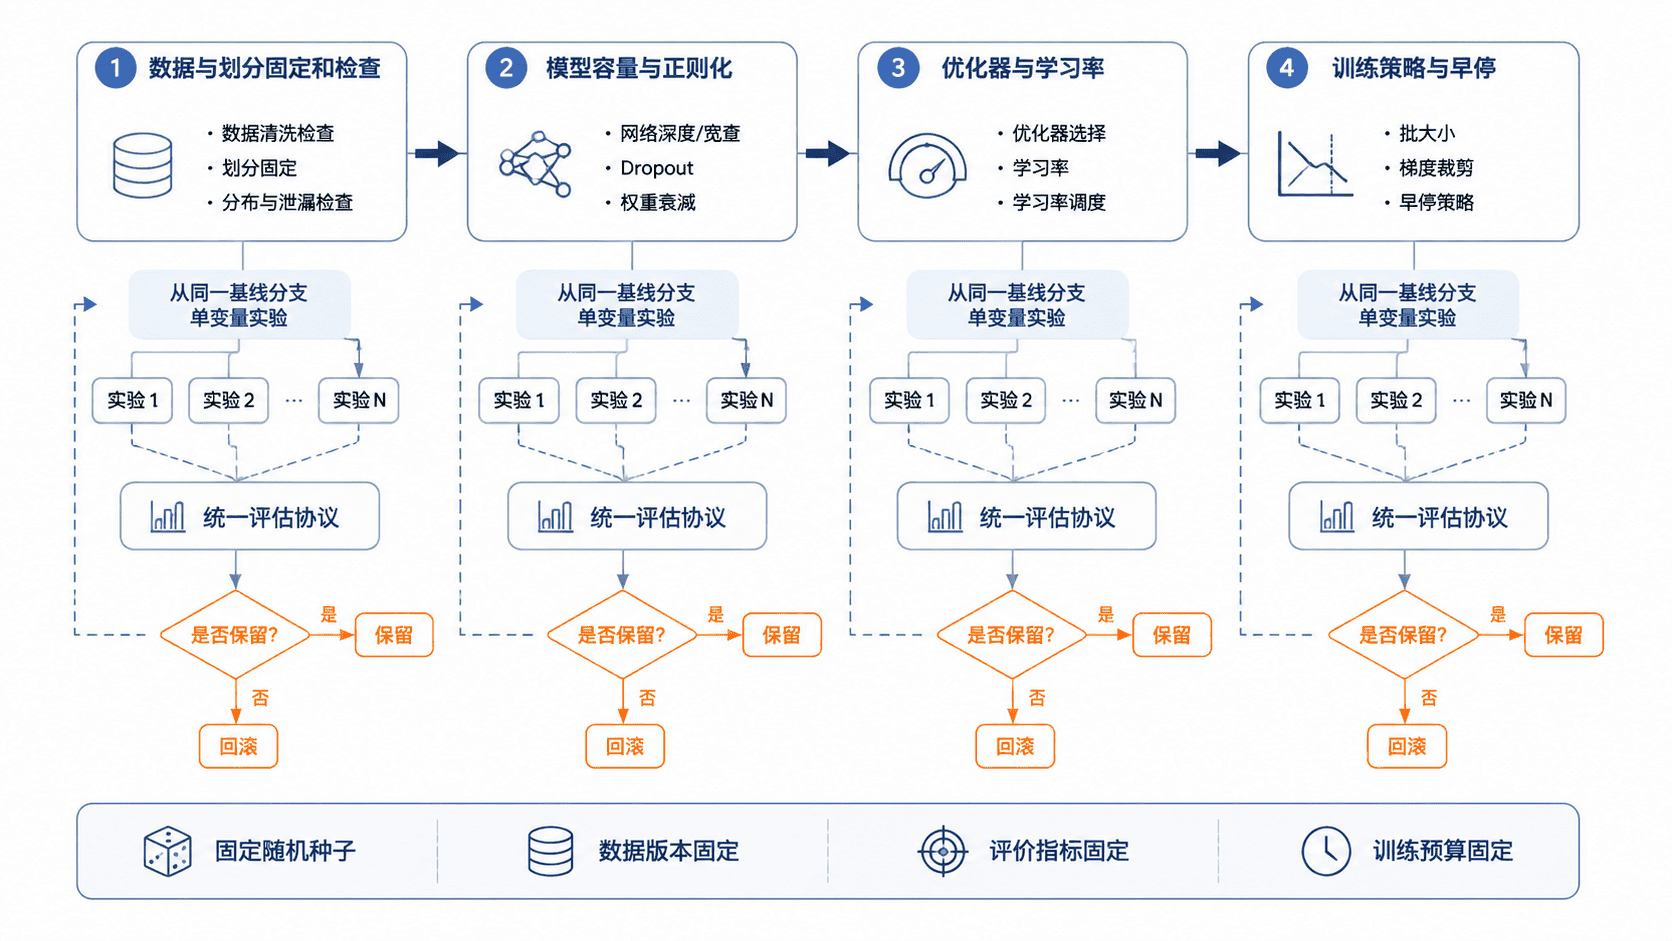
每一层只提出少量可验证假设。例如数据层先验证归一化和增强是否有效,模型层再比较宽度或正则化,优化器层重点搜索学习率,训练策略层最后处理轮数、早停和梯度累积。前一层尚未稳定时,不要急着扩大后一层搜索空间。
用单变量实验保证可比性
一次实验只改变一个字段,最容易解释结果。下面脚本定义基线配置,并检查每个候选实验是否只修改一个变量,同时标出它属于哪个调参阶段。
from dataclasses import asdict, dataclass, replace
from typing import Dict, Tuple

@dataclass(frozen=True)
class ExperimentConfig:
    dataset_version: str = "v1"
    augment: bool = False
    hidden_dim: int = 128
    dropout: float = 0.2
    optimizer: str = "adamw"
    learning_rate: float = 1e-3
    batch_size: int = 64
    epochs: int = 20

FIELD_STAGE: Dict[str, str] = {
    "dataset_version": "数据",
    "augment": "数据",
    "hidden_dim": "模型",
    "dropout": "模型",
    "optimizer": "优化器",
    "learning_rate": "优化器",
    "batch_size": "训练策略",
    "epochs": "训练策略",
}

def validate_single_change(
    baseline: ExperimentConfig,
    candidate: ExperimentConfig,
) -> Tuple[str, str]:
    base_values = asdict(baseline)
    candidate_values = asdict(candidate)
    changed = [
        name
        for name, value in candidate_values.items()
        if value != base_values[name]
    ]

    if len(changed) != 1:
        raise ValueError(f"实验必须只修改一个字段,当前修改: {changed}")

    field = changed[0]
    return FIELD_STAGE[field], field

def main() -> None:
    baseline = ExperimentConfig()
    plans = {
        "data-augment": replace(baseline, augment=True),
        "wider-model": replace(baseline, hidden_dim=256),
        "lower-lr": replace(baseline, learning_rate=3e-4),
        "longer-train": replace(baseline, epochs=40),
    }

    for name, candidate in plans.items():
        stage, field = validate_single_change(baseline, candidate)
        print(f"{name}: {stage} -> {field}")

if __name__ == "__main__":
    main()
预期输出
data-augment: 数据 -> augment
wider-model: 模型 -> hidden_dim
lower-lr: 优化器 -> learning_rate
longer-train: 训练策略 -> epochs
该检查不能替代真实训练,但能在实验启动前阻止“同时改模型、学习率和轮数”这类不可解释的比较。实际项目还应把配置快照、代码提交号、数据版本和最终指标写入同一条实验记录。
记录结果并做下一步决策
每次实验至少记录假设、唯一改动、主指标、资源指标和结论。结论只分为三类:保留,表示证据稳定且代价可接受;回滚,表示没有收益或引入明显副作用;继续验证,表示提升较小或不同随机种子之间波动较大。
| 实验 | 唯一改动 | 主指标 | 资源变化 | 决策 |
|---|---|---|---|---|
| baseline | 无 | 0.842 | 基准 | 保留 |
| lower-lr | 学习率降至 3e-4 |
0.851 | 训练时间增加 8% | 继续验证 |
| wider-model | 隐藏维度增至 256 | 0.850 | 显存增加 42% | 回滚 |
表中的数值只是记录格式示例,不代表固定结论。真实实验应至少重复多个随机种子,并报告均值与波动;当提升小于波动范围时,不应仅凭一次最好结果升级基线。
常见失效方式
最常见的问题是没有固定数据划分、一次改动多个参数、只保存最好指标而忽略失败实验,以及在不同训练预算下直接比较结果。另一个误区是过早进行大规模网格搜索:如果数据管道或基线本身不稳定,搜索只会放大噪声和计算成本。
更稳妥的做法是先用小预算筛选方向,再对少量候选配置增加训练轮数和随机种子复验。每次确认一个结论后更新基线,后续实验都从新的基线继续,而不是从多个历史配置随意分叉。