
机器学习与深度学习 / 系统课时
划分训练验证测试集
划分训练验证测试集
可靠评估的前提是训练、调参与最终测试使用彼此隔离的数据。本课将明确三个数据集的职责,使用固定随机种子完成可复现划分,并检查样本索引是否发生交叉泄漏。
学习目标
- 区分训练集、验证集和测试集的职责
- 使用
random_split完成可复现的数据划分 - 识别随机划分、时间数据和分组数据中的泄漏风险
三个数据集各自解决什么问题
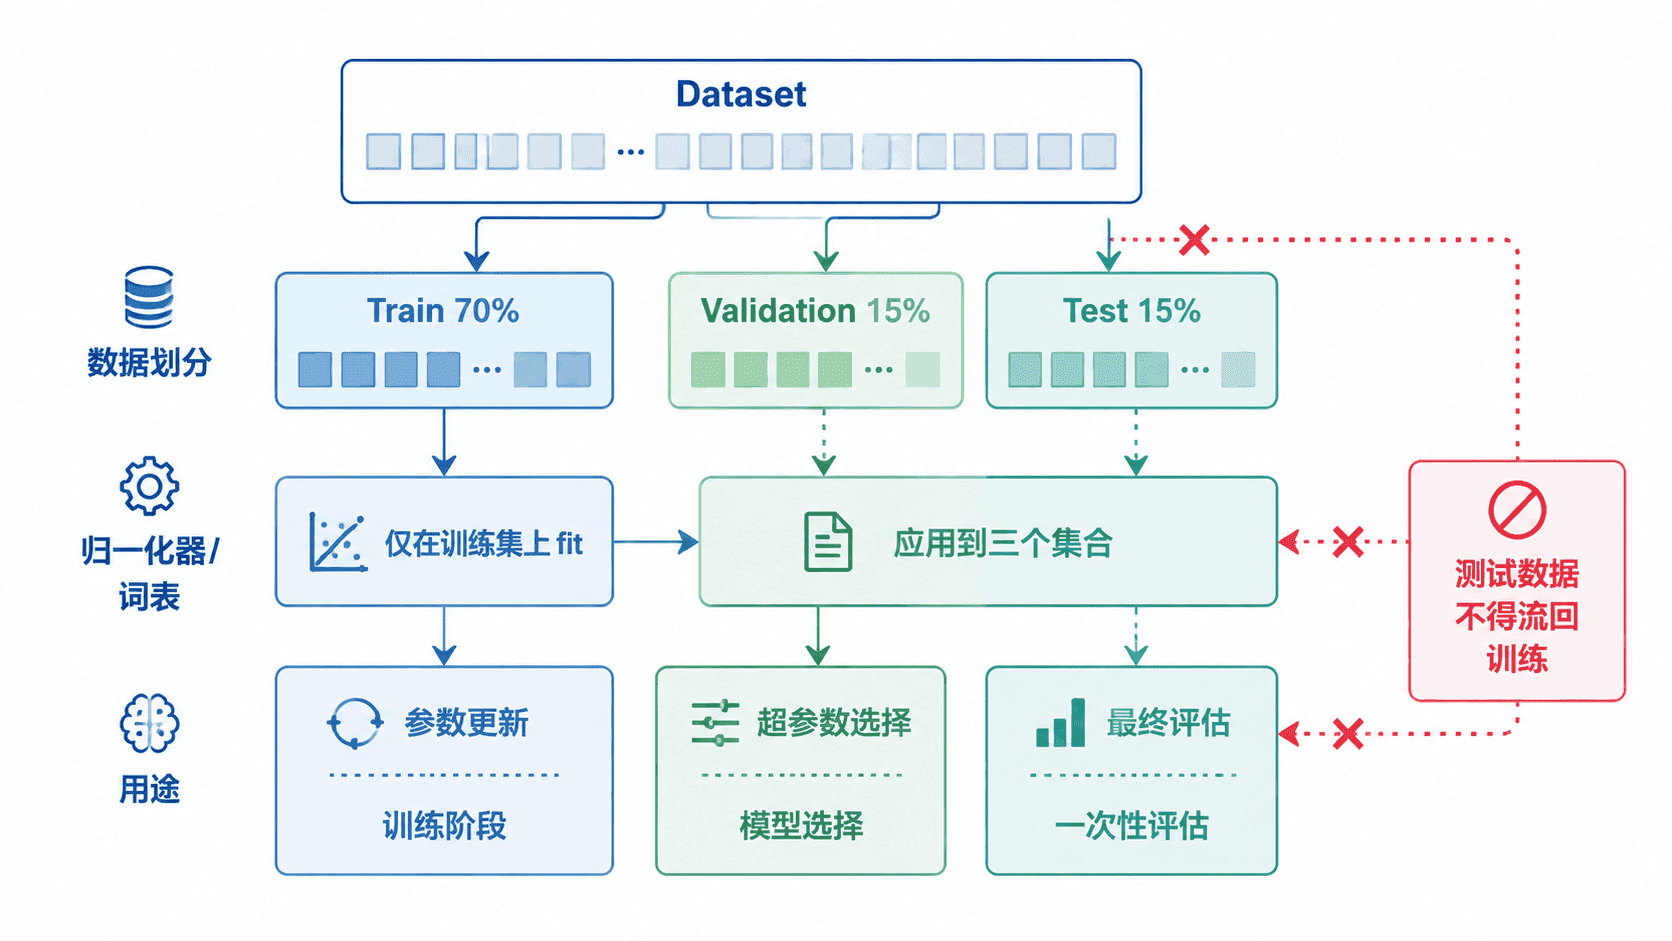
训练集用于计算损失、反向传播并更新模型参数。模型可以反复读取这些数据,因此训练集直接参与模型能力的形成。
验证集用于选择网络结构、学习率、训练轮数和其他超参数。验证结果可以多次查看,但验证样本不能参与参数更新,否则评估值会偏高。
测试集用于模型和方案已经确定后的最终评估。若根据测试结果继续调整模型,测试集实际上就变成了验证集,最终指标也不再代表对未知数据的泛化能力。
先确定正确的划分单位
普通独立样本可以随机拆分,例如按 70%、15%、15% 分成训练、验证和测试集。比例并没有唯一答案,数据量较小时可以适当提高验证集和测试集占比,数据量很大时较小比例也可能提供足够样本。
存在时间顺序的数据不应随意打乱。预测未来销量、设备故障或金融序列时,通常应使用较早数据训练、较晚数据验证和测试,否则模型可能通过未来信息间接预测过去。
同一用户、患者、设备或原始文档产生的多条记录应按组划分。若同一对象的相似样本同时出现在训练集和测试集,模型可能只是在识别对象特征,而不是学习能够泛化的规律。
使用 random_split 可复现划分
torch.utils.data.random_split 会随机生成互不重复的索引,并返回多个 Subset。划分时传入固定种子的 Generator,可以让同一份数据和同一组长度得到一致的拆分结果。
下面创建 100 个带样本编号的数据,并按 70、15、15 进行划分。代码随后检查三个索引集合是否存在交集。
import torch
from torch.utils.data import Dataset, random_split

class SampleDataset(Dataset):
    def __init__(self, size: int = 100):
        self.features = torch.arange(size, dtype=torch.float32).unsqueeze(1)
        self.labels = (torch.arange(size) % 2).long()

    def __len__(self) -> int:
        return len(self.features)

    def __getitem__(self, index: int):
        # 返回样本编号,便于验证三个子集是否包含重复样本
        return index, self.features[index], self.labels[index]

dataset = SampleDataset(size=100)
generator = torch.Generator().manual_seed(2026)

train_set, validation_set, test_set = random_split(
    dataset,
    lengths=[70, 15, 15],
    generator=generator,
)

train_ids = set(train_set.indices)
validation_ids = set(validation_set.indices)
test_ids = set(test_set.indices)

has_leakage = bool(
    (train_ids & validation_ids)
    or (train_ids & test_ids)
    or (validation_ids & test_ids)
)

print("集合大小:", len(train_set), len(validation_set), len(test_set))
print("唯一索引数:", len(train_ids | validation_ids | test_ids))
print("存在样本泄漏:", has_leakage)
预期输出如下。唯一索引数等于原始数据集大小,并且三个集合之间没有重复索引。
集合大小: 70 15 15
唯一索引数: 100
存在样本泄漏: False
固定随机种子只保证划分过程可复现,不代表当前划分一定适合业务。类别严重不平衡时,纯随机拆分可能让少数类别集中在某个子集中,应改用分层划分并检查每个集合的类别分布。
防止预处理造成隐性泄漏
数据划分应发生在会学习数据统计量的预处理之前。标准化的均值和方差、缺失值填充值、词表、类别编码映射以及特征选择规则,都只能使用训练集进行拟合。
正确顺序是先确定三个集合,再在训练集上执行 fit,最后用同一个处理器分别转换训练、验证和测试数据。若先对完整数据计算均值或选择特征,验证集和测试集的信息就已经进入训练过程。
数据增强通常只用于训练集。验证和测试阶段应使用稳定、可重复的转换,否则每次评估输入都可能变化,指标也难以比较。图像缩放等确定性处理可以共享,但随机裁剪、随机翻转等增强应限制在训练数据管道中。
划分后的验收检查
完成划分后,至少应确认三个集合的样本数量之和等于原始数据集大小,并检查样本编号、文件路径或业务主键没有交叉。分类任务还应比较类别比例,回归任务可以比较目标值分布。
时间任务需要核对时间边界,确保验证和测试样本晚于训练数据。分组任务则要检查同一个用户、设备或实体是否只属于一个集合。只有划分单位与真实上线场景一致,离线评估结果才具有参考价值。