
机器学习与深度学习 / 系统课时
张量变形与拼接
张量变形与拼接
模型通常要求输入具有固定的批次、通道或特征维度。本课将用一组可运行示例掌握重塑、换轴、压缩、扩展、拼接与堆叠,并能根据目标形状选择正确操作。
学习目标
- 根据元素数量判断张量能否重塑
- 区分
reshape、permute、squeeze和unsqueeze - 正确选择
torch.cat或torch.stack组织模型输入
先读懂形状变化
张量变形只改变数据的组织方式,不应凭空增加或丢失元素。假设原张量形状为 (2, 3, 4),元素总数是 24;它可以重塑为 (2, 12) 或 (6, 4),但不能重塑为 (5, 5)。
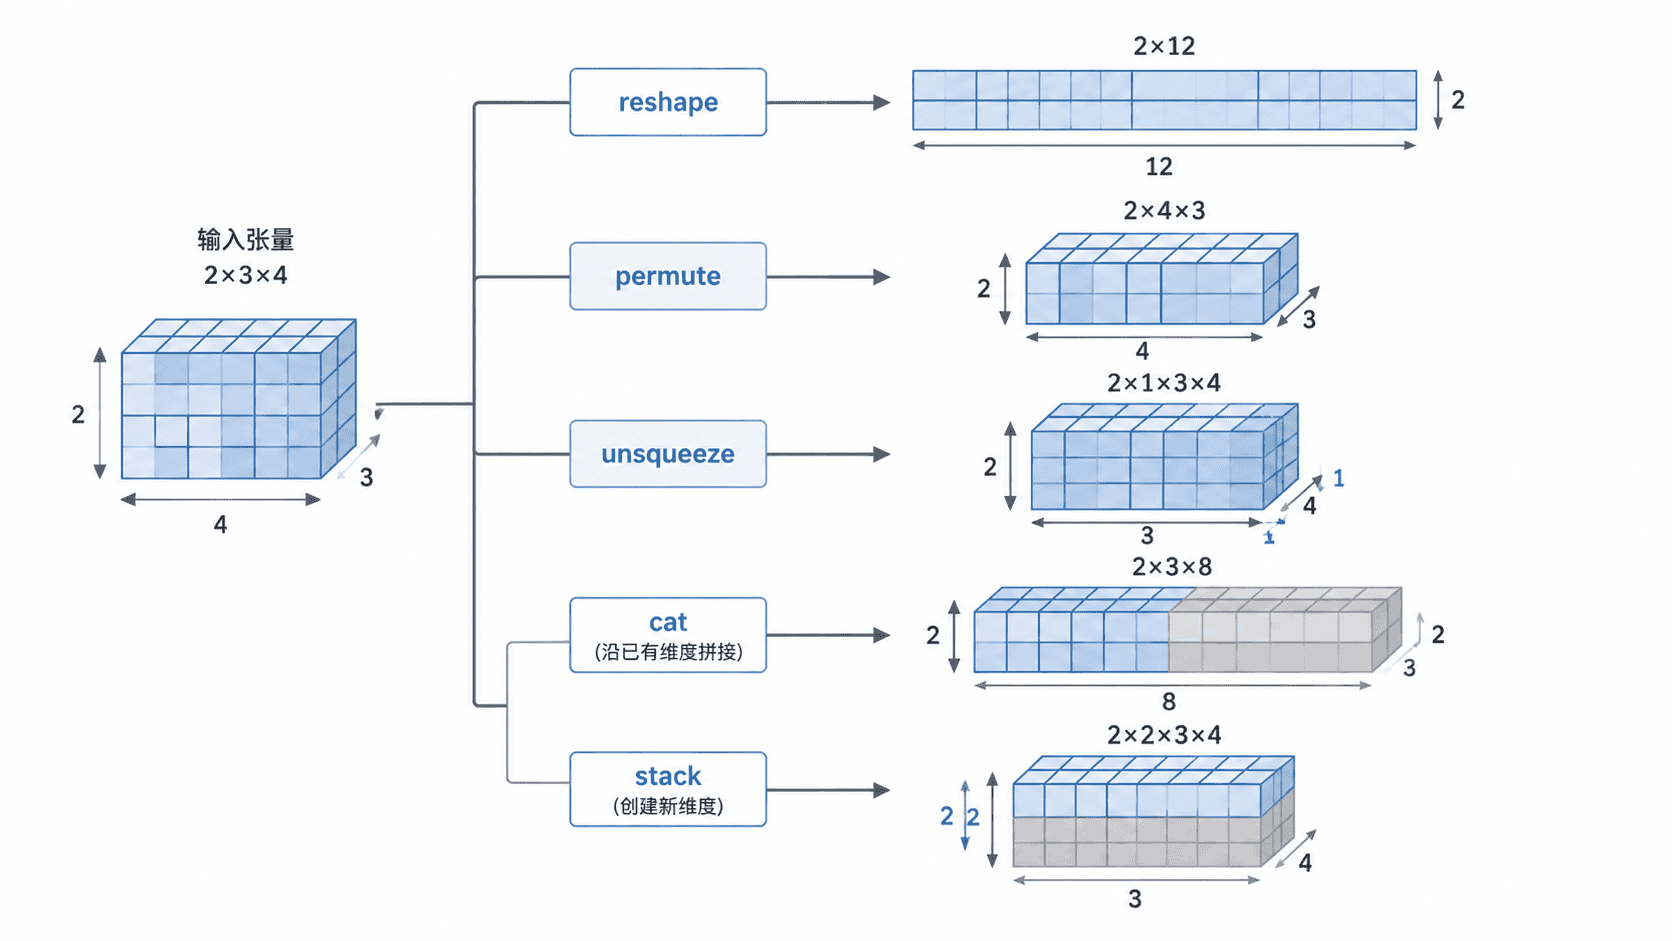
reshape 重新解释各维度的长度;permute 按给定顺序重排所有轴;transpose 只交换两个轴。三者都不会改变元素值,但 permute 后的张量常常不是连续内存布局。
压缩与扩展长度为 1 的维度
unsqueeze(dim) 在指定位置插入一个长度为 1 的维度,常用于补批次维或通道维。squeeze(dim) 只删除指定位置且长度为 1 的维度;不传 dim 会删除所有长度为 1 的维度,可能误删批次维,因此工程中更推荐明确指定维度。
例如,单张灰度图形状为 (28, 28),执行 unsqueeze(0).unsqueeze(0) 后得到 (1, 1, 28, 28),可分别表示批次维和通道维。
区分拼接与堆叠
torch.cat 沿已有维度连接张量,除拼接维外,其余维度必须一致。torch.stack 会先创建一个新维度,再把形状完全相同的张量放入该维度。
| 操作 | 是否新增维度 | 输入要求 | 典型用途 |
|---|---|---|---|
torch.cat |
否 | 除目标维外其余形状一致 | 合并批次、序列或特征 |
torch.stack |
是 | 所有输入形状完全一致 | 组成新的批次或时间维 |
选择时先问一个问题:结果需要增加一条新轴吗?需要就用 stack,只想延长现有轴就用 cat。
完整示例与验证
下面的程序集中演示常用操作,并用形状验证每一步是否符合预期。
import torch

x = torch.arange(24).reshape(2, 3, 4)

reshaped = x.reshape(2, 12)
permuted = x.permute(0, 2, 1)

# 在第 1 维插入长度为 1 的轴,再明确删除该轴
expanded = x.unsqueeze(1)
restored = expanded.squeeze(1)

a = torch.tensor([[1, 2], [3, 4]])
b = torch.tensor([[5, 6], [7, 8]])

# cat 延长现有第 0 维,stack 创建新的第 0 维
joined = torch.cat([a, b], dim=0)
stacked = torch.stack([a, b], dim=0)

print("x:", tuple(x.shape))
print("reshaped:", tuple(reshaped.shape))
print("permuted:", tuple(permuted.shape))
print("expanded:", tuple(expanded.shape))
print("restored:", tuple(restored.shape))
print("joined:", tuple(joined.shape), joined.tolist())
print("stacked:", tuple(stacked.shape))
预期输出
x: (2, 3, 4)
reshaped: (2, 12)
permuted: (2, 4, 3)
expanded: (2, 1, 3, 4)
restored: (2, 3, 4)
joined: (4, 2) [[1, 2], [3, 4], [5, 6], [7, 8]]
stacked: (2, 2, 2)
关键边界与常见错误
reshape 要求重塑前后元素总数一致,其中一个维度可以写成 -1 让 PyTorch 自动推断。一个形状中最多只能出现一个 -1。
view 更依赖连续内存。张量经过 permute 后直接调用 view 可能报错,此时优先使用 reshape,或先调用 contiguous() 再使用 view。
拼接失败时,应逐轴比较输入形状。对于 cat,只允许目标维不同;对于 stack,任何维度不同都会失败。