
机器学习与深度学习 / 系统课时
PyTorch 核心组件
PyTorch 核心组件
本课不把 PyTorch 当作一组零散 API,而是把张量、自动微分、神经网络模块、优化器和数据加载器放进同一条执行链。完成后,你能说清每个组件保存什么、负责什么,以及它们如何共同完成一次训练。
学习目标
- 区分五类核心组件的职责与交接数据
- 理解梯度计算和参数更新为何由不同组件完成
- 使用核心组件搭建并验证一个最小二分类训练程序
五个组件如何协作
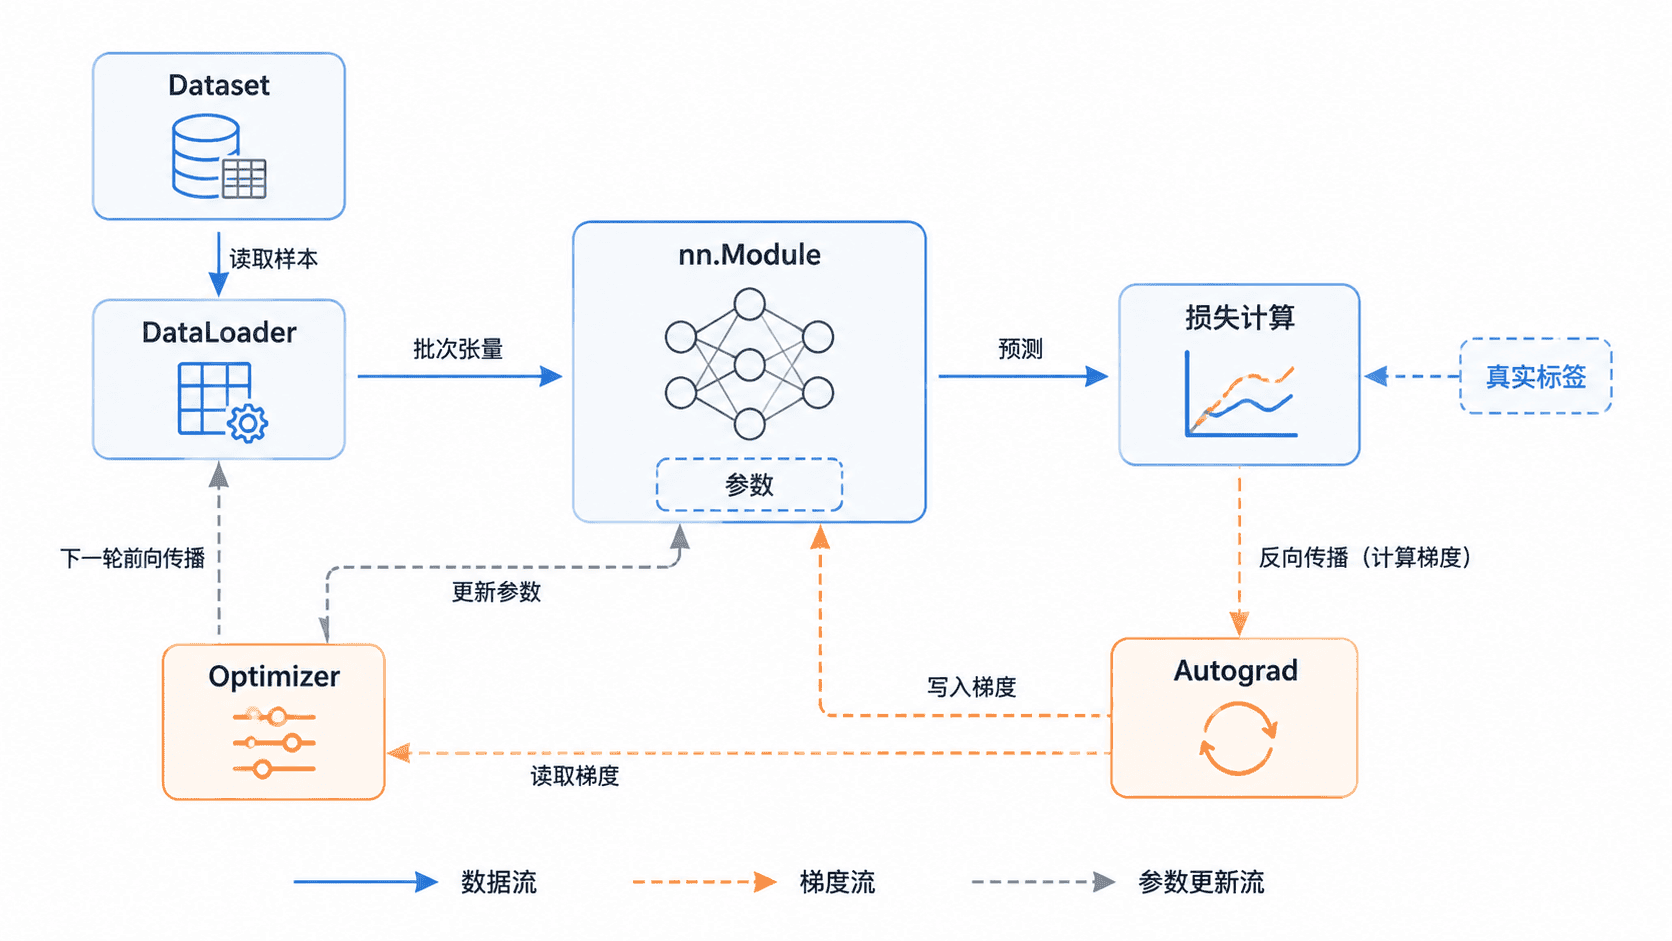
训练开始于数据加载器提供批次,批次以张量形式进入神经网络模块。模块执行前向计算后产生预测,损失值触发自动微分计算梯度,优化器最后读取梯度并更新模块参数。
| 组件 | 核心职责 | 常见对象 |
|---|---|---|
| 张量 | 保存数据、参数和计算结果,并携带形状、类型与设备信息 | torch.Tensor |
| 自动微分 | 记录张量运算关系,并从损失反向计算参数梯度 | torch.autograd、backward() |
| 神经网络模块 | 组织可训练参数、子模块和前向计算逻辑 | nn.Module、nn.Sequential |
| 优化器 | 按梯度和更新规则修改模型参数 | SGD、Adam |
| 数据加载器 | 从数据集中取样、分批、打乱并并行加载 | Dataset、DataLoader |
这些组件不是彼此替代的工具,而是流水线上的不同角色。缺少任意一环,训练闭环都会中断。
张量与自动微分
张量是 PyTorch 的基础数据容器。输入样本、标签、模型参数、预测值和损失最终都表示为张量。张量的 shape 决定维度结构,dtype 决定数值类型,device 决定数据位于 CPU 还是加速设备。
当参与运算的参数需要梯度时,PyTorch 会在前向传播期间动态记录运算关系。调用 loss.backward() 后,自动微分沿计算图反向应用链式法则,并把结果写入参数的 .grad。
自动微分只负责求导,不负责修改参数。计算图通常在一次反向传播后释放,下一次前向传播会根据实际执行路径重新建立,因此 PyTorch 能自然支持条件分支和循环。
模块、优化器与数据加载器
nn.Module 负责把参数和计算逻辑组织成模型。只要子层被注册为模块属性,model.parameters() 就能递归找到其可训练参数,优化器也能统一管理它们。
优化器接收参数集合,但不会自行计算梯度。optimizer.step() 读取每个参数的 .grad,再根据 SGD、Adam 等规则更新参数值;optimizer.zero_grad() 则清除旧梯度。
Dataset 定义“第几个样本是什么”,DataLoader 负责“怎样把样本送入训练”。批大小、是否打乱、并行工作进程等数据管线策略,通常都由数据加载器控制。
用一个程序串起全部组件
下面训练一个逻辑“或”二分类器。代码同时使用张量、数据集、数据加载器、神经网络模块、自动微分和优化器,并用断言验证最终分类结果。
import torch
from torch import nn
from torch.utils.data import DataLoader, TensorDataset

torch.manual_seed(7)

# 四个样本构成逻辑“或”数据集,标签形状与模型输出一致。
features = torch.tensor([
    [0.0, 0.0],
    [0.0, 1.0],
    [1.0, 0.0],
    [1.0, 1.0],
])
labels = torch.tensor([[0.0], [1.0], [1.0], [1.0]])

dataset = TensorDataset(features, labels)
loader = DataLoader(dataset, batch_size=4, shuffle=False)

model = nn.Sequential(nn.Linear(2, 1))
loss_fn = nn.BCEWithLogitsLoss()
optimizer = torch.optim.SGD(model.parameters(), lr=0.5)

for _ in range(300):
    for batch_x, batch_y in loader:
        logits = model(batch_x)
        loss = loss_fn(logits, batch_y)

        # backward 产生梯度,step 才真正更新模型参数。
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()

model.eval()
with torch.no_grad():
    probabilities = torch.sigmoid(model(features))
    predictions = (probabilities >= 0.5).float()

accuracy = (predictions == labels).float().mean().item()
assert accuracy == 1.0
print("核心组件协作正常")
预期输出:
核心组件协作正常BCEWithLogitsLoss 直接接收未经过 Sigmoid 的 logits,以获得更稳定的数值计算;只有在评估并转换为概率时,示例才显式调用 torch.sigmoid()。
容易混淆的职责边界
张量负责承载数值,自动微分负责追踪运算并求梯度。把张量移动到某个设备,并不意味着模型也会自动移动;输入和模型参数必须位于同一设备。
loss.backward() 不更新权重,optimizer.step() 也不重新计算梯度。二者必须按顺序配合,而且更新前通常要清除上一轮梯度。
model.eval() 不等于 torch.no_grad()。前者切换模块行为,后者关闭梯度记录;评估代码通常两者都需要。DataLoader 也不会自动把批次移动到 GPU,设备迁移应在训练循环中显式完成。