
机器学习与深度学习 / 系统课时
排查显存与数值异常
排查显存与数值异常
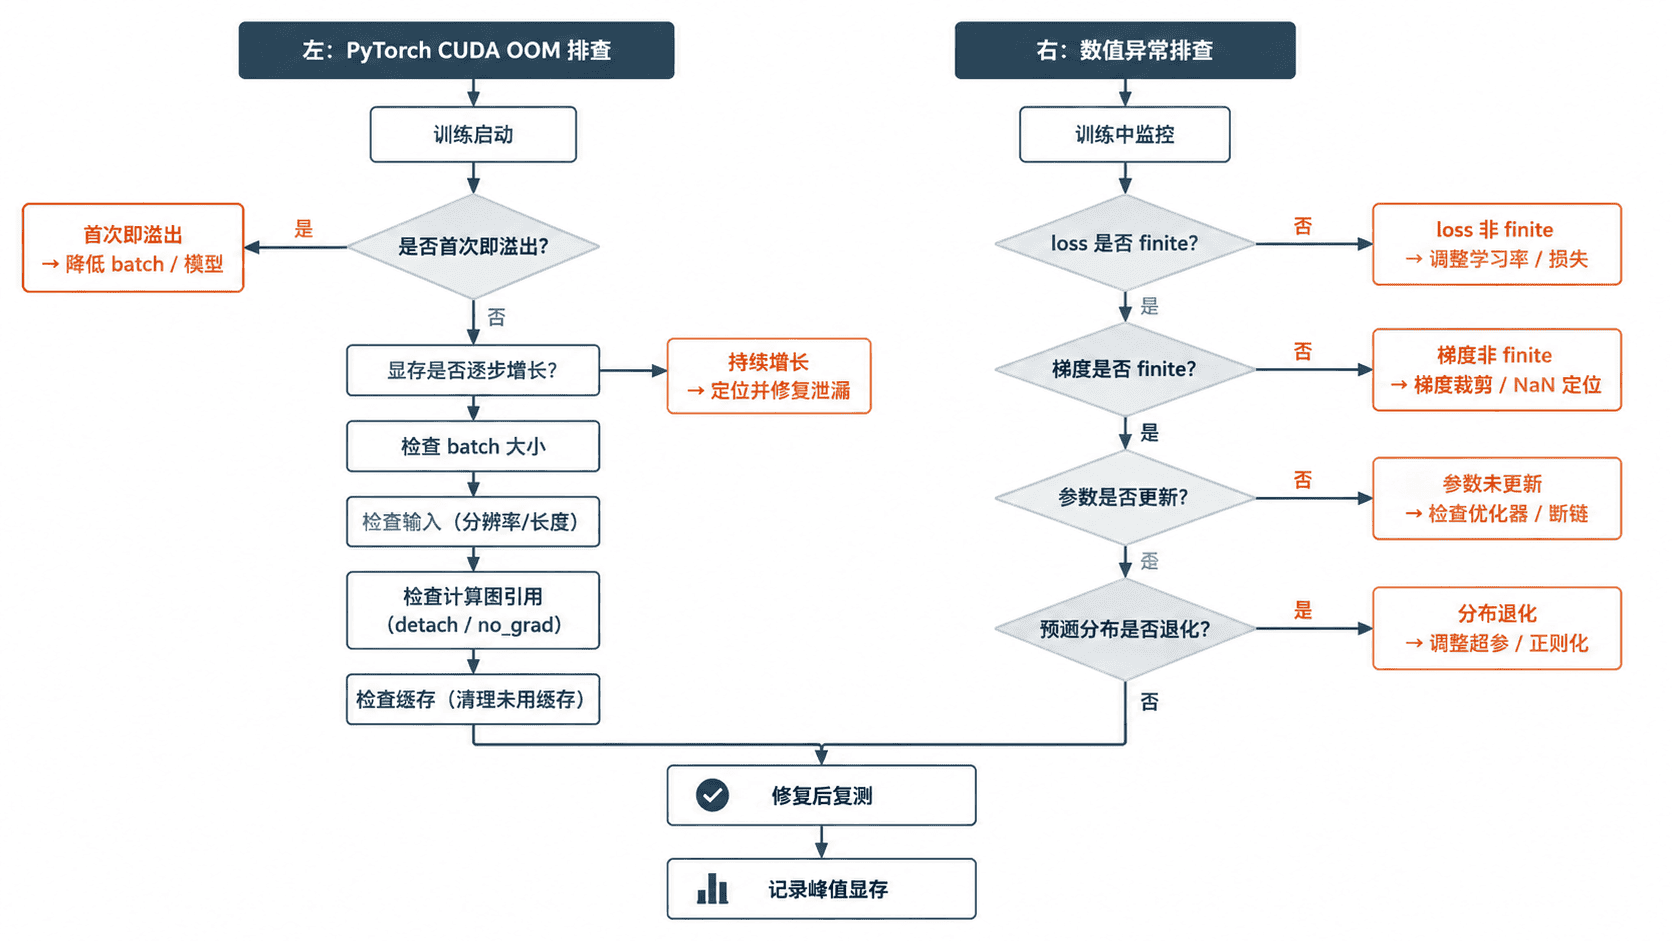
本课把显存不足与数值异常拆成两条诊断链路:先判断资源是否被持续占用,再检查损失、梯度和预测值是否有限,从而找到真正的泄漏点或不稳定算子。
学习目标
- 区分单批次显存不足与训练过程持续增长
- 定位计算图未释放、损失无穷和梯度异常
- 使用有限性检查、梯度裁剪和资源清理验证修复
先区分显存峰值和持续增长
单批次刚开始就 OOM,通常说明模型、输入尺寸或批量大小超过显存容量;训练若前几步正常、显存却逐步升高,通常是保存了仍连接计算图的张量。两类问题的修复方向不同,不能只靠反复调用 empty_cache()。
| 现象 | 高概率原因 | 优先动作 |
|---|---|---|
| 第一批就 OOM | 批量过大、输入过大、模型过大 | 降低 batch size 或输入尺寸 |
| 每一步显存都增加 | 将 loss、输出或中间张量直接存入列表 |
保存 detach() 后的值 |
loss 为 inf 或 nan |
学习率过高、非法运算、半精度溢出 | 检查输入范围与首个非有限算子 |
| 梯度长期为零 | 参数被冻结、图被截断、激活饱和 | 检查 requires_grad 与梯度统计 |
| 预测恒定 | 权重未更新、预处理错误、类别极不平衡 | 对比更新前后参数与输入分布 |
定位计算图是否被意外保留
最常见的泄漏不是 Python 变量数量增加,而是列表或累计变量仍持有计算图。例如 history.append(loss) 会让每一步的反向图都无法释放。记录日志时应使用 loss.detach().item(),保存预测结果时应先 detach(),必要时再移动到 CPU。
torch.cuda.empty_cache() 只会释放缓存分配器中当前未被张量占用的显存,不能释放仍被变量引用的张量。若显存持续上升,应先寻找活跃引用,而不是把清缓存当作根因修复。
在训练步骤中检查有限性
下面的完整示例在更新参数前检查损失和梯度是否有限,并使用 set_to_none=True 降低无效梯度写入,最后删除不再需要的中间张量。
import gc
import torch
from torch import nn

torch.manual_seed(7)
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

model = nn.Sequential(
    nn.Linear(8, 16),
    nn.ReLU(),
    nn.Linear(16, 3),
).to(device)
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)
criterion = nn.CrossEntropyLoss()

inputs = torch.randn(32, 8, device=device)
targets = torch.randint(0, 3, (32,), device=device)

optimizer.zero_grad(set_to_none=True)
logits = model(inputs)
loss = criterion(logits, targets)

if not torch.isfinite(loss):
    raise RuntimeError("loss 出现 nan 或 inf")

loss.backward()
grad_norm = torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)

if not torch.isfinite(grad_norm):
    raise RuntimeError("梯度范数出现 nan 或 inf")

optimizer.step()
loss_value = loss.detach().item()

del logits, loss
if device.type == "cuda":
    torch.cuda.empty_cache()
gc.collect()

print(f"loss_is_finite={torch.isfinite(torch.tensor(loss_value)).item()}")
print(f"grad_norm_is_finite={torch.isfinite(grad_norm).item()}")
print("optimizer_step=done")
预期输出:
loss_is_finite=True
grad_norm_is_finite=True
optimizer_step=done
具体损失值和梯度范数会随模型、数据与设备变化,因此示例只验证有限性和更新是否完成。
修复 OOM 的优先顺序
先减小批量大小,因为它最直接影响激活值显存;仍不足时再降低输入尺寸、启用混合精度、使用梯度累积或梯度检查点。每次只改一个变量,并记录峰值显存,否则无法判断是哪项措施真正生效。
推理阶段应使用 model.eval() 和 torch.inference_mode(),避免构建反向图。训练日志不要保存 GPU 张量本身,只保存标量或已转移到 CPU 的副本。多次验证后仍增长时,再检查 DataLoader、缓存容器和自定义钩子是否持有张量引用。
追踪首个非有限值
当损失为 nan 或 inf 时,从输入开始逐层检查,而不是只在最终损失处加一个极小值。常见根因包括除零、对非正数取对数、指数溢出、标签越界以及学习率过高。混合精度训练还应确认梯度缩放器是否正确启用。
梯度为零则先检查参数的 requires_grad,再确认前向过程中没有错误使用 detach()、.item() 或 NumPy 转换切断计算图。预测结果恒定时,应比较参数更新前后的差异,并检查输入是否经过了与训练阶段一致的归一化。
验证修复是否有效
显存问题应连续运行多个批次,观察已分配显存是否进入稳定区间;数值问题应记录损失、梯度范数和预测分布,并确认所有值持续有限。一次成功运行只能说明当前批次通过,不能证明泄漏或不稳定已经消失。