
机器学习与深度学习 / 系统课时
导数与梯度
导数与梯度
训练模型的核心不是反复“试参数”,而是根据损失函数对参数的变化方向进行更新。本课从优化角度解释导数、偏导数、梯度和链式法则,并用 PyTorch 验证一次完整的梯度计算。
学习目标
- 理解导数、偏导数和梯度分别描述什么变化
- 掌握梯度下降为什么沿负梯度方向更新参数
- 通过链式法则解释 PyTorch 反向传播的计算结果
从参数优化看导数
当模型只有一个参数 时,导数描述损失函数在当前位置随 变化的速度。导数为正,增大 会让损失上升;导数为负,增大 会让损失下降;导数接近零,表示当前位置可能接近极值点。
以单个样本为例,预测值为 ,目标值为 ,平方误差可以写成:
它对参数 的导数为:
这个结果同时包含误差大小和输入大小,因此相同误差在不同输入尺度下会产生不同更新幅度。
偏导数与梯度
实际模型通常包含大量参数。对某一个参数求变化率得到偏导数,把所有参数的偏导数组合起来,就得到梯度向量:
梯度指向损失增长最快的方向,因此最小化损失时要向负梯度方向移动。梯度的每个分量,都对应一个参数应该如何调整。
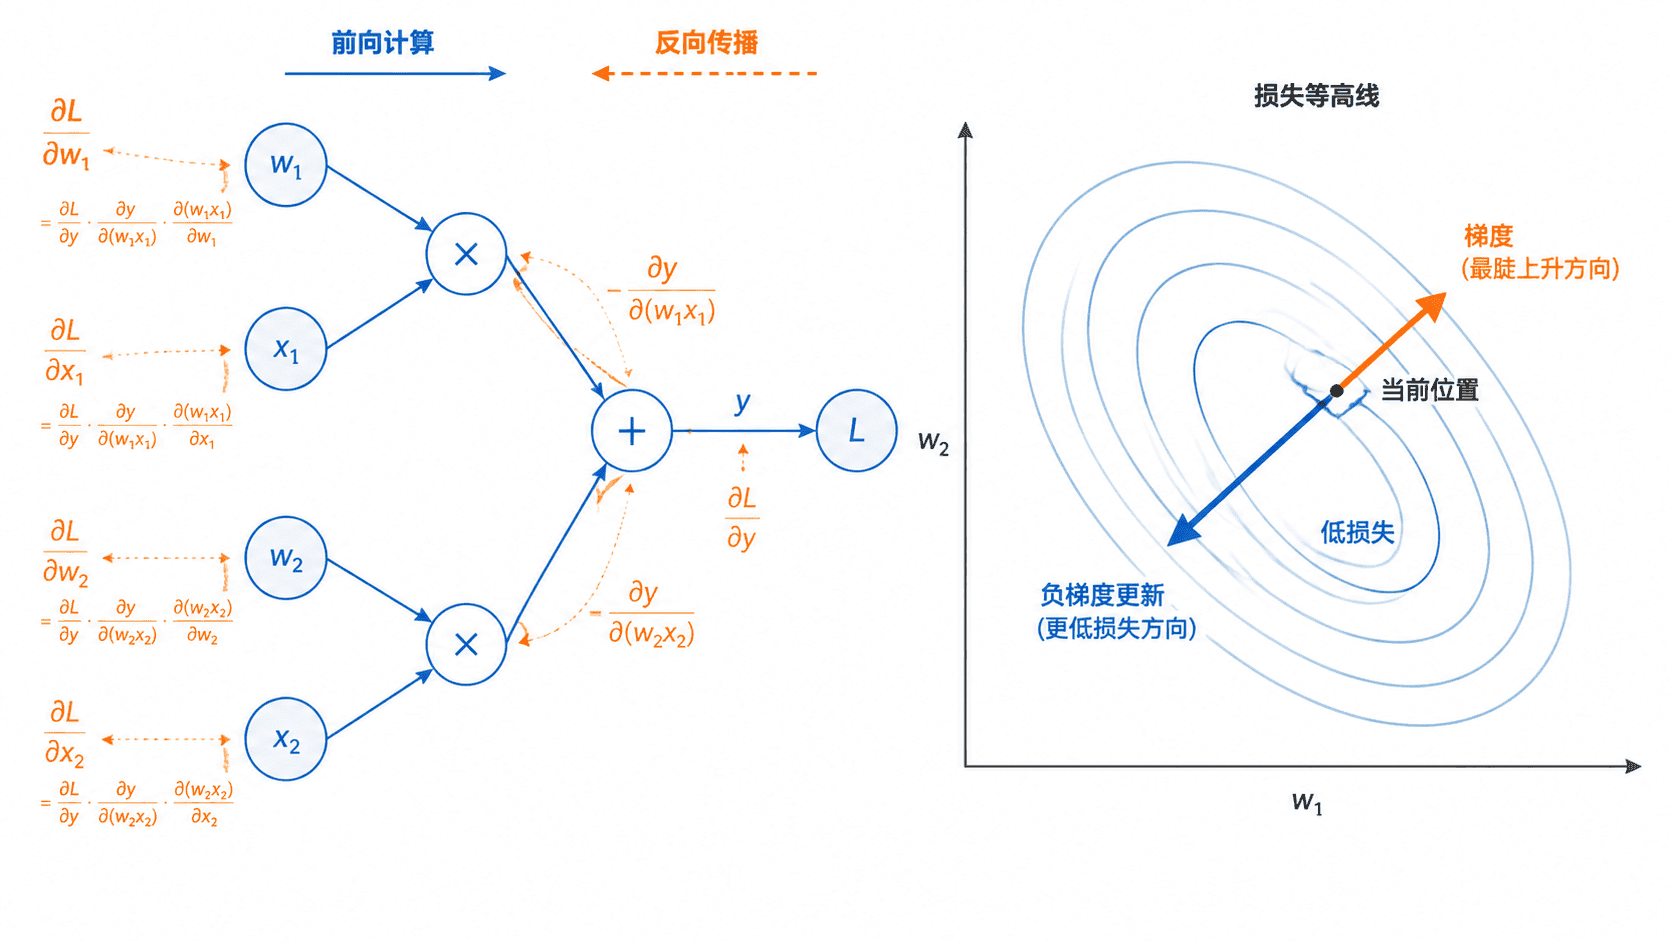
链式法则连接整个计算过程
神经网络的损失通常由多层运算得到。链式法则把“最终损失对中间结果的变化率”和“中间结果对参数的变化率”相乘,从而得到最终损失对参数的梯度。
若先计算 ,再计算 ,则有:
PyTorch 会在前向计算时记录这些运算关系,调用 backward() 后再按相反顺序应用链式法则,因此开发者不必手工展开每一层导数。
用 PyTorch 验证梯度
下面使用两个参数完成一次前向计算和反向传播。为了便于核对,输入、目标值和预期梯度都选择为可手算的数值。
import torch

def main() -> None:
    w = torch.tensor([2.0, -1.0], requires_grad=True)
    x = torch.tensor([3.0, 4.0])
    target = torch.tensor(5.0)

    # y = 2×3 + (-1)×4 = 2
    y = (w * x).sum()
    loss = (y - target) ** 2

    # 根据计算图反向求出 loss 对 w 的梯度
    loss.backward()

    print(f"y = {y.item():.1f}")
    print(f"loss = {loss.item():.1f}")
    print("gradient =", w.grad.tolist())

if __name__ == "__main__":
    main()
预期输出
y = 2.0
loss = 9.0
gradient = [-18.0, -24.0]
这里 ,所以梯度为 。结果与 PyTorch 输出一致,说明 backward() 正确应用了链式法则。
梯度如何驱动参数更新
梯度下降的基本更新规则是:
其中 是学习率。减号表示沿负梯度方向移动;学习率过大可能越过低点并导致震荡,过小则会让训练非常缓慢。
PyTorch 的梯度默认会累加到 .grad。如果在循环中多次调用 backward(),通常要在下一次反向传播前执行优化器的 zero_grad(),否则本轮梯度会与上一轮相加。这是训练代码中最常见的梯度使用边界之一。