
机器学习与深度学习 / 系统课时
分析训练性能
分析训练性能
训练变慢时,先测量各阶段耗时,而不是立即修改 batch size 或模型结构。本课将把一次训练迭代拆成数据等待、设备传输、前向计算、反向传播和参数更新,并根据计时结果判断优化方向。
学习目标
- 建立可重复的训练阶段计时方法
- 正确处理 CUDA 异步执行对计时结果的影响
- 根据耗时占比和设备利用率定位数据或计算瓶颈
先把耗时拆成阶段
一次训练迭代至少包含五段工作:等待 DataLoader 产生批次、把张量移动到训练设备、执行前向计算、执行反向传播,以及由优化器更新参数。只测整个 epoch,只能知道“慢”,无法知道慢在哪里。
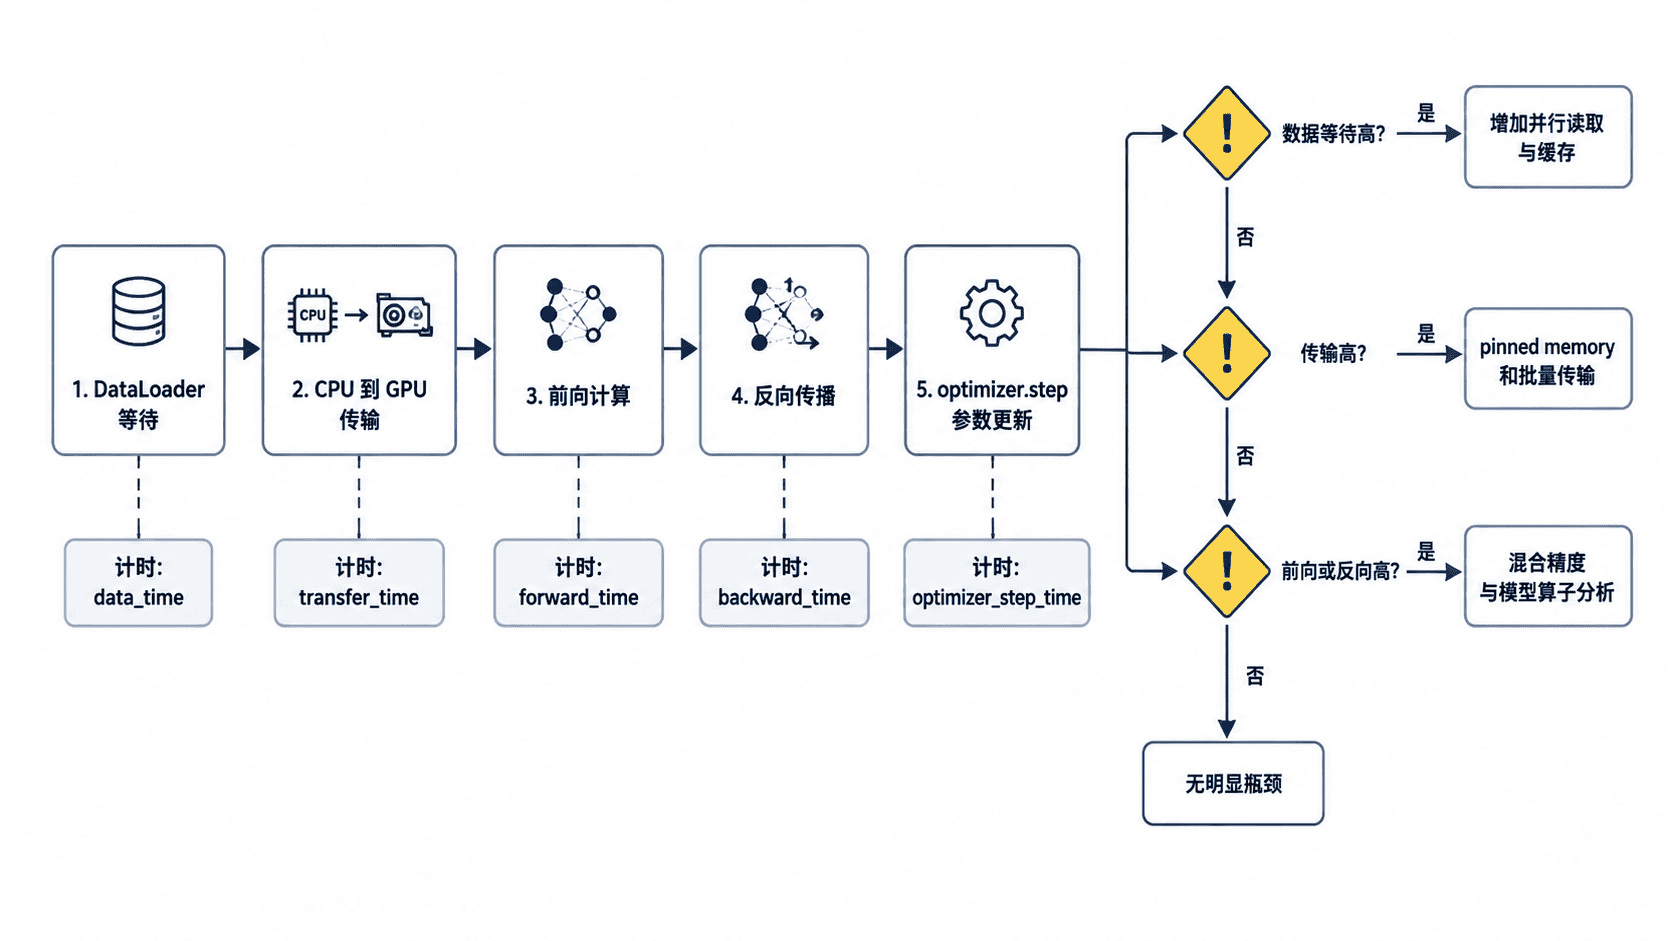
CUDA 运算默认异步提交。如果在 GPU 上直接用 time.perf_counter() 包围前向或反向代码,CPU 可能只记录提交时间。计时边界前后必须调用 torch.cuda.synchronize(),让已提交的设备任务完成后再读取时钟。
完整计时示例
下面的脚本使用合成数据运行一个小型分类模型。它先预热,再统计多个训练步骤的平均耗时;在没有 CUDA 的环境中会自动使用 CPU,因此可以直接运行。
python
import time
from collections import defaultdict

import torch
from torch import nn
from torch.utils.data import DataLoader, TensorDataset

def synchronize(device: torch.device) -> None:
    if device.type == "cuda":
        torch.cuda.synchronize(device)

def timed_call(device: torch.device, action) -> float:
    synchronize(device)
    started = time.perf_counter()
    action()
    synchronize(device)
    return (time.perf_counter() - started) * 1000

def main() -> None:
    torch.manual_seed(7)
    device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

    features = torch.randn(4096, 256)
    labels = torch.randint(0, 10, (4096,))
    loader = DataLoader(
        TensorDataset(features, labels),
        batch_size=128,
        shuffle=True,
        num_workers=0,
        pin_memory=device.type == "cuda",
    )

    model = nn.Sequential(
        nn.Linear(256, 512),
        nn.ReLU(),
        nn.Linear(512, 10),
    ).to(device)
    optimizer = torch.optim.AdamW(model.parameters(), lr=1e-3)
    criterion = nn.CrossEntropyLoss()
    totals = defaultdict(float)
    measured_steps = 20

    iterator = iter(loader)
    for step in range(measured_steps + 3):
        # 单独测量下一批数据准备完成前的等待时间。
        batch_holder = {}
        data_ms = timed_call(
            device,
            lambda: batch_holder.update({"batch": next(iterator)}),
        )
        batch_features, batch_labels = batch_holder["batch"]

        moved = {}
        transfer_ms = timed_call(
            device,
            lambda: moved.update(
                {
                    "x": batch_features.to(device, non_blocking=True),
                    "y": batch_labels.to(device, non_blocking=True),
                }
            ),
        )
        x, y = moved["x"], moved["y"]

        optimizer.zero_grad(set_to_none=True)
        forward_holder = {}
        forward_ms = timed_call(
            device,
            lambda: forward_holder.update({"loss": criterion(model(x), y)}),
        )
        loss = forward_holder["loss"]
        backward_ms = timed_call(device, loss.backward)
        update_ms = timed_call(device, optimizer.step)

        # 前三步用于预热,不纳入平均值。
        if step >= 3:
            totals["data"] += data_ms
            totals["transfer"] += transfer_ms
            totals["forward"] += forward_ms
            totals["backward"] += backward_ms
            totals["update"] += update_ms

    print("device:", device.type)
    for name in ("data", "transfer", "forward", "backward", "update"):
        print(f"{name}: {totals[name] / measured_steps:.3f} ms")

if __name__ == "__main__":
    main()
预期输出格式如下,具体时间会随硬件和系统负载变化:
text
device: <cpu|cuda>
data: <TIME> ms
transfer: <TIME> ms
forward: <TIME> ms
backward: <TIME> ms
update: <TIME> ms
该示例适合回答“时间主要花在哪个阶段”。需要继续定位某个算子时,再使用 torch.profiler 查看 CPU 时间、CUDA 时间、调用次数和张量形状,避免一开始就收集过多分析数据。
根据结果定位瓶颈
| 主要现象 | 更可能的瓶颈 | 优先验证 |
|---|---|---|
data 明显最高,GPU 经常空闲 |
数据读取或预处理 | 提高 num_workers、缓存数据、减少 Python 级变换 |
transfer 占比高 |
主机到设备传输 | 启用 pin_memory、使用 non_blocking=True、减少小批次传输 |
forward 与 backward 高 |
模型计算或显存带宽 | 尝试混合精度、检查输入尺寸、用 profiler 找热点算子 |
update 高 |
参数量或优化器状态较大 | 比较优化器、减少可训练参数、检查分布式通信 |
阶段耗时必须结合设备利用率解释。GPU 利用率低且 data 高,通常说明设备在等待输入;GPU 利用率持续较高且前向、反向时间占主导,则更像计算瓶颈。单次峰值没有代表性,应在完成预热后统计多个步骤,并报告平均值或分位数。
计时时还要保持实验条件一致,包括 batch size、输入形状、混合精度设置、梯度累积和 DataLoader 配置。一次只改变一个变量,否则性能变化无法归因。
按自己的节奏,确认真正理解。