
机器学习与深度学习 / 系统课时
编写单批次训练
编写单批次训练
单批次训练把一组样本完整地送过模型,并在一次参数更新中串联设备迁移、前向传播、损失计算、反向传播和优化器更新。本课将写出可直接运行的最小函数,并验证更新后的损失是否下降。
学习目标
- 说清单批次训练的固定执行顺序
- 编写包含梯度清零、反向传播和参数更新的训练函数
- 识别损失值、梯度和参数更新之间的关键边界
单批次训练的执行链路
一次训练不是简单调用模型,而是一条有严格先后关系的链路。数据与模型必须位于同一设备;损失必须由当前预测计算;梯度必须先由 backward() 生成,优化器才能根据梯度修改参数。
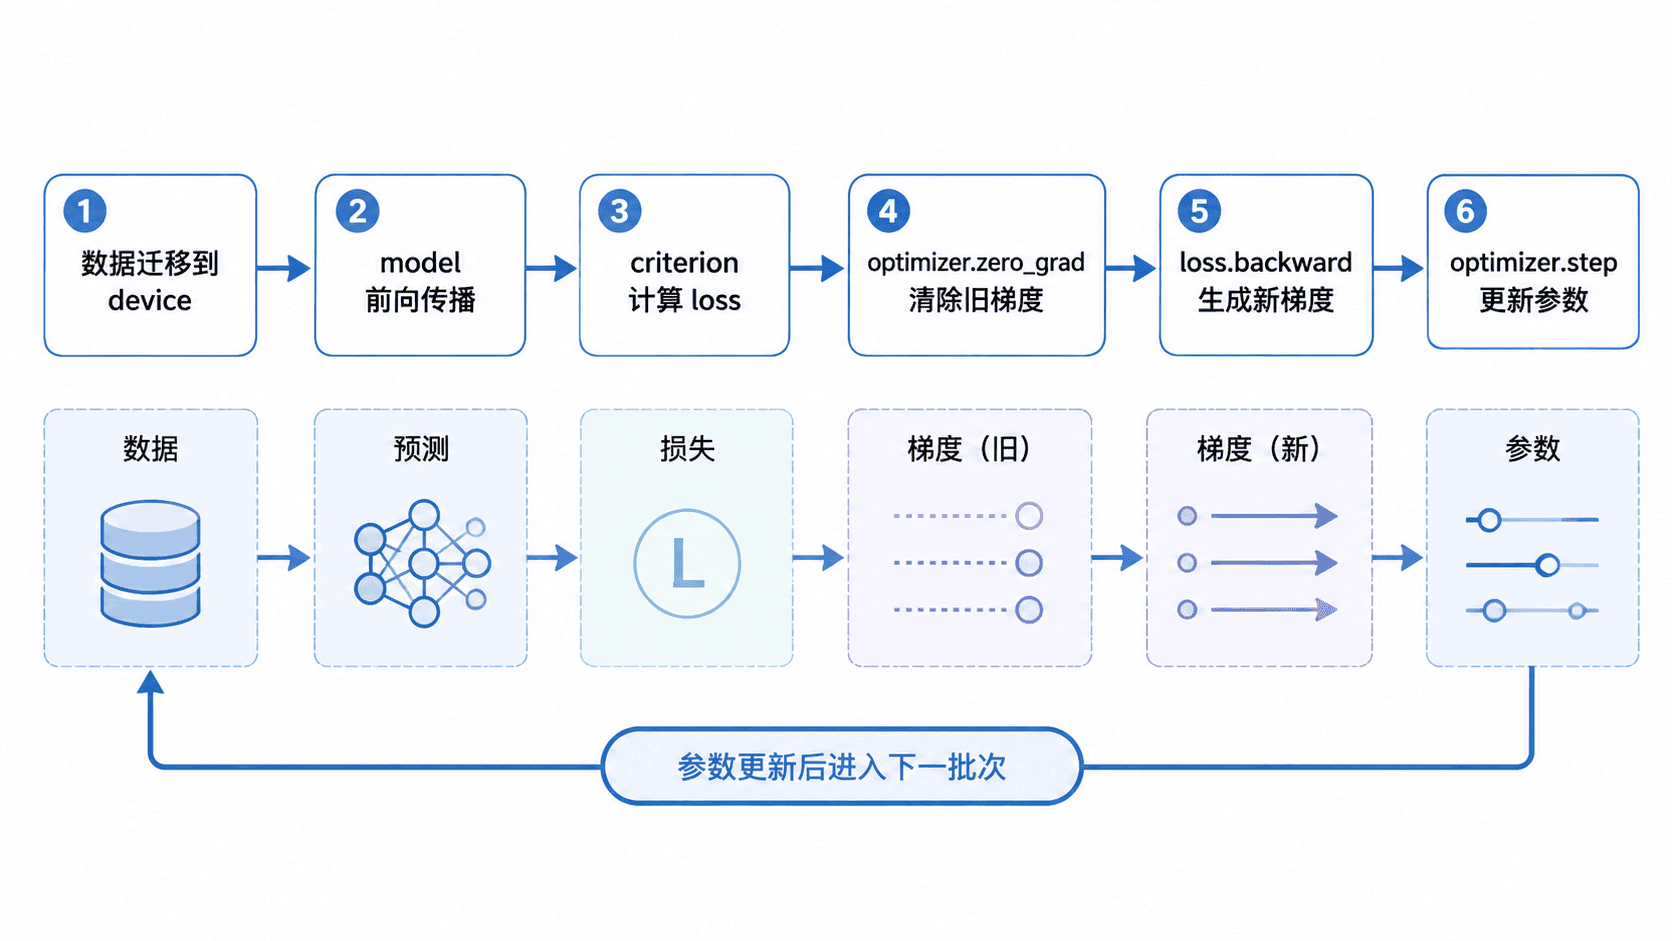
实际编码时通常把 optimizer.zero_grad() 放在前向传播之前。它只要求发生在本次 backward() 之前,提前清零能让步骤更固定,也能避免忘记清除上一批次累积的梯度。
完整实现
下面使用固定张量完成一次线性回归训练。示例强制使用 CPU,便于复现数值;迁移到 GPU 时只需把 device 改为可用的 CUDA 设备。
python
import torch

def train_one_batch(
    model,
    features,
    targets,
    criterion,
    optimizer,
    device,
):
    model.train()

    # 模型与当前批次必须位于同一设备
    features = features.to(device)
    targets = targets.to(device)

    optimizer.zero_grad()
    predictions = model(features)
    loss = criterion(predictions, targets)

    # 先生成梯度,再由优化器更新参数
    loss.backward()
    optimizer.step()
    return loss.item()

def main():
    torch.manual_seed(7)
    device = torch.device("cpu")

    model = torch.nn.Linear(2, 1).to(device)
    criterion = torch.nn.MSELoss()
    optimizer = torch.optim.SGD(model.parameters(), lr=0.01)

    features = torch.tensor([
        [1.0, 2.0],
        [2.0, 1.0],
        [3.0, 4.0],
        [4.0, 3.0],
    ])
    targets = torch.tensor([[5.0], [4.0], [11.0], [10.0]])

    loss_before_update = train_one_batch(
        model,
        features,
        targets,
        criterion,
        optimizer,
        device,
    )

    # 重新前向计算,验证更新后的参数是否更接近目标
    with torch.no_grad():
        predictions = model(features.to(device))
        loss_after_update = criterion(
            predictions,
            targets.to(device),
        ).item()

    print(f"loss_before_update={loss_before_update:.4f}")
    print(f"loss_after_update={loss_after_update:.4f}")

if __name__ == "__main__":
    main()
预期输出
text
loss_before_update=79.4523
loss_after_update=38.4272
第一次返回的损失对应参数更新前的预测,因为 loss 已在 optimizer.step() 之前完成计算。若要检查更新效果,必须像示例一样再次执行前向传播。这里更新后损失下降,说明本批次产生的梯度方向有效。
容易出错的边界
model.train() 负责把 Dropout、BatchNorm 等层切换到训练行为,但不会自动清空梯度,也不会替代 loss.backward()。梯度默认会累加,因此遗漏 optimizer.zero_grad() 会把多个批次的梯度叠在一起。
optimizer.step() 只能放在反向传播之后。若在它之后才调用 backward(),本轮参数不会使用刚计算出的梯度;若忘记调用它,损失虽然能计算,模型参数却始终不变。
按自己的节奏,确认真正理解。