
机器学习与深度学习 / 系统课时
特征提取模式
特征提取模式
特征提取模式把预训练模型当作固定的特征生成器,只替换并训练最后的任务输出层。它适合数据量较小、训练资源有限或需要快速验证方案的场景,目标是先得到稳定基线,再决定是否继续微调主干网络。
学习目标
- 理解“冻结主干、训练新头部”的参数更新范围
- 使用 PyTorch 构建可运行的特征提取训练流程
- 验证冻结是否生效,并避开 BatchNorm 状态更新问题
特征提取的工作方式
预训练卷积网络已经学到边缘、纹理和形状等通用特征。特征提取模式保留这些参数,将原分类层替换为适合当前类别数的新层,反向传播时只更新新层参数。
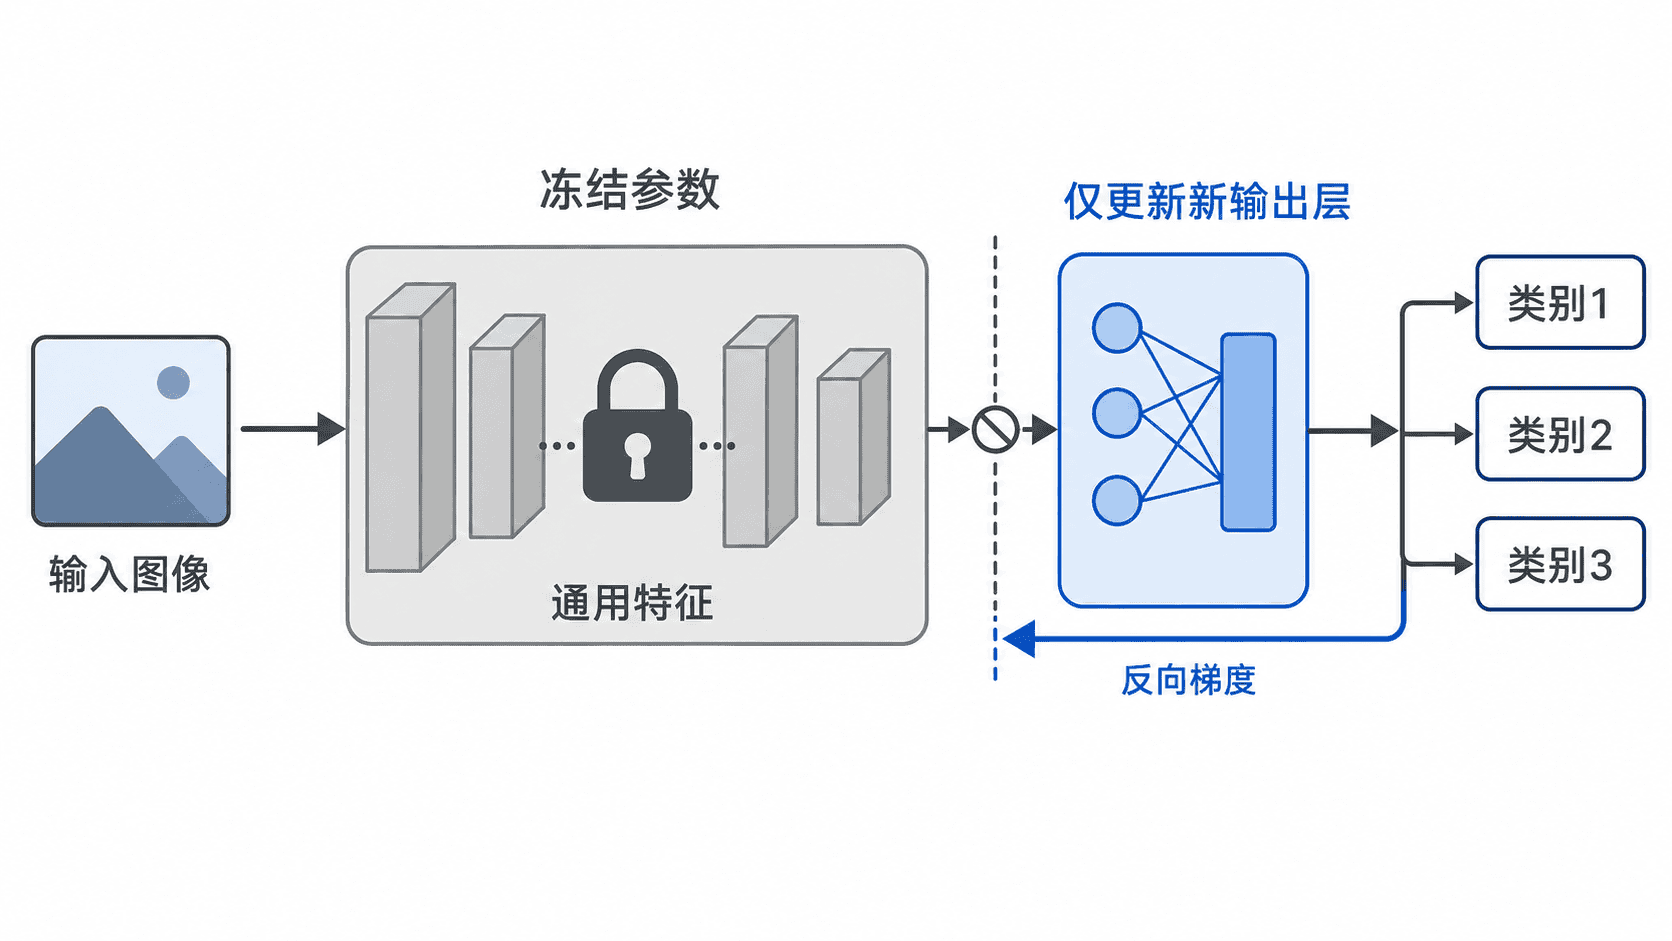
冻结参数依然参与前向计算,只是不保存可训练梯度。这样能显著减少需要优化的参数量,但如果新任务与预训练数据差异很大,固定特征可能限制模型上限。
构建可运行的基线模型
下面使用预训练 ResNet-18 和 FakeData 构建三分类示例。首次运行可能需要下载权重;训练时让整体模型保持评估模式,再单独启用新分类层,避免冻结主干中的 BatchNorm 统计量继续变化。
python
import torch
from torch import nn
from torch.utils.data import DataLoader
from torchvision.datasets import FakeData
from torchvision.models import ResNet18_Weights, resnet18

torch.manual_seed(7)

weights = ResNet18_Weights.DEFAULT
dataset = FakeData(
    size=32,
    image_size=(3, 224, 224),
    num_classes=3,
    transform=weights.transforms(),
)
loader = DataLoader(dataset, batch_size=8, shuffle=True)

model = resnet18(weights=weights)

# 先冻结原模型,再替换分类层;新创建的层默认可训练
for parameter in model.parameters():
    parameter.requires_grad = False

model.fc = nn.Linear(model.fc.in_features, 3)

optimizer = torch.optim.Adam(model.fc.parameters(), lr=1e-3)
criterion = nn.CrossEntropyLoss()

model.eval()
model.fc.train()

running_loss = 0.0
for images, labels in loader:
    optimizer.zero_grad()
    logits = model(images)
    loss = criterion(logits, labels)
    loss.backward()
    optimizer.step()
    running_loss += loss.item()

trainable_names = [
    name for name, parameter in model.named_parameters()
    if parameter.requires_grad
]

print("trainable:", trainable_names)
print("conv1_grad_is_none:", model.conv1.weight.grad is None)
print(f"epoch_loss=<{running_loss / len(loader):.4f}>")
预期输出
text
trainable: ['fc.weight', 'fc.bias']
conv1_grad_is_none: True
epoch_loss=<LOSS>
<LOSS> 会随随机初始化、硬件和依赖版本变化;关键验证结果是只有 fc.weight、fc.bias 可训练,并且主干第一层没有梯度。
判断是否需要继续微调
特征提取适合作为第一版方案:训练快、过拟合风险较低,也便于确认数据管道和标签是否正确。如果训练集与验证集都表现较差,通常说明固定特征不够匹配新任务,可以逐步解冻靠近输出端的网络层。
常见错误是只把 requires_grad 设为 False,却仍对整个模型调用 train()。这不会更新冻结权重,但会改变 BatchNorm 的运行均值和方差,导致“参数没变、模型行为却变了”。固定主干时应显式控制训练模式。
按自己的节奏,确认真正理解。