
机器学习与深度学习 / 系统课时
排查形状与设备错误
排查形状与设备错误
本课建立一套可重复的 PyTorch 运行错误定位顺序:先核对张量形状,再检查批量维度、数据类型和设备,最后用断言在模型前向传播前阻止错误扩散。
学习目标
- 根据异常信息快速判断是形状、类型还是设备问题
- 使用统一检查函数验证输入、标签和模型参数
- 修复批量维度缺失与损失函数输入不匹配
先从报错位置判断问题类型
形状与设备错误通常在第一层算子或损失函数处暴露。不要先改模型结构,应记录报错行附近每个张量的 shape、dtype 和 device,再对照该算子的输入约束。
| 典型信息 | 常见原因 | 第一检查项 |
|---|---|---|
mat1 and mat2 shapes cannot be multiplied |
全连接层输入特征数不匹配 | 最后一维与 in_features |
Expected all tensors to be on the same device |
模型、输入或标签分布在不同设备 | 三者的 device |
expected scalar type Long but found Float |
分类标签类型错误 | 标签是否为 torch.long |
Dimension out of range |
维度索引不存在或批量维度缺失 | 实际维数与 dim 参数 |
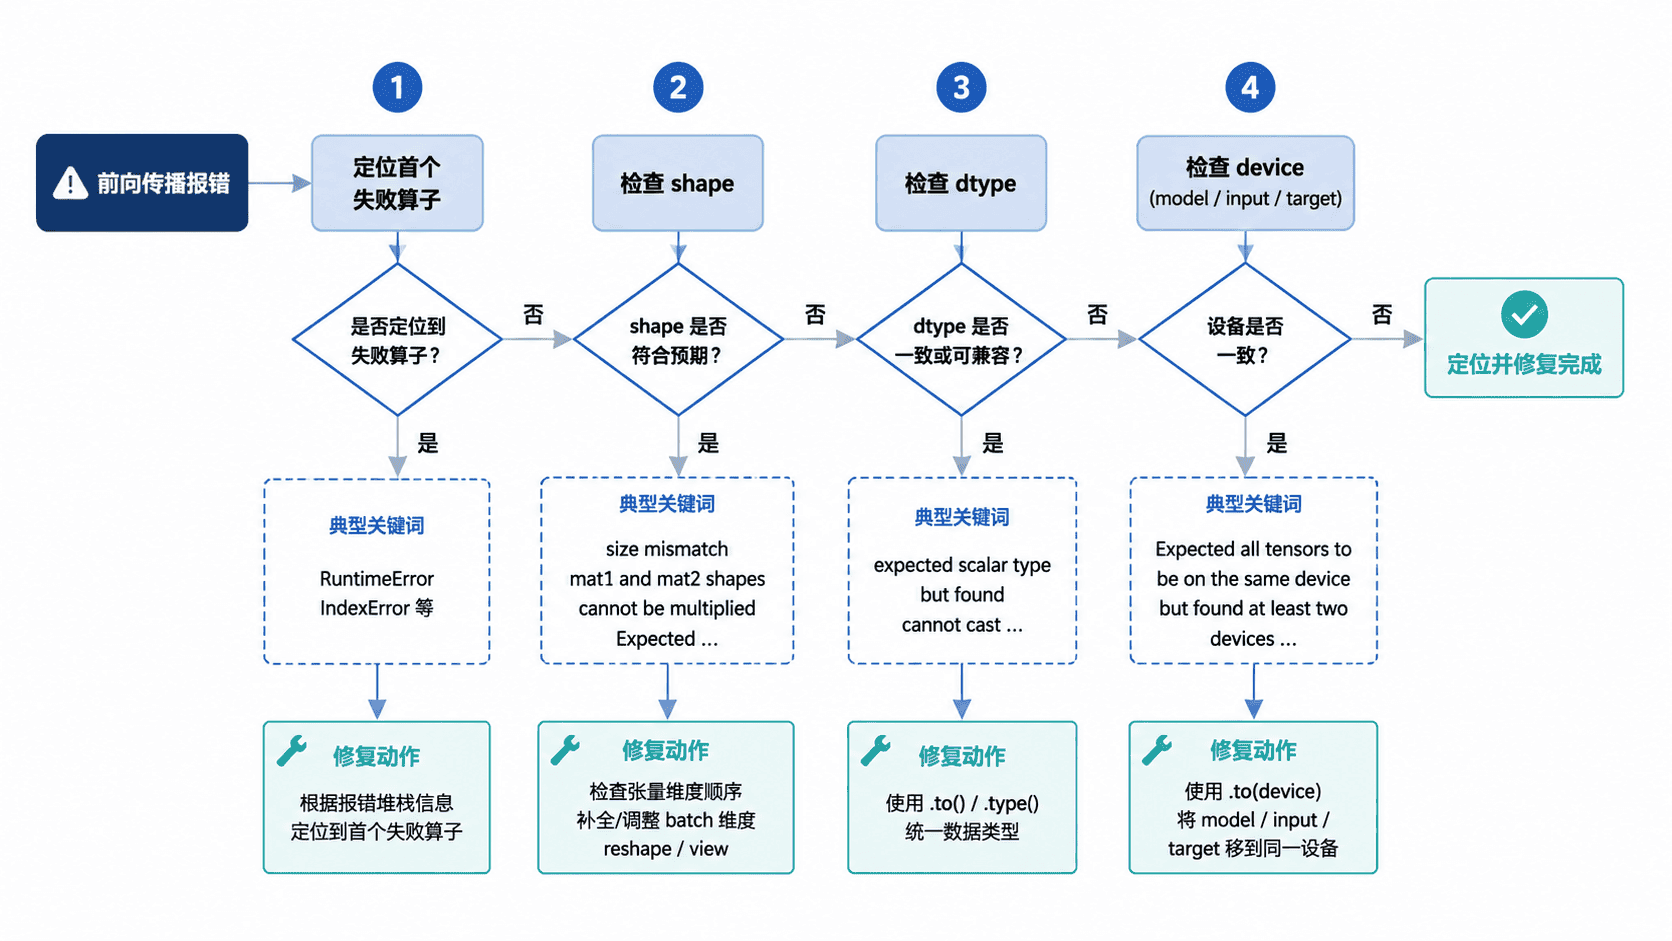
按固定顺序打印四类信息
先确认输入的语义,再确认数值属性。图像分类输入通常是 [N, C, H, W],序列模型常见 [N, L, D],全连接层只约束最后一维。标签形状则由损失函数决定,例如 CrossEntropyLoss 通常接收 [N, C] 的 logits 和 [N] 的整数标签。
下面的完整示例先主动拦截错误形状,再修正输入并完成前向传播。
import torch
from torch import nn

def validate_batch(x: torch.Tensor, model: nn.Linear) -> None:
    print(f"shape={tuple(x.shape)}, dtype={x.dtype}, device={x.device}")
    if x.ndim != 2:
        raise ValueError(f"期望二维批量输入,实际 ndim={x.ndim}")
    if x.shape[-1] != model.in_features:
        raise ValueError(
            f"最后一维应为 {model.in_features},实际为 {x.shape[-1]}"
        )
    if x.dtype != model.weight.dtype:
        raise TypeError(f"输入类型 {x.dtype} 与参数类型 {model.weight.dtype} 不一致")
    if x.device != model.weight.device:
        raise RuntimeError(f"输入位于 {x.device},模型位于 {model.weight.device}")

model = nn.Linear(4, 2)
wrong_x = torch.randn(3, 5)

try:
    validate_batch(wrong_x, model)
except ValueError as error:
    print(f"caught={error}")

fixed_x = torch.randn(3, 4, dtype=model.weight.dtype, device=model.weight.device)
validate_batch(fixed_x, model)
output = model(fixed_x)
print(f"output_shape={tuple(output.shape)}")
预期输出:
shape=(3, 5), dtype=torch.float32, device=cpu
caught=最后一维应为 4,实际为 5
shape=(3, 4), dtype=torch.float32, device=cpu
output_shape=(3, 2)
若运行环境使用 GPU,输出中的设备会变为实际设备名,但形状检查结果不变。
修复批量维度和标签类型
单个样本经常缺少批量维度。例如卷积模型期望 [N, C, H, W],单张图片只有 [C, H, W] 时,应使用 unsqueeze(0) 增加批量维度,而不是随意 reshape。后者可能改变数据语义并掩盖上游错误。
分类任务还要同时检查标签。CrossEntropyLoss 的标签通常是类别索引,因此应为 torch.long,形状一般为 [N];二分类使用 BCEWithLogitsLoss 时,目标通常与输出同形状并采用浮点类型。损失函数不同,标签规则也不同。
统一设备而不是局部搬运
推荐先确定唯一设备,再把模型、输入和标签全部移动到该设备。不要只在报错处临时调用 .cuda(),否则后续新建张量、掩码或隐藏状态仍可能落在 CPU。
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
model = model.to(device)
inputs = fixed_x.to(device)
targets = torch.tensor([0, 1, 0], dtype=torch.long, device=device)
这是片段示例,依赖前文已经创建的 model 与 fixed_x。生效后,模型参数、输入和标签位于同一设备;可分别打印它们的 device 进行验证。
用断言完成最终验证
修复后至少验证一次完整链路:输入进入模型、输出形状符合预期、损失可以计算、反向传播不再报错。建议在数据管道出口和模型入口保留轻量断言,让错误尽早暴露,而不是等到深层算子才出现难读的异常。