
机器学习与深度学习 / 系统课时
建立工程交付规范
建立工程交付规范
模型训练完成并不等于可以交付。可维护的交付物必须把代码、依赖、配置、模型、标签、日志、测试和运行说明绑定到同一个版本。本课给出一套适合 TensorFlow 项目的最小交付契约,并用清单和冒烟测试让接收方能在干净环境中复现推理。
学习目标
- 能定义包含模型、标签、配置、依赖锁定、测试、日志和运行文档的交付包。
- 能记录模型版本、代码提交、数据版本和输入契约,避免文件互相错配。
- 能用冒烟测试和发布门禁验证“安装成功、模型可加载、输入可推理、输出可解释”。
把交付物收敛成固定契约
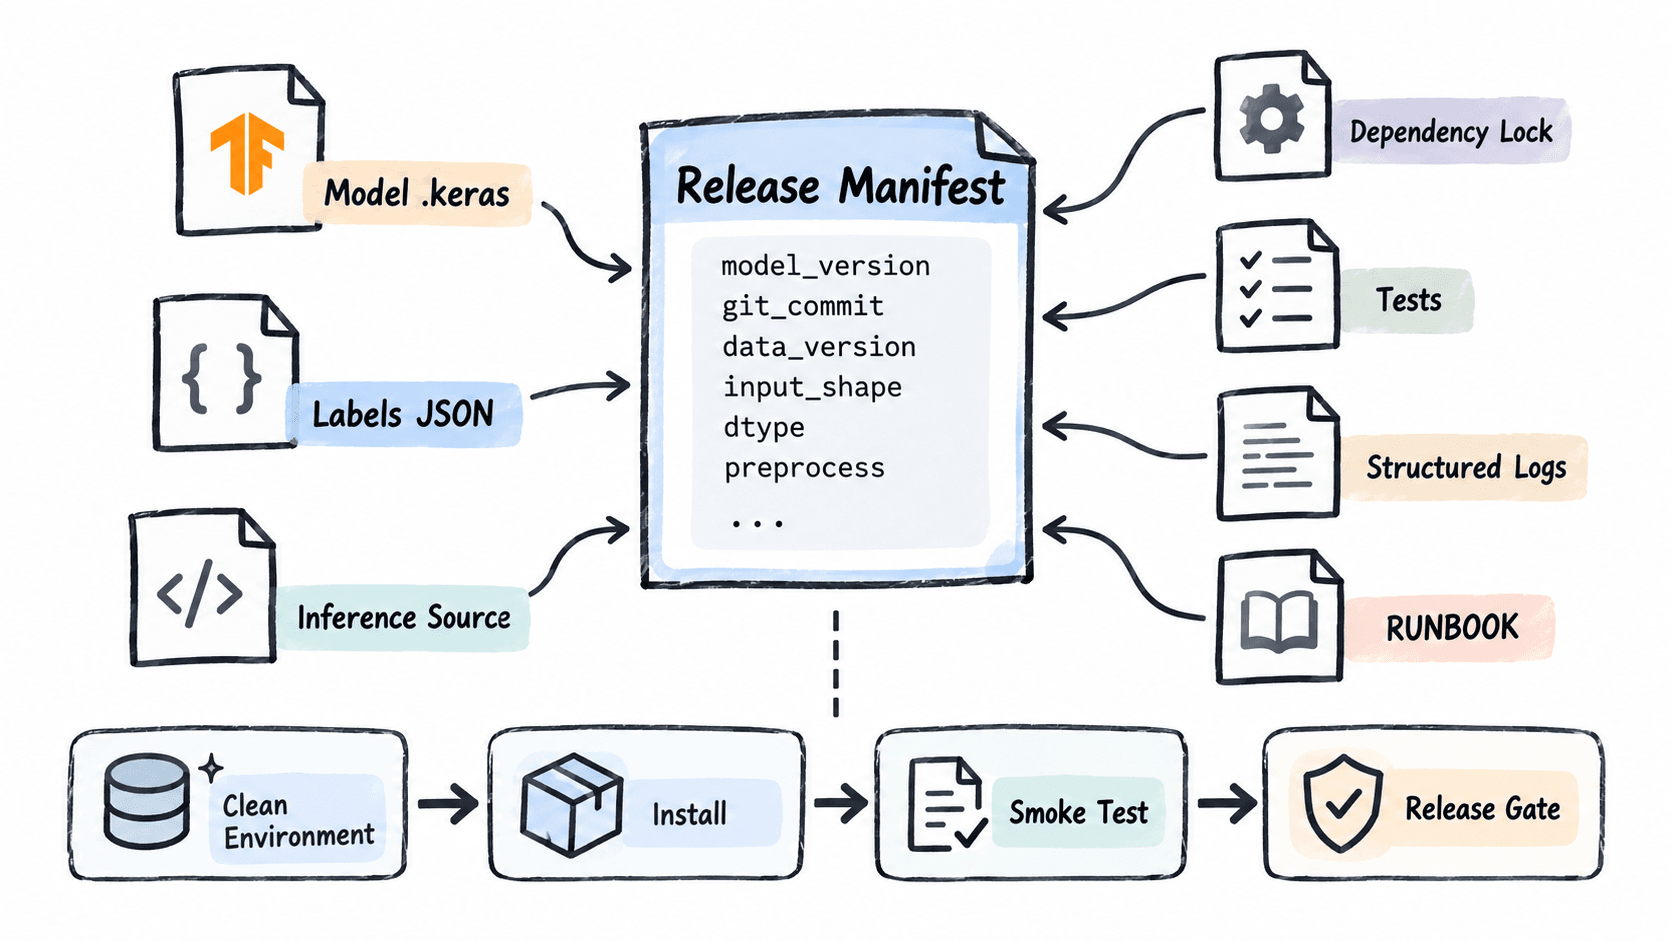
建议每个发布包至少包含八类内容:model/best-model.keras、config/labels.json(约定为类别名数组)、config/release-manifest.json、src/ 推理代码、tests/、requirements.lock.txt、README.md 或 RUNBOOK.md,以及运行后产生的结构化日志目录。目录名可以调整,但角色不要混在一起,例如不要把标签顺序只写在某个 notebook 的单元格里。
release-manifest.json 不是 Keras 强制格式,而是团队自己的交付契约。对单输入图像分类项目,至少记录模型版本、代码提交、训练数据版本、输入尺寸、dtype、预处理方式、标签文件和模型文件。模型文件与标签文件必须一起版本化,不能让接收方猜测哪一份 labels.json 与当前权重对应。
固化依赖与运行配置
依赖锁定要在已经验证通过的环境中生成,不要手写一串“差不多”的版本。使用 pip 的项目可以在已验证环境的项目根目录执行下面的命令,把已安装包及精确版本写入锁文件;版本号会随实际发布环境变化。
python -m pip freeze > requirements.lock.txt
python -c "import sys, tensorflow as tf; print(sys.version.split()[0]); print(tf.__version__)"
预期输出
<PYTHON_VERSION>
<TENSORFLOW_VERSION>
随后应在一个全新虚拟环境或 CI runner 中执行 python -m pip install -r requirements.lock.txt,确认不是依赖本机缓存或未声明包才能运行。若项目需要同时支持 Linux CPU、Linux GPU 和其他平台,不要默认一份锁文件能覆盖所有运行时,应按目标平台分别验证和保存安装结果。
配置要区分“训练期参数”和“推理契约”。训练的 epoch、优化器可以留在实验记录里;部署必须明确输入尺寸、归一化、标签顺序、阈值和模型路径。下面是一个团队可自定义的清单示例,它不是 TensorFlow 内置格式。
{
  "model_version": "2026-10-03.1",
  "git_commit": "<ID>",
  "training_data_version": "images-v4",
  "model_file": "model/best-model.keras",
  "labels_file": "config/labels.json",
  "input_shape": [224, 224, 3],
  "input_dtype": "float32",
  "preprocess": "rgb_rescale_0_1"
}
生效行为:推理程序启动时读取这份清单,而不是在源码里重复硬编码 224、标签路径和缩放规则。验证方法是故意把 input_shape 改成错误值,冒烟测试应明确失败;若仍然通过,说明配置没有真正参与运行。
用冒烟测试锁定交付行为
冒烟测试只覆盖“交付物能否被正确使用”,不要把完整训练测试集都塞进部署检查。对图像分类项目,建议至少验证四件事:模型文件存在且能加载;标签数与输出维度一致;一条 224×224×3 的 float32 输入可以推理;输出没有 NaN/Inf。下面脚本依赖前述发布目录中的模型和标签文件,是可直接放进 tests/smoke_test.py 的完整示例。
import json
from pathlib import Path

import tensorflow as tf
from tensorflow import keras

root = Path(".")
model_path = root / "model" / "best-model.keras"
labels_path = root / "config" / "labels.json"

labels = json.loads(labels_path.read_text(encoding="utf-8"))
model = keras.models.load_model(model_path, compile=False)

x = tf.zeros([1, 224, 224, 3], dtype=tf.float32)
y = model(x, training=False)

tf.debugging.assert_all_finite(y, "prediction contains NaN or Inf")
if y.shape.rank != 2 or y.shape[0] != 1:
    raise ValueError(f"unexpected output shape: {y.shape}")
if y.shape[-1] != len(labels):
    raise ValueError(
        f"output classes {y.shape[-1]} != labels {len(labels)}"
    )

print("model_loaded: True")
print("output_shape:", tuple(y.shape))
print("label_count:", len(labels))
预期输出
model_loaded: True
output_shape: (1, <CLASS_COUNT>)
label_count: <CLASS_COUNT>
<CLASS_COUNT> 是项目实际类别数。若模型包含动态尺寸、多输入或非分类输出,应把断言改成对应契约,而不是删除检查;测试的价值就在于把“接收方应该怎么调用模型”变成机器可验证的规则。
让日志、版本和文档能追到同一次发布
运行日志至少带 model_version、sample_id、推理耗时、预测类别和置信度;错误日志再记录异常类型和输入契约信息,但不要默认写入原始敏感数据。日志建议使用 JSONL,一行一条记录,便于 grep、采集器和离线分析同时处理。模型升级后,旧日志仍应能根据 model_version 找回对应清单和标签文件。
发布门禁可以固定为五项:干净环境安装成功;冒烟测试退出码为 0;20 条固定 golden samples 的类别解码符合基线;模型文件校验值与发布记录一致;RUNBOOK.md 包含启动命令、输入格式、输出字段和故障定位入口。只要其中一项失败,就不要靠口头说明“线上应该没问题”放行。
文档不要重复源码,而要写接收方必须知道的事实:支持的 Python/TensorFlow 运行环境、安装命令、启动命令、输入示例、模型与标签版本、日志位置、回滚方式。最终交付应做到新成员只拿发布包和文档,就能在干净环境安装依赖、运行冒烟测试,并明确判断结果是否通过。