
机器学习与深度学习 / 系统课时
构建特征提取模型
构建特征提取模型
特征提取模式把预训练网络当作固定的视觉编码器:输入图片先变成高维特征,再由轻量分类头学习新类别。这样既能复用预训练模型的表示能力,又能把新任务需要训练的参数压缩到很小,适合数据量有限的分类项目。
学习目标
- 会把 MobileNetV2 组装成固定特征提取器,并读懂空间特征与向量特征的形状。
- 能在特征向量后接新分类层,构成可训练的新类别识别模型。
- 能判断何时应该在线提取特征,何时适合预先缓存特征。
从图像得到可复用特征
使用 include_top=False 后,MobileNetV2 对 160×160×3 输入会输出 5×5×1280 的空间特征图。再经过 GlobalAveragePooling2D,每张图会得到长度为 1280 的向量,分类头只需学习这些向量到新类别的映射。
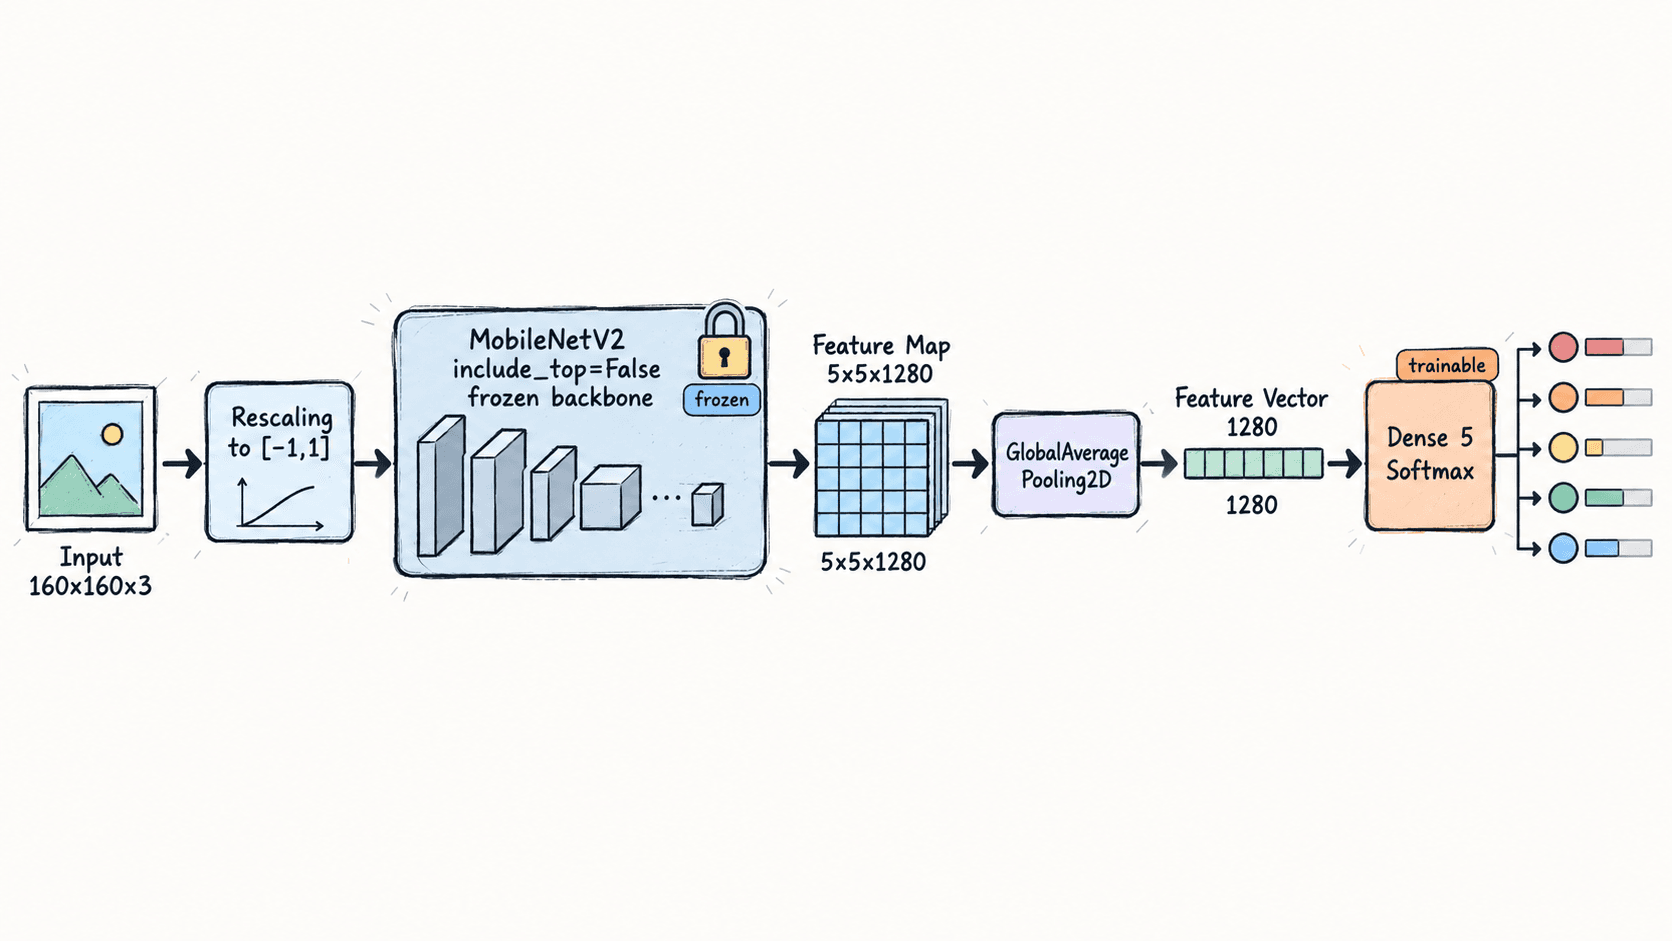
这里不要直接把 5×5×1280 展平为 32000 维再接大 Dense 层。全局平均池化只保留每个通道的响应强度,能显著减少参数量,也更符合预训练卷积网络作为通用特征编码器的用途。
组装特征提取器与分类器
下面的完整示例构建一个 5 类分类模型,同时额外暴露 feature_extractor,便于单独获取 1280 维特征。基础网络固定不训练,最终模型只有 Dense 分类层包含可训练参数。
import tensorflow as tf
from tensorflow import keras

base_model = keras.applications.MobileNetV2(
    input_shape=(160, 160, 3),
    include_top=False,
    weights="imagenet",
)
base_model.trainable = False

inputs = keras.Input(shape=(160, 160, 3), name="image")
x = keras.layers.Rescaling(1.0 / 127.5, offset=-1.0)(inputs)
x = base_model(x, training=False)
features = keras.layers.GlobalAveragePooling2D(name="features")(x)

feature_extractor = keras.Model(inputs, features, name="feature_extractor")
outputs = keras.layers.Dense(5, activation="softmax", name="classifier")(features)
model = keras.Model(inputs, outputs, name="transfer_classifier")

sample = tf.random.uniform((2, 160, 160, 3), 0, 255)
feature_batch = feature_extractor(sample, training=False)
probabilities = model(sample, training=False)

print("feature_shape =", feature_batch.shape)
print("prediction_shape =", probabilities.shape)
print(
    "probability_sum_is_one =",
    bool(tf.reduce_all(tf.abs(tf.reduce_sum(probabilities, axis=1) - 1.0) < 1e-5)),
)
print("trainable_weight_tensors =", len(model.trainable_weights))
预期输出如下;首次运行可能额外显示预训练权重下载和设备日志。
feature_shape = (2, 1280)
prediction_shape = (2, 5)
probability_sum_is_one = True
trainable_weight_tensors = 2
这四项可以作为构建验收:特征向量维度正确,输出类别数等于 5,Softmax 每行概率和约等于 1,并且只有分类层的 kernel 与 bias 可训练。
接入真实数据时检查三件事
真实项目里应先统一输入尺寸和像素范围。这个示例用 Rescaling(1/127.5, offset=-1) 把 [0,255] 映射到 [-1,1],与 MobileNetV2 的预处理约定一致;如果前面的数据管线已经做过相同缩放,就不要重复一次。
训练时建议先只训练分类头,学习率可从 1e-3 或 3e-4 起步。验证集若连续多个 epoch 不再提升,再考虑解冻基础网络后部,并把学习率降到约 1e-5;解冻后必须重新 compile()。
类别数也必须和标签编码一致。若数据集有 5 个类别,最后一层应为 Dense(5, activation="softmax"),标签可使用整数 0 到 4 并配合 sparse_categorical_crossentropy。类别数不匹配会直接造成输出维度或损失计算错误。
在线提取还是预先缓存
如果训练时还有随机翻转、随机裁剪、颜色扰动等数据增强,应让图像每个 epoch 重新经过基础网络,这样不同增强结果会产生不同特征。此时不要把特征一次性缓存成固定数组,否则随机增强只发生一次。
如果数据不会再变化,并且基础网络始终冻结,可以先批量提取 1280 维特征后保存,再单独训练轻量分类器。这样能明显减少重复卷积计算;代价是不能再使用每轮变化的数据增强,也不方便随后直接解冻基础网络微调。
可用一个简单标准判断:需要动态增强或准备微调时在线提取;基础网络长期冻结且输入固定时缓存特征。 两种方式的模型结构相同,区别只在特征计算发生在每个训练批次,还是提前一次性完成。