
机器学习与深度学习 / 系统课时
分析错误样本
分析错误样本
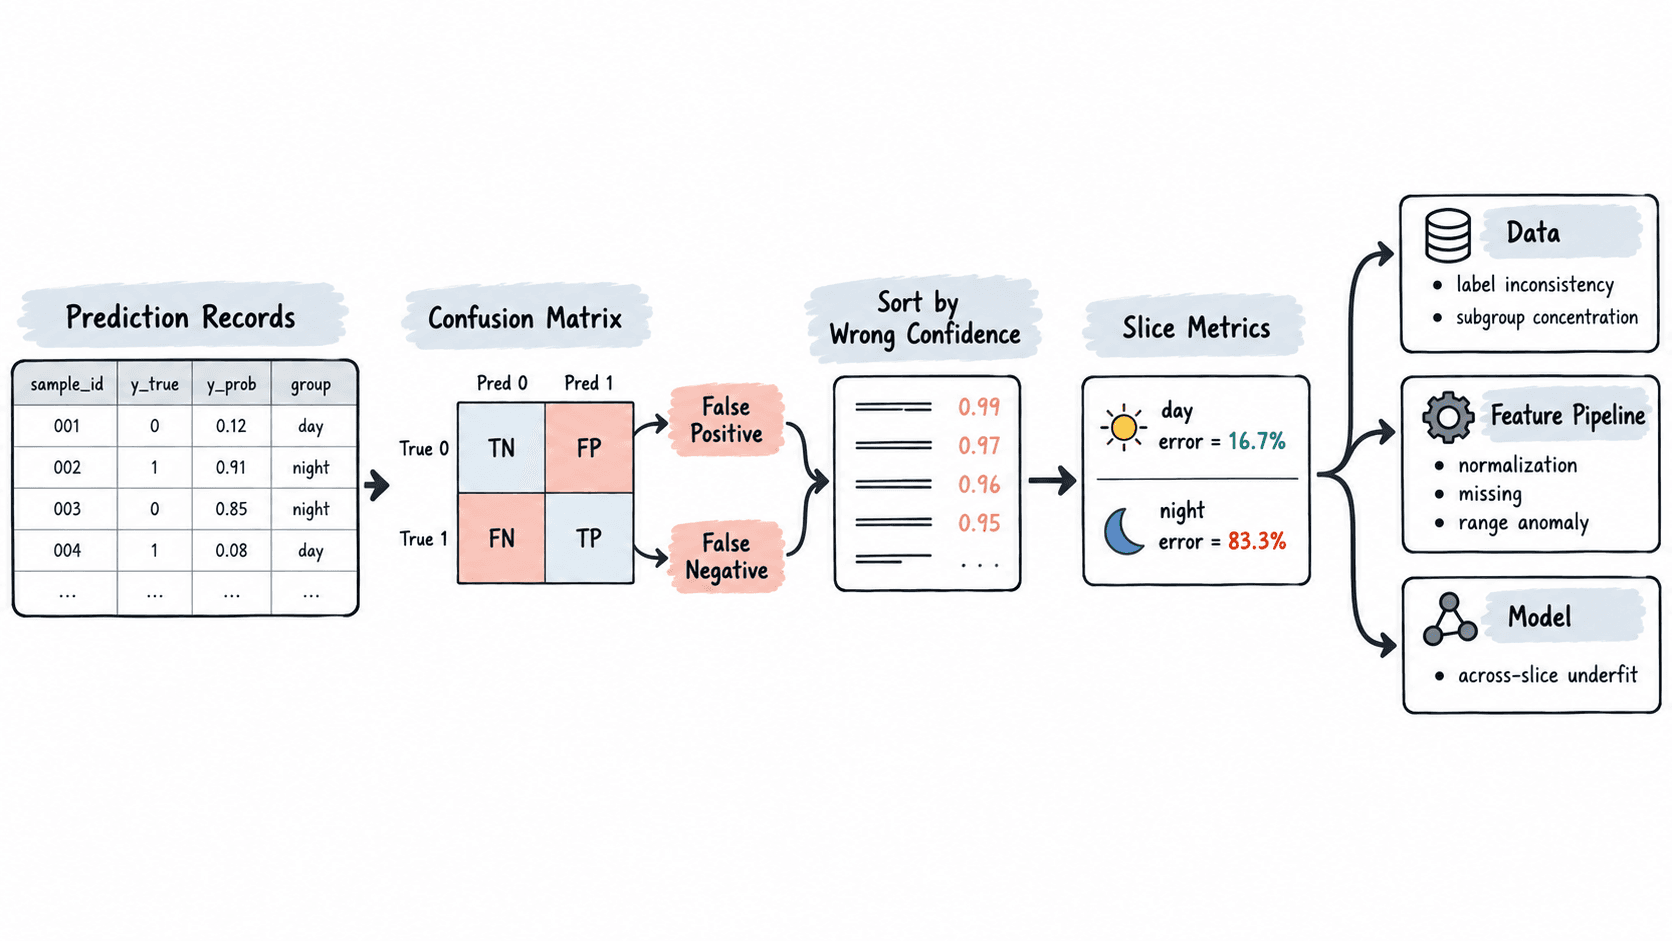
模型指标下降时,直接加层数或增加训练轮数往往找不到真正原因。本篇把预测结果拆成 False Positive、False Negative 和数据切片,先找“错得最自信”的样本,再判断问题来自标签与数据、特征处理,还是模型本身。
学习目标
- 从预测概率和真实标签定位 FP、FN 与高置信错误样本
- 按场景或数据来源切片统计错误率,识别局部数据问题
- 根据错误分布判断应优先修数据、特征还是模型结构
先保留能追溯到原样本的预测记录
错误分析至少需要 sample_id、真实标签、预测概率和一个有业务意义的切片字段,例如设备型号、拍摄条件、地区或数据来源。只保存最终 accuracy,后续无法定位究竟是哪批样本出了问题。
二分类任务先固定一个当前使用的阈值,例如 0.5,再生成混淆矩阵。然后把错误样本按“模型对错误答案的置信程度”从高到低排序,高置信错误通常比 0.49 与 0.51 附近的边界样本更值得先查。
用代码找出最值得检查的错误
下面构造 12 条预测记录。group 模拟白天与夜间两个数据切片,代码会计算混淆矩阵、列出最自信的错误,并比较两个切片的错误率。
import numpy as np
import tensorflow as tf

sample_id = np.array([
    's01', 's02', 's03', 's04', 's05', 's06',
    's07', 's08', 's09', 's10', 's11', 's12'
])
group = np.array([
    'day', 'day', 'night', 'day', 'night', 'night',
    'day', 'day', 'night', 'night', 'day', 'night'
])
y_true = np.array([0, 0, 1, 1, 0, 1, 0, 1, 0, 1, 1, 0])
y_prob = np.array([
    0.08, 0.72, 0.31, 0.81, 0.64, 0.22,
    0.15, 0.55, 0.41, 0.48, 0.91, 0.58
], dtype=np.float32)

threshold = 0.5
y_pred = (y_prob >= threshold).astype(np.int32)

cm = tf.math.confusion_matrix(
    y_true,
    y_pred,
    num_classes=2,
).numpy()
print('confusion_matrix=')
print(cm)

wrong = np.flatnonzero(y_pred != y_true)
wrong_confidence = np.where(
    y_pred[wrong] == 1,
    y_prob[wrong],
    1.0 - y_prob[wrong],
)
order = wrong[np.argsort(-wrong_confidence)]

print('top_wrong:')
for i in order[:4]:
    kind = 'FP' if y_true[i] == 0 else 'FN'
    confidence = y_prob[i] if kind == 'FP' else 1.0 - y_prob[i]
    print(
        f'{sample_id[i]} {kind} '
        f'wrong_conf={confidence:.2f} group={group[i]}'
    )

for name in ('day', 'night'):
    mask = group == name
    error_rate = np.mean(y_pred[mask] != y_true[mask])
    print(f'{name}_error={error_rate:.3f}')
预期输出:
confusion_matrix=
[[3 3]
 [3 3]]
top_wrong:
s06 FN wrong_conf=0.78 group=night
s02 FP wrong_conf=0.72 group=day
s03 FN wrong_conf=0.69 group=night
s05 FP wrong_conf=0.64 group=night
day_error=0.167
night_error=0.833
总混淆矩阵看起来正负错误各有 3 个,但切片后会发现夜间错误率为 83.3%,白天只有 16.7%。这时优先检查夜间数据、预处理和特征,比先扩大网络更有针对性。
按固定顺序判断根因
错误样本不要只“看几条感觉一下”。先从高置信错误开始,每次记录错误类型和可验证假设,再统计同类问题出现次数。以 100 条错误样本为一轮审查时,可以先各抽 30 条高置信 FN、30 条高置信 FP,再补 40 条随机错误,避免只看到极端案例。
| 观察结果 | 优先检查项 | 具体动作 |
|---|---|---|
| 某切片错误率明显高,例如 night 83.3% | 数据覆盖或特征处理 | 对比该切片的样本量、缺失值、归一化范围和采集条件 |
| 高置信错误中标签明显不一致 | 标签质量 | 回查原始记录,并统计同类标注问题占比 |
| 训练集很好、验证集普遍变差 | 过拟合或分布差异 | 比较 Train/Validation 数据来源,并检查正则化 |
| Train 与 Validation 都大量出错 | 特征不足或模型欠拟合 | 先确认输入信息是否足够,再调整模型容量 |
| 错误集中在概率 0.4~0.6 | 决策边界或阈值 | 在验证集扫描阈值并观察 Precision/Recall |
例如本例中的 s06 是夜间 False Negative,模型以 0.78 的错误置信度判成负类。如果进一步发现夜间样本普遍亮度低、某个数值特征在预处理后接近常数,应先修输入流程;只有输入正常且多个数据切片都表现不足时,才有理由尝试扩大模型容量。
把错误分析做成可重复流程
一次可靠的排查顺序是:先保存预测记录,再计算整体混淆矩阵;随后分离 FP 与 FN,按错误置信度排序;接着按业务切片统计错误率;最后才把现象归到数据、特征或模型三个层级。每次修改后使用同一验证集重新跑这套流程,才能确认错误是否真的减少。
修复后不要只看整体 accuracy 是否上涨。应重新检查原来的高置信错误、受影响切片的错误率以及 FP/FN 数量;如果 night 错误率从 83.3% 降到 25%,而 day 仍保持约 16.7%,这比单纯报告一个整体指标更能说明修改解决了目标问题。