
机器学习与深度学习 / 系统课时
理解序列数据
理解序列数据
序列数据的关键不是“有很多值”,而是这些值存在先后关系,且每个样本的步数可能不同。本篇用文本与时间序列说明顺序依赖、变长批处理、Padding 与 Mask 的边界,并用 TensorFlow 把不同长度的序列整理成可训练张量。
学习目标
- 判断一个任务是否真的依赖样本顺序,而不是只依赖元素集合。
- 理解变长序列为什么需要 RaggedTensor、Padding 或 Mask。
- 能为一个批次确定序列长度、填充值和截断策略。
顺序为什么不能随便打乱
文本“用户取消订单”和“订单取消用户”包含近似相同的词,但顺序改变后语义已经不同。时间序列也一样:温度连续三小时为 18→22→25 表示升温,而 25→22→18 表示降温。模型若忽略位置,只统计出现过哪些值,就会丢失趋势和前后依赖。
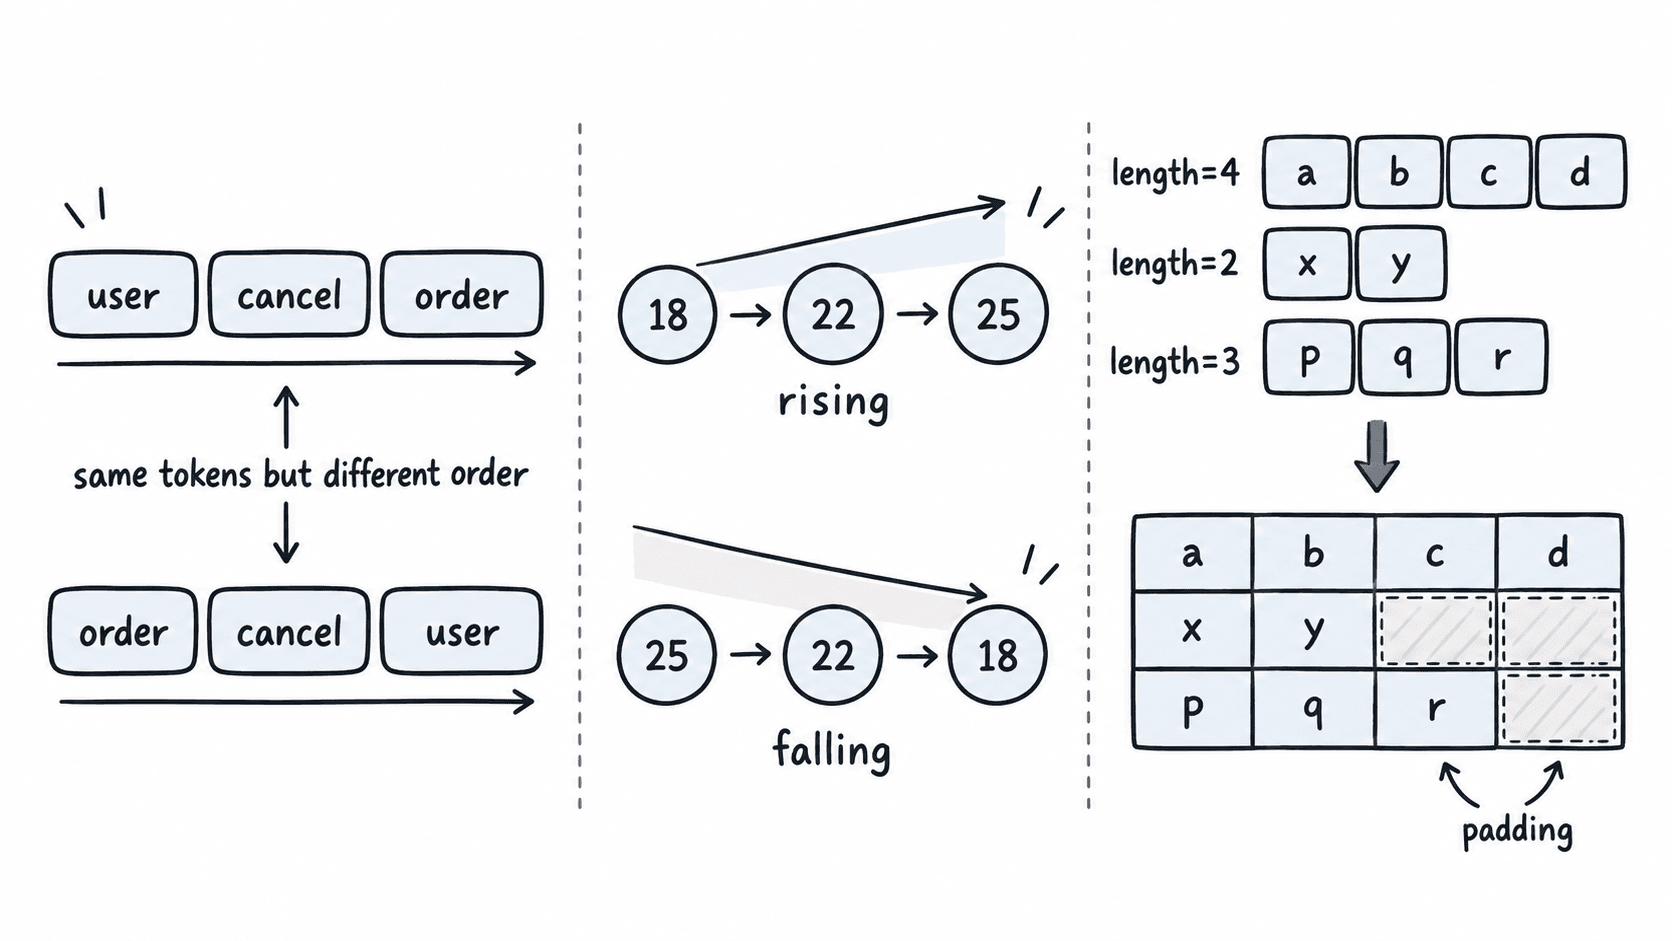
判断是否属于序列任务时,可以直接问两个问题:交换两个时间步后标签或含义会不会变化;不同样本是否可能有不同步数。只要前一个答案为“会”,模型就需要保留顺序;后一个答案为“会”,批处理时还必须处理长度差异。
把变长样本放进同一批次
TensorFlow 可以先用 tf.RaggedTensor 保存不等长序列,再按批次需要转成致密张量。下面三条整数序列长度分别为 4、2、3,转为 dense 后用 0 补齐到当前批次最大长度 4。
import tensorflow as tf

sequences = tf.ragged.constant([
    [10, 20, 30, 40],
    [5, 8],
    [7, 9, 11],
])

print("lengths:", sequences.row_lengths().numpy().tolist())

padded = sequences.to_tensor(default_value=0)
print("shape:", list(padded.shape))
print("padded:", padded.numpy().tolist())
预期输出:
lengths: [4, 2, 3]
shape: [3, 4]
padded: [[10, 20, 30, 40], [5, 8, 0, 0], [7, 9, 11, 0]]
RaggedTensor 适合在预处理阶段保留真实长度;真正送入只接受规则张量的层之前,通常仍要转为固定宽度。若训练设定 max_length=128,长度 73 的样本应补 55 个位置,而长度 160 的样本必须按明确规则截断 32 个位置。
Padding 与 Mask 要同时设计
Padding 只是把形状补齐,Mask 才告诉支持掩码的层“这些位置不是真实数据”。文本整数索引常把 0 预留给 Padding,并在嵌入层设置 mask_zero=True;这样 RNN 等支持 Mask 的层可以跳过补齐位置,避免把大量 0 当成正常词元学习。
| 场景 | 推荐做法 | 可检查结果 |
|---|---|---|
| 句子长度多数不超过 64 | max_length=64,尾部 Padding |
批次形状为 B×64 |
| 少量超长句子达到 300 | 先看长度分布,再截断到 95%~99% 分位 | 被截断样本占比有记录 |
使用 Embedding 传播文本 Mask |
Padding ID 设为 0,mask_zero=True |
后续支持 Mask 的层收到布尔掩码 |
先确定样本、时间步和特征轴
训练前先把张量轴写清楚。单变量时间序列常用形状 B×T×1,例如 32 个样本、每段 96 个时间步、每步 1 个温度值,对应 32×96×1;文本经过整数化后常是 B×T,进入 Embedding 后才变成 B×T×D。
实际项目里可以在数据管线出口固定检查三项:批次大小 B 是否符合预期、时间步 T 是否已经按规则补齐或截断、特征维 D 是否与模型输入一致。只要这三个轴的含义明确,后续选择 RNN、1D CNN 或 Transformer 时就不会把“样本维”和“时间维”混在一起。