
机器学习与深度学习 / 系统课时
转换 TensorFlow Lite 模型
转换 TensorFlow Lite 模型
本课把 Keras 模型转换为端侧使用的 tflite 文件,再用解释器读取同一份输入,比较转换前后的数值。你将得到一个可回归的最小交付样例,并区分转换成功、推理正确和设备性能达标。
学习目标
- 转换并保存 tflite 模型
- 按解释器张量契约执行本地推理
- 用黄金输入和容差比较转换前后输出
转换流程
TensorFlow Lite 模型是面向端侧推理的 FlatBuffer 文件。转换前应确保模型使用受支持算子,并先保存可回归的黄金输入。转换成功不代表结果一定一致,必须比较输出误差与目标设备性能。
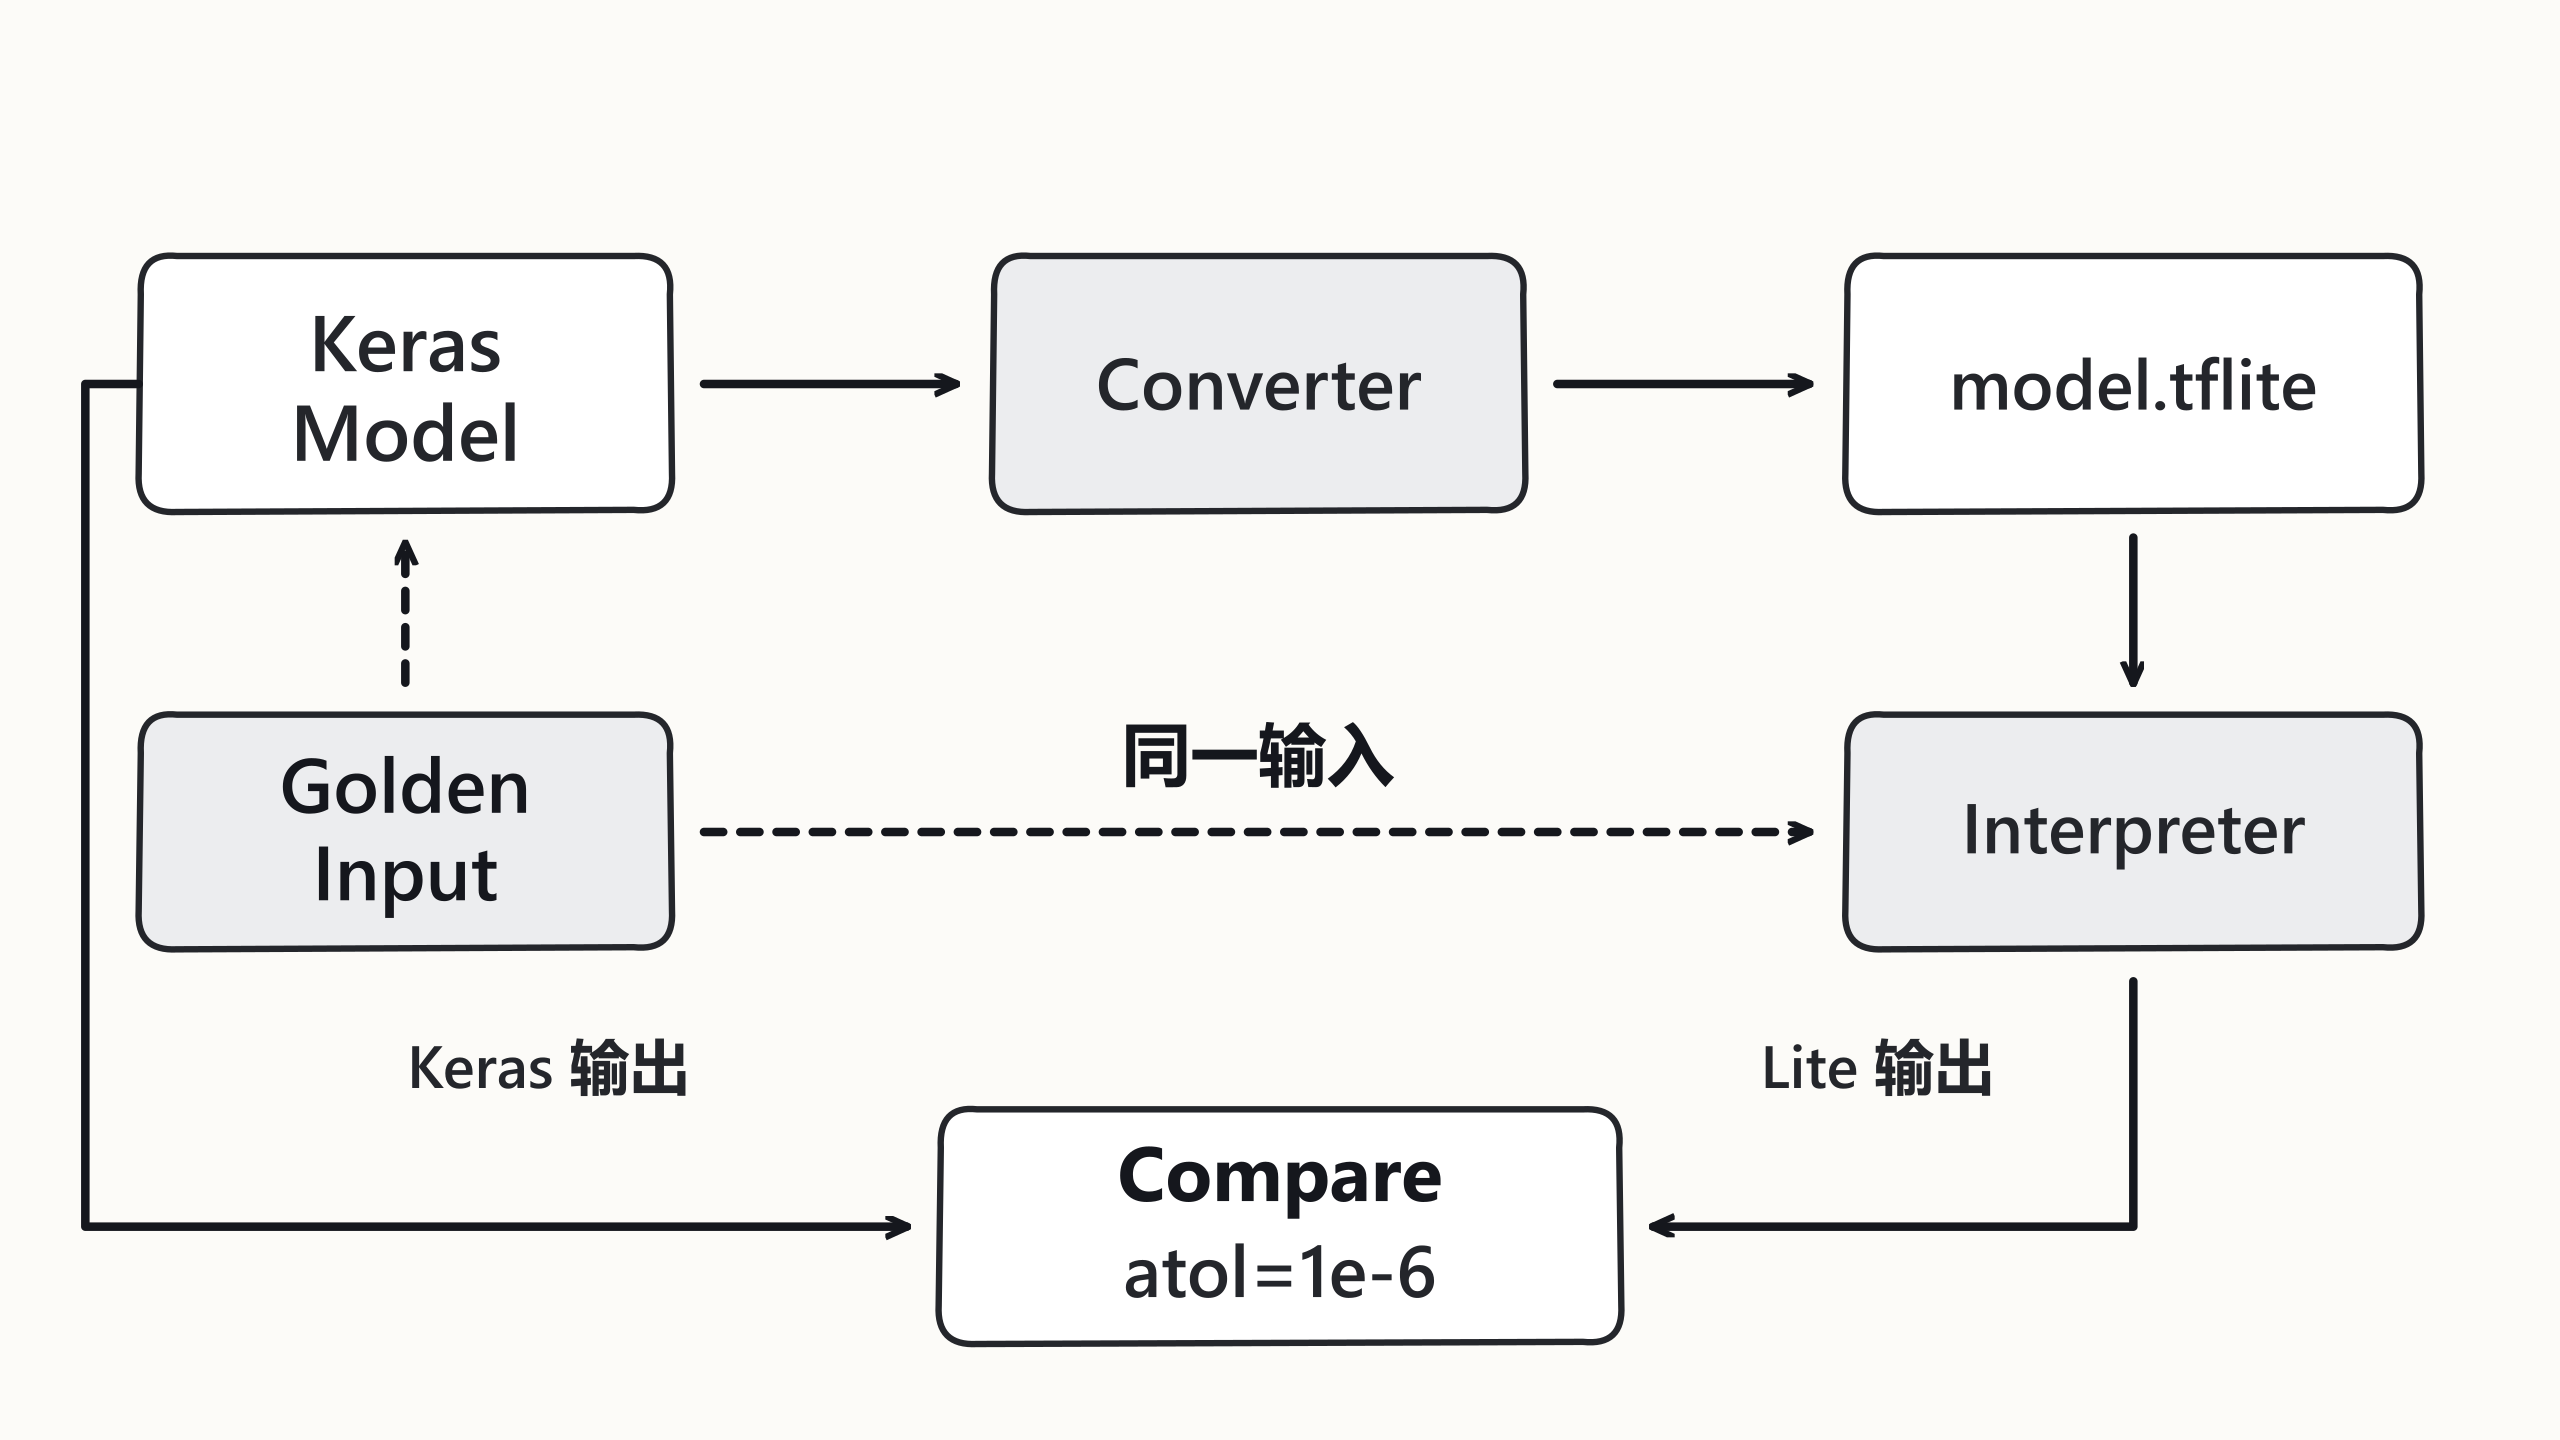
转换并运行
示例在 Windows CPU、Python 3.12、TensorFlow 2.19.1 与 Keras 3.15.1 下验证,使用 float32、不做量化。沿用 TFLiteConverter 与 tf.lite.Interpreter 接口,后者已标记弃用,新项目应核对所选版本的可用 API;迁移说明见 LiteRT 官方指南。这里固定验证旧接口的完整链路,不混用不同运行时的调用方式。
from pathlib import Path
import tempfile
import numpy as np
import tensorflow as tf

model = tf.keras.Sequential([
    tf.keras.Input(shape=(2,)),
    tf.keras.layers.Dense(1, use_bias=False)
])
# 固定权重,使输出可以手工算成两个输入之和。
model.layers[0].set_weights([np.array([[1.0], [1.0]], dtype=np.float32)])

converter = tf.lite.TFLiteConverter.from_keras_model(model)
tflite_model = converter.convert()

path = Path(tempfile.mkdtemp()) / "model.tflite"
path.write_bytes(tflite_model)

interpreter = tf.lite.Interpreter(model_path=str(path))
interpreter.allocate_tensors()

input_info = interpreter.get_input_details()[0]
output_info = interpreter.get_output_details()[0]

golden_input = np.array([[1.0, 2.0]], dtype=np.float32)
reference = model(golden_input, training=False).numpy()
interpreter.set_tensor(input_info["index"], golden_input)
interpreter.invoke()
output = interpreter.get_tensor(output_info["index"])

print("文件大小大于零:", path.stat().st_size > 0)
print("输入形状:", input_info["shape"].tolist())
print("输出:", output.tolist())
print("与原模型一致:", bool(np.allclose(output, reference, rtol=1e-6, atol=1e-6)))
预期输出:
文件大小大于零: True
输入形状: [1, 2]
输出: [[3.0]]
与原模型一致: True
模型的两个权重都是 1,因此 [1, 2] 的参考输出为 3。比较对象是同一输入在原模型上的真实结果,不能只看文件非空或打印出来像一个数字;本例容差为 1e-6,复杂网络和量化模型需按任务重新定义可接受误差。转换器可能额外输出诊断日志,关键验收是文中的四行结果。
解释器需要先 allocate_tensors,再查询实际输入输出信息。若要改变动态批次,先检查 shape_signature 是否允许,调用 resize_tensor_input 后再次分配,并重新读取张量信息;不能仅因为 Keras 接受某个形状就强行把它写入已分配的端侧张量。
量化选择
动态范围、浮点 16 位和整数化可减小体积或提高部分设备性能,但可能影响精度和算子支持。整数全量化通常需要代表性数据集校准。每种方案都要在真实设备上测量延迟、内存、能耗和精度。
端侧契约
记录输入张量索引、名称、形状、类型、量化参数和输出类别映射。移动端预处理必须与训练完全一致,并用同一批黄金样本比较 TensorFlow 与 TFLite 输出容差。
量化为整数后,输入输出的 dtype 和 scale/zero_point 可能改变,不能继续把 float32 数组直接传给整数张量。还应检查输入的颜色顺序、缩放、裁剪和标签映射;这些不一致经常比算子数值误差影响更大。
交付时保留模型文件、导出环境版本、输入输出契约和黄金样本。在目标设备上分别测冷启动与预热后的推理延迟,并记录内存;桌面解释器验证通过只能证明这份文件在当前运行时可执行,不能证明手机的委托后端或目标硬件性能已经达标。