
机器学习与深度学习 / 系统课时
理解迁移学习
理解迁移学习
迁移学习把大数据集上已经学到的特征提取能力带到新任务中,让你不必从随机权重重新学习边缘、纹理和形状。读完本课后,你能判断什么时候值得迁移、为什么先冻结再微调,以及新分类头到底在训练什么。
学习目标
- 说清预训练模型、冻结骨干网络和新任务分类头之间的关系。
- 用具体参数量理解迁移学习为什么适合中小规模数据集。
- 判断何时只做特征提取,何时再进入低学习率微调。
迁移的是特征表示而不是原标签
以 ImageNet 预训练的 MobileNetV2 为例,原模型的 1000 类标签并不是你真正要复用的部分。迁移学习通常去掉原分类头,保留卷积骨干网络,让它继续把输入图像转换成高层特征,再接上适合新任务的新输出层。
假设新任务只有 5 类、每类约 400 张图,共 2000 张。MobileNetV2 去掉顶层分类器后约有 225.8 万个参数;如果先冻结这些参数,只接 GlobalAveragePooling2D 和 5 单元 Dense,真正需要从零学习的分类头只有 6405 个参数,即 。
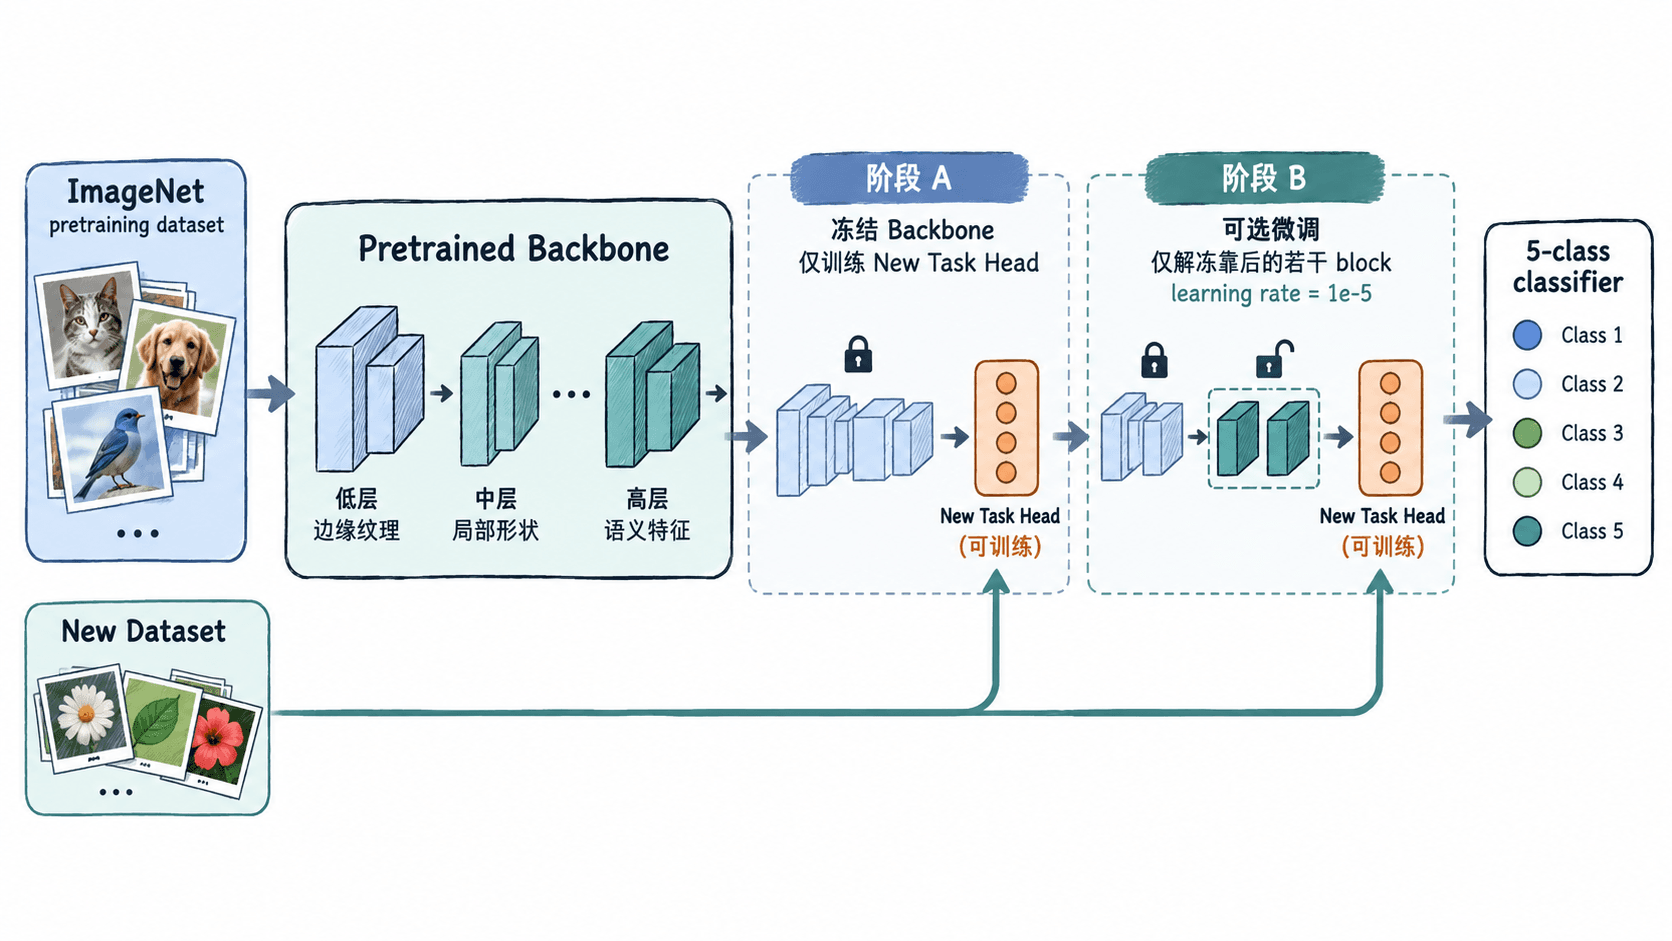
冻结阶段只更新新任务参数
冻结的含义不是“不执行骨干网络”,而是前向计算照常进行,但优化器不更新它的权重。下面的完整示例加载 ImageNet 权重,冻结 MobileNetV2,再接一个 5 类分类头;首次运行若本机没有缓存,会先下载预训练权重。
import tensorflow as tf

base_model = tf.keras.applications.MobileNetV2(
    input_shape=(160, 160, 3),
    include_top=False,
    weights="imagenet",
)
base_model.trainable = False

inputs = tf.keras.Input(shape=(160, 160, 3))
x = tf.keras.applications.mobilenet_v2.preprocess_input(inputs)
x = base_model(x, training=False)
x = tf.keras.layers.GlobalAveragePooling2D()(x)
outputs = tf.keras.layers.Dense(5, activation="softmax")(x)
model = tf.keras.Model(inputs, outputs)

trainable_params = sum(int(tf.size(w).numpy()) for w in model.trainable_weights)
print("base params:", base_model.count_params())
print("trainable params:", trainable_params)
print("output shape:", model.output_shape)
预期输出
base params: 2257984
trainable params: 6405
output shape: (None, 5)
这里的关键检查值是 trainable params: 6405。如果你冻结骨干后仍看到上百万个可训练参数,先检查 base_model.trainable = False 是否在构建和编译新模型前设置。
用数据规模和领域差异决定策略
可以先用两个问题做判断:新数据是否足够大,以及它和预训练数据是否相似。比如 2000 张日常物体照片做 5 类分类,与 ImageNet 视觉分布接近,通常先冻结骨干训练分类头;而医学影像、遥感或显微图像与自然图像差异更大,后续更可能需要微调。
| 新任务情况 | 建议起点 | 可检查的信号 |
|---|---|---|
| 约 1000~5000 张自然图像,类别与常见物体接近 | 冻结骨干,只训练新头 | 训练集和验证集都能稳定提升 |
| 数据不多,但视觉域明显不同 | 先冻结,再解冻靠后层 | 冻结阶段验证指标较早停滞 |
| 有数万张以上高质量标注且算力充足 | 比较迁移与从头训练 | 用同一验证集比较收敛速度与最终指标 |
这些数字是工程上的起点,不是硬阈值。真正决定是否继续微调的是验证集:如果分类头已经过拟合,继续解冻更多层通常不会自动解决问题;如果训练和验证都停在偏低水平,才值得逐步开放高层特征。
微调要在分类头稳定之后进行
一个可直接采用的训练顺序是:先冻结骨干训练 5~10 个 epoch,确认验证指标不再明显上升;然后只解冻靠后的若干层或 block,把学习率从例如 1e-3 降到 1e-5 量级,再训练 3~10 个 epoch,并重新调用 compile()。
迁移学习是否成功,不看“用了预训练模型”这件事本身,而看同一验证集上的收敛速度、泛化效果和训练成本。先用冻结阶段建立基线,再决定是否微调,能把风险和实验成本都控制在可检查范围内。