
机器学习与深度学习 / 系统课时
保存最佳模型
保存最佳模型
训练跑完并不代表最后一轮就是效果最好的一轮。本课用 tf.keras.callbacks.ModelCheckpoint 按验证指标自动保留最佳检查点,并分别演示保存完整模型与仅保存权重,最后通过重新加载确认文件确实可用于推理或继续训练。
学习目标
- 用
monitor、mode和save_best_only定义“最佳”模型。 - 正确选择完整模型
.keras与权重文件.weights.h5的保存方式。 - 在训练结束后重新加载检查点并完成可验证的检查。
让验证指标决定是否覆盖文件
做回归或大多数以损失为目标的任务时,可以监控 val_loss 并设置 mode="min";监控 val_accuracy 时则通常使用 mode="max"。save_best_only=True 会让回调只在指标优于此前最佳值时写入文件,避免把后续退化的轮次覆盖成最终结果。
| 设置 | 典型取值 | 实际作用 |
|---|---|---|
monitor |
val_loss |
每轮结束读取验证集总损失 |
mode |
min |
数值更小才算更好 |
save_best_only |
True |
仅在刷新最佳值时保存 |
save_freq |
epoch |
每个 epoch 结束时检查 |
filepath |
best-model.keras |
保存完整 Keras 模型 |
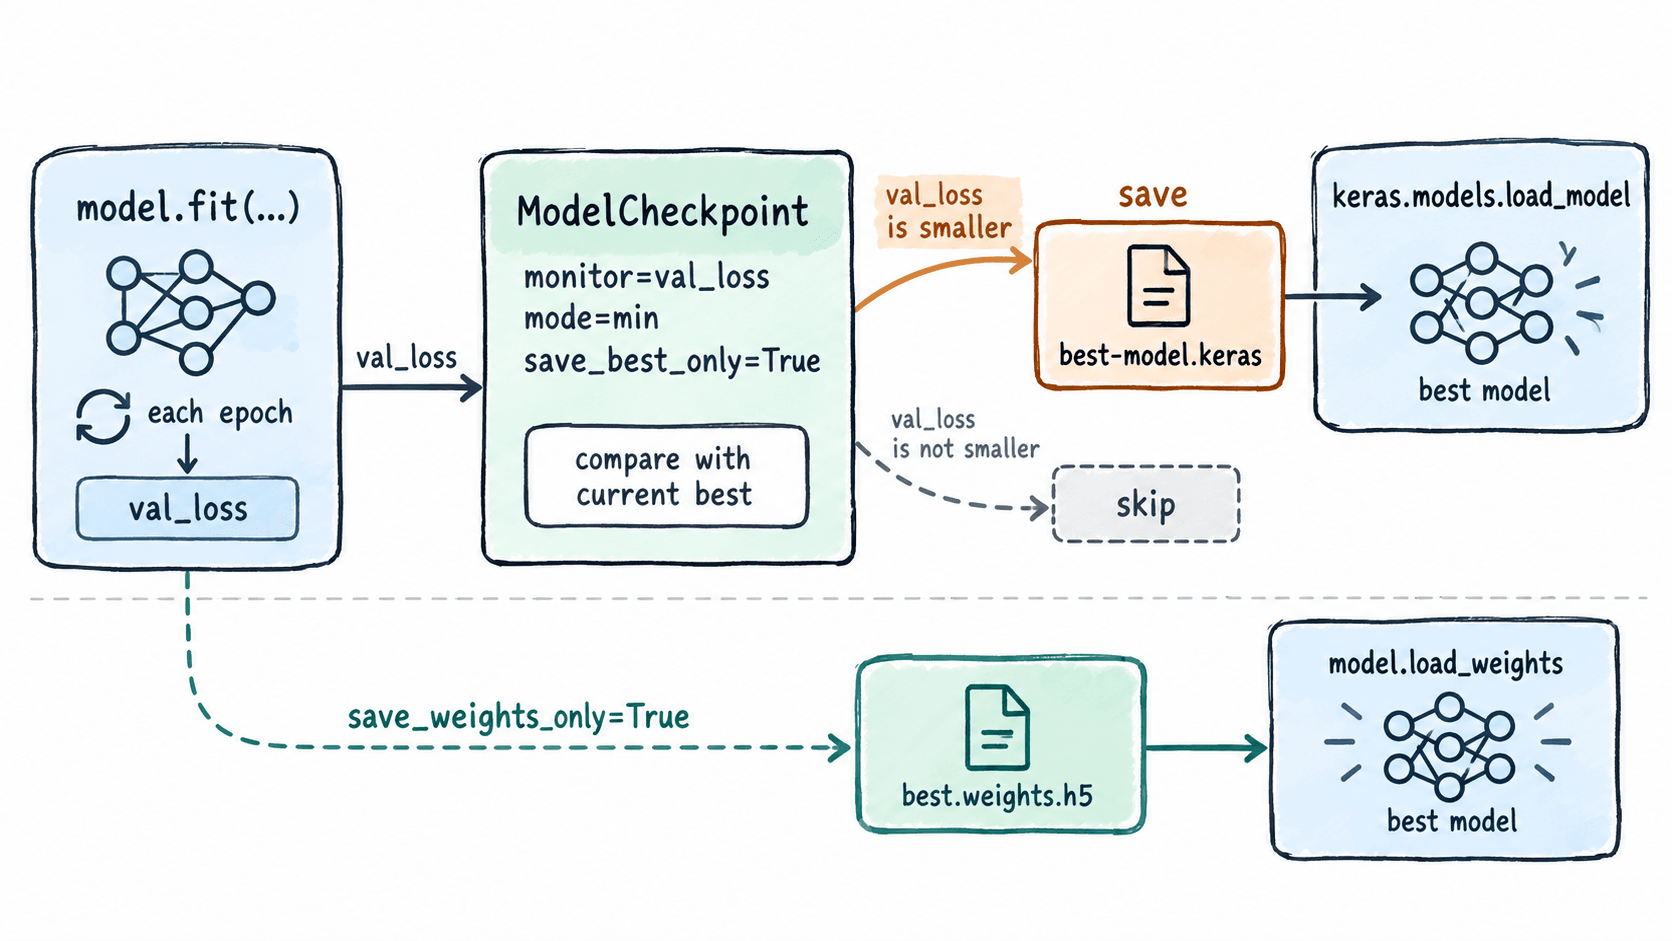
如果同一轮同时记录多个指标,先在 history.history.keys() 中确认真实名称,再填写 monitor。多输出模型或自定义 Metric 可能产生带前缀的名称,直接猜 val_acc、val_f1 容易导致回调找不到监控项。
保存完整模型并重新加载
下面示例适用于 TensorFlow 2.16+ 默认使用 Keras 3 的环境。它构造一组简单回归数据,训练 20 轮,并把验证损失最低时的完整模型写入 best-model.keras。完整模型包含网络结构和权重,训练后可直接用 load_model 恢复。
from pathlib import Path

import numpy as np
import tensorflow as tf

tf.keras.utils.set_random_seed(7)
rng = np.random.default_rng(7)

x = rng.normal(size=(1000, 4)).astype("float32")
y = (2.0 * x[:, 0] - 1.5 * x[:, 1] + 0.3).astype("float32")
x_train, x_val = x[:800], x[800:]
y_train, y_val = y[:800], y[800:]

model = tf.keras.Sequential([
    tf.keras.layers.Input(shape=(4,)),
    tf.keras.layers.Dense(16, activation="relu"),
    tf.keras.layers.Dense(1),
])
model.compile(optimizer="adam", loss="mse")

checkpoint_path = Path("best-model.keras")
checkpoint = tf.keras.callbacks.ModelCheckpoint(
    filepath=checkpoint_path,
    monitor="val_loss",
    mode="min",
    save_best_only=True,
    save_weights_only=False,
    verbose=0,
)

model.fit(
    x_train,
    y_train,
    validation_data=(x_val, y_val),
    epochs=20,
    batch_size=32,
    callbacks=[checkpoint],
    verbose=0,
)

best_model = tf.keras.models.load_model(checkpoint_path)
val_loss = best_model.evaluate(x_val, y_val, verbose=0)

print("checkpoint_exists:", checkpoint_path.exists())
print("output_shape:", best_model.output_shape)
print("val_loss:", f"{val_loss:.4f}")
预期输出
checkpoint_exists: True
output_shape: (None, 1)
val_loss: <VAL_LOSS>
<VAL_LOSS> 会受 TensorFlow 版本、硬件和数值计算差异影响,但应该是可解析的非负浮点数。验收重点不是固定数值,而是文件存在、模型能加载、输出形状正确且验证集可以正常评估。
只保存权重时切换加载方式
如果模型结构由代码固定、磁盘空间更敏感,可以把 save_weights_only 改为 True。当前 Keras 要求权重检查点文件名以 .weights.h5 结尾;恢复时不能使用 load_model,而要先创建相同结构的模型,再调用 load_weights。
片段示例:下面代码依赖已经按训练时完全相同的方式创建并编译好的 model。
weights_checkpoint = tf.keras.callbacks.ModelCheckpoint(
    filepath="best.weights.h5",
    monitor="val_loss",
    mode="min",
    save_best_only=True,
    save_weights_only=True,
)

# 训练时把 weights_checkpoint 放入 callbacks。
# 恢复时,model 必须具有与保存时兼容的层结构。
model.load_weights("best.weights.h5")
验证方法很直接:完整模型检查点应能被 tf.keras.models.load_model("best-model.keras") 独立恢复;权重检查点则应在同结构模型上执行 load_weights("best.weights.h5") 后正常 predict。两种格式不要混用加载 API。
避免把最后一轮当成最佳轮
训练集损失持续下降而验证损失先降后升时,最后一轮往往已经过拟合。例如验证损失依次为 0.42、0.31、0.27、0.29、0.35,最佳轮是第 3 轮,而不是第 5 轮。此时 save_best_only=True 应保留第 3 轮对应的文件。
实际项目可以把最佳轮次也从历史记录中算出来,便于日志和模型文件相互核对。若监控 val_loss,检查 np.argmin(history.history["val_loss"]) + 1;若监控需要越大越好的指标,则改用 np.argmax。保存策略与评价指标必须一致,否则“最佳检查点”只是在优化错误的目标。