
机器学习与深度学习 / 系统课时
使用早停策略
使用早停策略
训练轮数设得过大时,模型可能在验证集已经不再改善后继续消耗计算,甚至开始过拟合。本课用 EarlyStopping 监控验证指标,设置最小改善量、耐心轮数和最佳权重恢复,并用一个可重复的小例子验证训练确实会提前结束。
学习目标
- 能解释
monitor、min_delta、patience和restore_best_weights如何共同决定停止时机。 - 能把
EarlyStopping正确接入包含验证集的model.fit()。 - 能区分“停止训练”和“保存最佳模型文件”这两个不同动作。
把停止条件写成可检查的规则
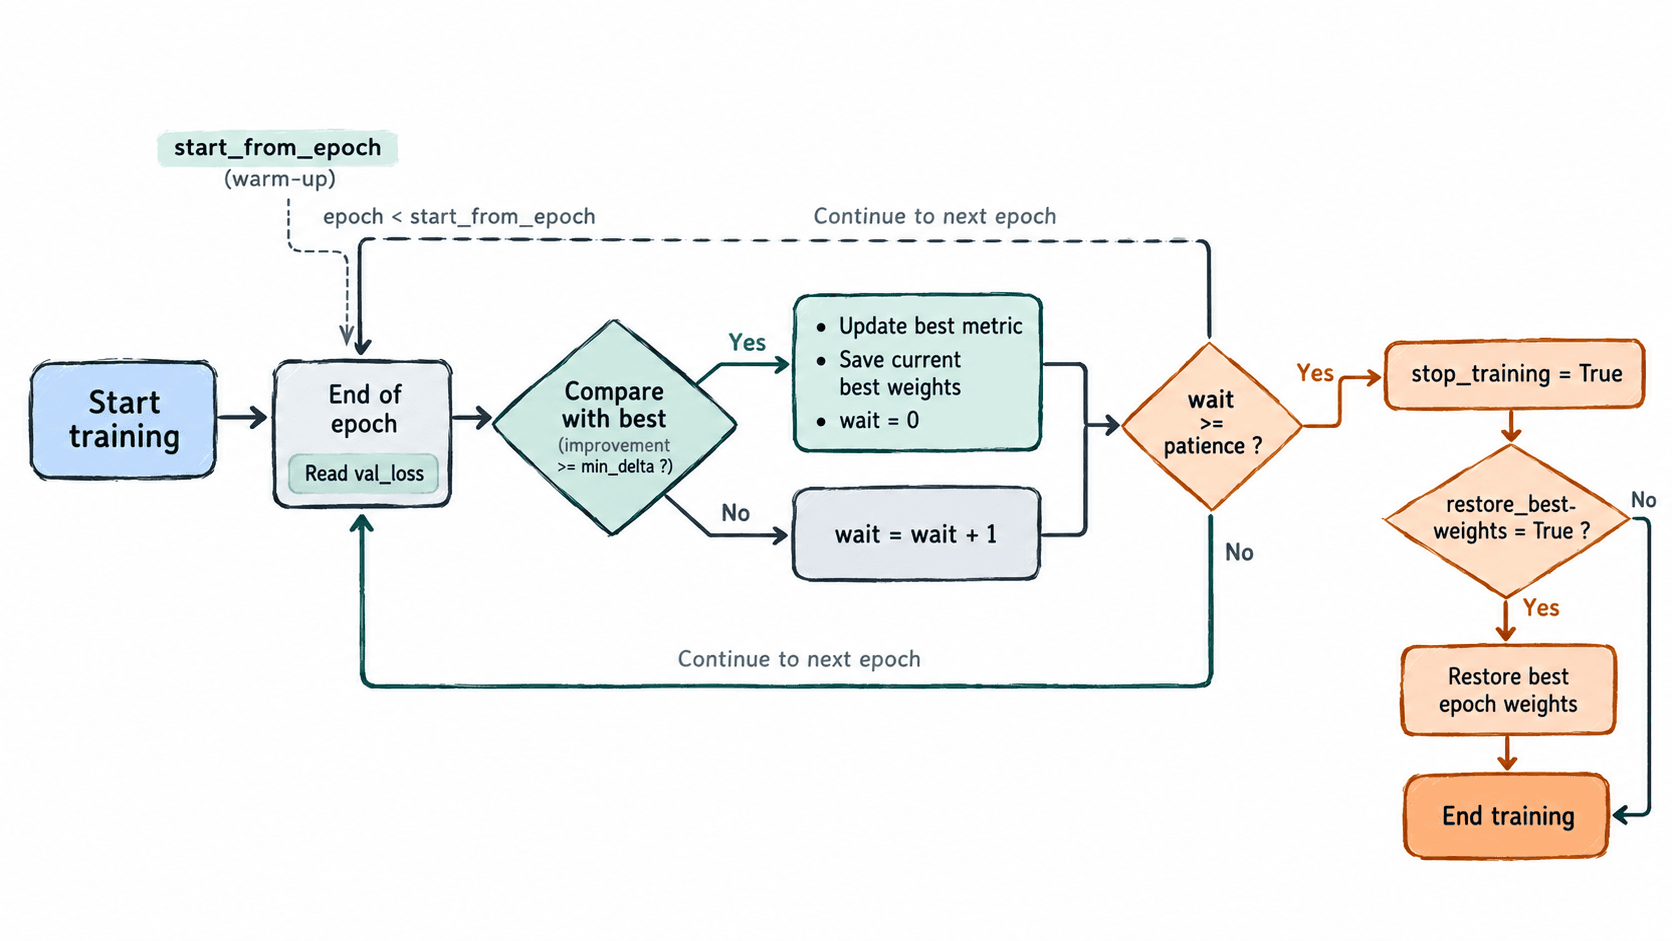
以下参数按 TensorFlow 2.16.1 的 tf.keras.callbacks.EarlyStopping 写法。监控损失时使用 mode="min",监控准确率、AUC 等越大越好的指标时使用 mode="max"。
| 参数 | 示例值 | 实际含义 |
|---|---|---|
monitor |
"val_loss" |
每轮结束后读取验证损失 |
min_delta |
1e-4 |
小于 0.0001 的变化不算有效改善 |
patience |
3 |
连续 3 轮没有有效改善后停止 |
restore_best_weights |
True |
训练结束后恢复最佳轮次的权重 |
start_from_epoch |
2 |
前 2 轮作为热身期,不参与早停判断 |
用恒定验证损失验证早停
下面故意把 SGD 学习率设为 0.0,使模型权重完全不更新,因此 val_loss 每轮都保持不变。patience=2 时,第 1 轮建立最佳值,随后连续 2 轮没有改善,所以总共只会执行 3 个 epoch,而不是请求的 10 个。
import tensorflow as tf

x = tf.ones((8, 1), dtype=tf.float32)
y = tf.ones((8, 1), dtype=tf.float32)

model = tf.keras.Sequential([
    tf.keras.Input(shape=(1,)),
    tf.keras.layers.Dense(
        1,
        kernel_initializer="zeros",
        bias_initializer="zeros",
    ),
])
model.compile(
    optimizer=tf.keras.optimizers.SGD(learning_rate=0.0),
    loss="mse",
)

early_stop = tf.keras.callbacks.EarlyStopping(
    monitor="val_loss",
    mode="min",
    min_delta=0.0,
    patience=2,
    restore_best_weights=True,
    verbose=0,
)

history = model.fit(
    x,
    y,
    validation_data=(x, y),
    epochs=10,
    batch_size=4,
    verbose=0,
    callbacks=[early_stop],
)

print("epochs_run =", len(history.history["loss"]))
print("best_val_loss =", f"{min(history.history['val_loss']):.1f}")
预期输出
epochs_run = 3
best_val_loss = 1.0
这个例子不是为了训练出好模型,而是隔离验证早停逻辑。真实训练中学习率应恢复为正常值,例如 Adam 常用 1e-3 作为起点,再根据任务规模和曲线调节。
恢复最佳权重不等于保存文件
restore_best_weights=True 只把内存中的模型权重恢复到监控指标最好的轮次,不会自动生成模型文件。如果训练可能中断,或需要部署最佳版本,应再配合 ModelCheckpoint(save_best_only=True)。
片段示例:下面依赖已经创建好的 model、训练集和验证集,并把最佳完整模型保存为当前工作目录下的 best.keras。
checkpoint = tf.keras.callbacks.ModelCheckpoint(
    filepath="best.keras",
    monitor="val_loss",
    mode="min",
    save_best_only=True,
)

model.fit(
    x_train,
    y_train,
    validation_data=(x_val, y_val),
    epochs=100,
    callbacks=[early_stop, checkpoint],
)验证时应同时检查两件事:history.history["loss"] 的长度小于最大 epochs,说明早停真的触发;当前目录出现 best.keras,说明最佳模型也已持久化。只设置 restore_best_weights=True 而没有 ModelCheckpoint,磁盘上不会自动多出模型文件。
避免过早停止和无效等待
验证指标抖动较大时,patience=1 往往太敏感。小型稳定任务可以先从 patience=3~5 开始;噪声更大的任务可尝试 5~10。若前几轮属于学习率 warm-up,可设 start_from_epoch=3 或 5,避免模型刚启动就被判断为停滞。
另一个常见错误是把 monitor="val_accuracy" 却仍使用 mode="min",这会把方向设反。验收时应先确认监控指标确实存在,再确认方向正确,最后检查停止轮次是否符合 min_delta + patience 的规则;只有三项都对,早停策略才算真正生效。