
机器学习与深度学习 / 系统课时
执行模型微调
执行模型微调
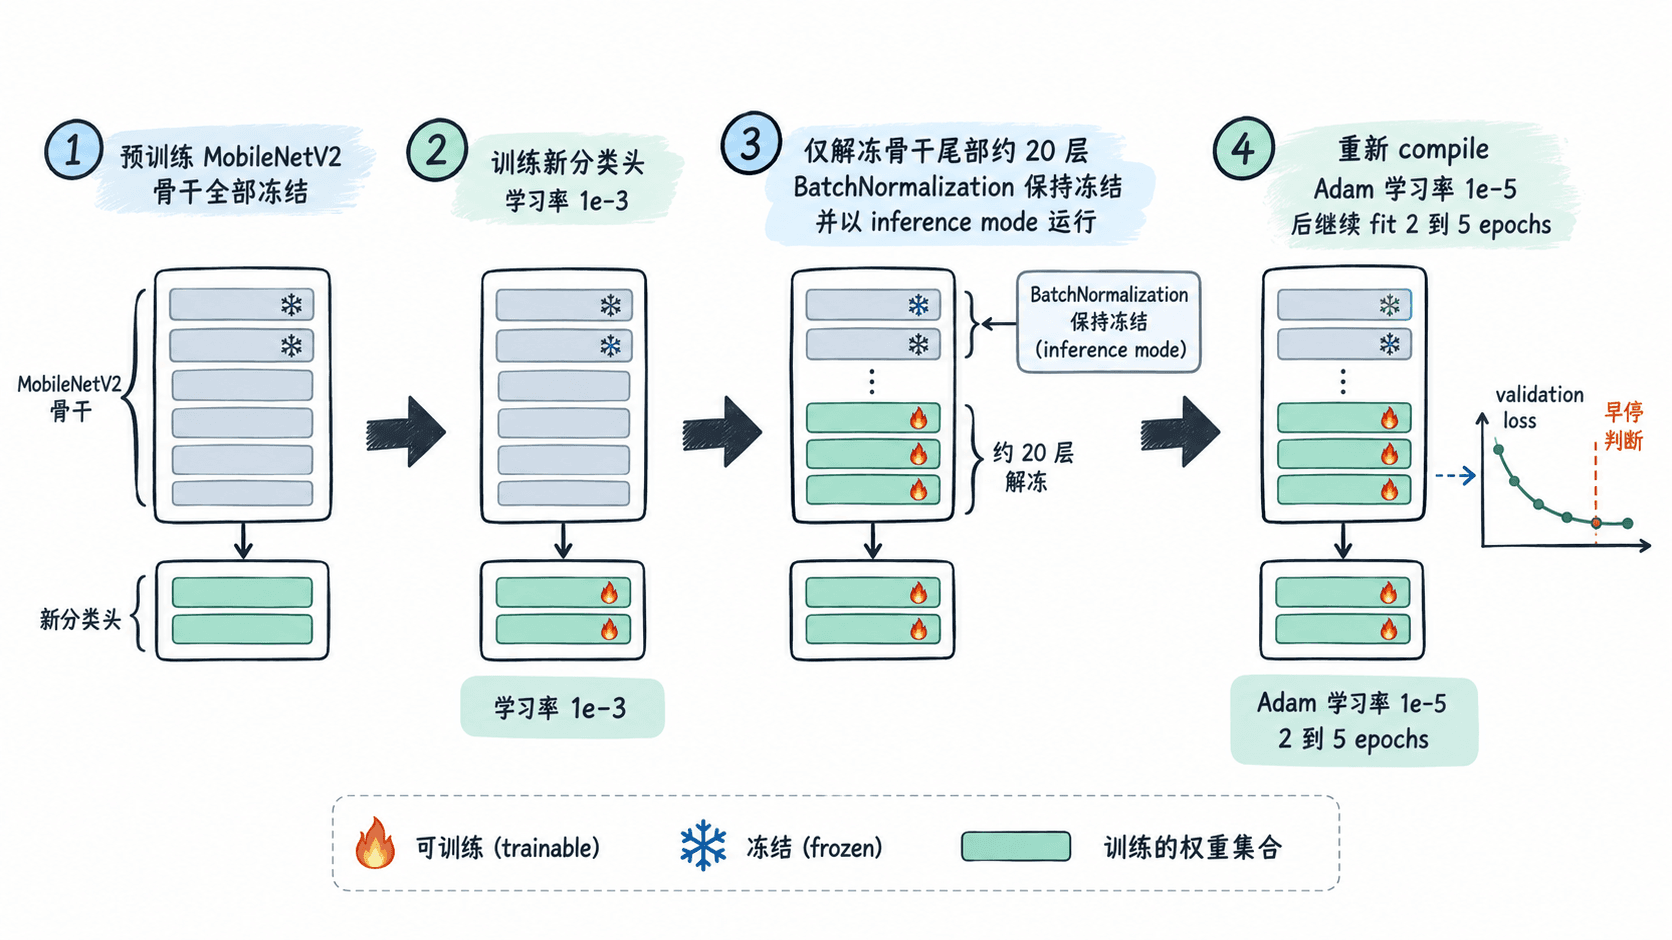
微调是在分类头已经学会新任务后,解冻预训练网络的一小部分,用更小学习率继续训练。本篇用 MobileNetV2 演示从“冻结特征提取”切换到“尾部微调”,并把重新编译、BatchNormalization 处理和停止条件一起落实到可运行代码中。
学习目标
- 能在
tf.keras中只解冻预训练模型尾部若干层,并确认哪些权重会参与更新。 - 能在修改
trainable后重新compile(),使用约1e-5的低学习率继续训练。 - 能通过验证集损失和训练/验证差距判断微调应继续、缩小范围还是停止。
微调前先固定一个可比较的基线
不要刚接上随机初始化的分类头就立刻解冻骨干网络。先冻结骨干并训练分类头,至少等到验证指标开始稳定;实操中可把“连续 2 个 epoch 验证损失没有明显下降”作为进入微调的检查点,而不是机械追求固定轮数。
一个适合小型图像分类任务的起始配置是:分类头阶段学习率 1e-3,微调阶段降到 1e-5;先只解冻尾部约 20 层,微调 2~5 个 epoch。若验证损失在第 1~2 个微调 epoch 就反弹,应优先减小解冻范围或把学习率降到 5e-6,而不是继续增加训练轮数。
解冻后必须重新编译
layer.trainable 决定权重是否进入优化器更新集合。修改任何内部层的 trainable 状态后,都要再次调用 model.compile(),让 Keras 按新的可训练权重集合建立训练配置;只改属性、不重新编译,是最常见的“看似解冻但训练行为没变”问题。
MobileNetV2 含有 BatchNormalization。微调小数据集时,通常让这些层保持冻结,并在建模时用 base_model(x, training=False) 让骨干中的 BatchNormalization 使用已有移动均值与方差,避免小批次统计量把预训练分布迅速冲掉。
运行一次完整微调
下面示例面向 TensorFlow 2.x 的 tf.keras 接口。它使用 CIFAR-10 中的猫和狗作为二分类数据,首次运行会下载 CIFAR-10 和 ImageNet 预训练权重;先训练分类头 1 个 epoch,再解冻 MobileNetV2 尾部 20 层并以 1e-5 微调 2 个 epoch。
import numpy as np
import tensorflow as tf
from tensorflow import keras

tf.random.set_seed(7)
np.random.seed(7)

(x_train, y_train), (x_test, y_test) = keras.datasets.cifar10.load_data()

def pick_cat_dog(x, y, limit):
    labels = y.reshape(-1)
    ids = np.where(np.isin(labels, [3, 5]))[0][:limit]
    # CIFAR-10: 3=cat, 5=dog;这里把 dog 映射为 1。
    return x[ids], (labels[ids] == 5).astype("float32")

x_train, y_train = pick_cat_dog(x_train, y_train, 800)
x_val, y_val = pick_cat_dog(x_test, y_test, 200)

def make_ds(x, y, training):
    ds = tf.data.Dataset.from_tensor_slices((x, y))
    if training:
        ds = ds.shuffle(len(x), seed=7)
    return (
        ds.batch(32)
        .map(lambda a, b: (tf.image.resize(a, (96, 96)), b))
        .prefetch(tf.data.AUTOTUNE)
    )

train_ds = make_ds(x_train, y_train, True)
val_ds = make_ds(x_val, y_val, False)

base_model = keras.applications.MobileNetV2(
    input_shape=(96, 96, 3),
    include_top=False,
    weights="imagenet",
)
base_model.trainable = False

inputs = keras.Input((96, 96, 3))
x = keras.applications.mobilenet_v2.preprocess_input(inputs)
x = base_model(x, training=False)
x = keras.layers.GlobalAveragePooling2D()(x)
outputs = keras.layers.Dense(1)(x)
model = keras.Model(inputs, outputs)

model.compile(
    optimizer=keras.optimizers.Adam(1e-3),
    loss=keras.losses.BinaryCrossentropy(from_logits=True),
    metrics=[keras.metrics.BinaryAccuracy(threshold=0.0)],
)
model.fit(train_ds, validation_data=val_ds, epochs=1, verbose=0)

# 解冻尾部 20 层,但继续冻结 BatchNormalization。
base_model.trainable = True
for layer in base_model.layers[:-20]:
    layer.trainable = False
for layer in base_model.layers[-20:]:
    layer.trainable = not isinstance(layer, keras.layers.BatchNormalization)

# trainable 发生变化后必须重新编译,并显著降低学习率。
model.compile(
    optimizer=keras.optimizers.Adam(1e-5),
    loss=keras.losses.BinaryCrossentropy(from_logits=True),
    metrics=[keras.metrics.BinaryAccuracy(threshold=0.0)],
)
history = model.fit(train_ds, validation_data=val_ds, epochs=2, verbose=0)

print(f"fine_tune_lr={float(model.optimizer.learning_rate.numpy()):.2e}")
print(f"fine_tune_epochs={len(history.history['loss'])}")
print(
    "bn_trainable="
    + str(any(
        isinstance(layer, keras.layers.BatchNormalization) and layer.trainable
        for layer in base_model.layers
    ))
)
预期输出如下;训练损失和准确率会随硬件、TensorFlow 版本及随机性变化,因此示例只打印可稳定核对的配置状态。
fine_tune_lr=1.00e-05
fine_tune_epochs=2
bn_trainable=False
用验证集决定是否保留微调结果
微调不是“训练后准确率上涨就算成功”。至少同时看 val_loss 和训练/验证差距:若验证准确率提高而 val_loss 持续下降,可以保留;若训练准确率继续上涨、验证准确率停滞,同时验证损失连续 2 个 epoch 上升,应停止并恢复最佳权重。
一个可执行的验收规则是:微调最多先跑 5 个 epoch,EarlyStopping(monitor="val_loss", patience=2, restore_best_weights=True);如果最佳验证准确率相对冻结基线没有提升至少约 0.2 个百分点,就先把解冻范围从 20 层缩到 10 层或把学习率从 1e-5 降到 5e-6。这些数值是实验起点,最终以同一验证集上的对照结果为准。