
机器学习与深度学习 / 系统课时
理解混淆矩阵
理解混淆矩阵
混淆矩阵把“真实类别”和“预测类别”放在同一张表里,让你不仅知道模型错了多少,还能看出它把哪一类错成了哪一类。掌握读法后,可以直接定位类别混淆、漏检和误报问题。
学习目标
- 能按“行是真实类别、列是预测类别”读取多分类混淆矩阵
- 能针对任意一个类别换算 TP、FP、FN、TN
- 能用 TensorFlow 生成矩阵并据此定位主要错误来源
从矩阵读对错
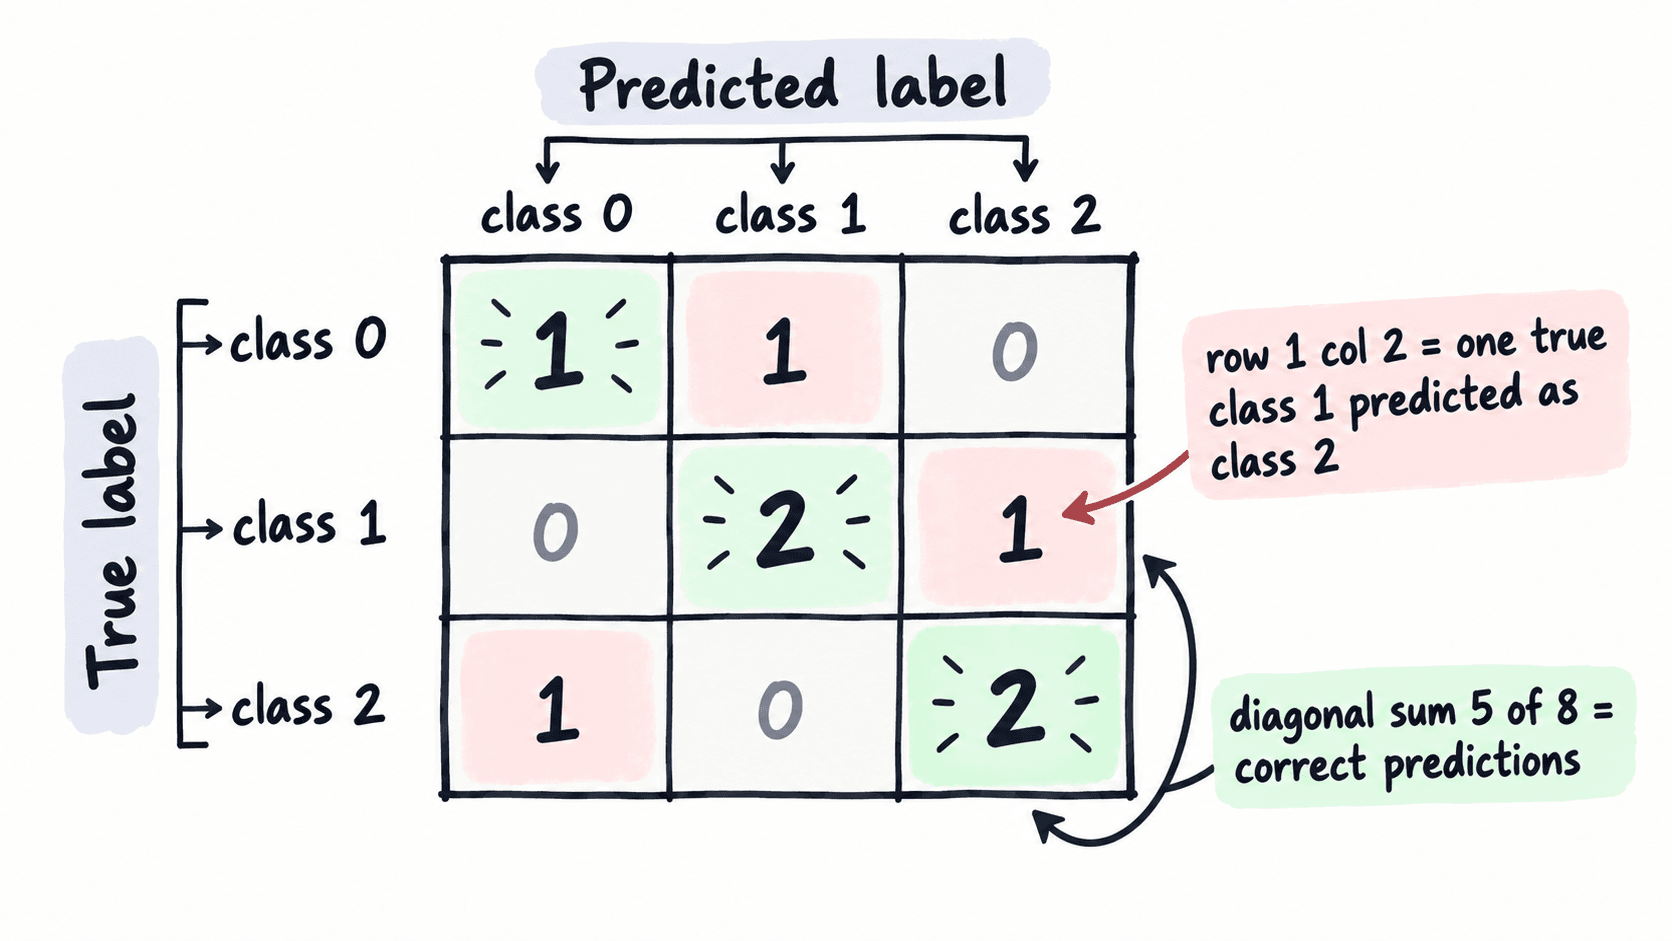
假设三分类模型得到下面的计数矩阵。行标签是 y_true,列标签是 y_pred;主对角线表示预测正确,非对角线表示具体的混淆方向。三行样本总数分别是 2、3、3,总样本数为 8。
| 真实类别 / 预测类别 | 0 | 1 | 2 |
|---|---|---|---|
| 0 | 1 | 1 | 0 |
| 1 | 0 | 2 | 1 |
| 2 | 1 | 0 | 2 |
例如第二行第三列的 1 表示:有 1 个真实类别为 1 的样本,被模型预测成了类别 2。矩阵不能只看对角线总和,还要观察最大的非对角线单元格,因为它直接指出最常见的错误方向。
把某一类展开为四种结果
多分类矩阵也可以把某一个类别单独当作“正类”做一对其余分析。以上表中的类别 2 为例:TP=2,FN=1,FP=1,其余四个样本都不是类别 2 且也没被预测成 2,所以 TN=4。
由这四个数可以继续计算该类别的精确率与召回率。类别 2 的精确率为 ,召回率同样为 。如果业务最怕漏掉类别 2,应优先观察 FN 和召回率,而不是只看整体准确率。
用 TensorFlow 生成矩阵
tf.math.confusion_matrix 会按给定标签顺序累计计数。下面示例固定 num_classes=3,因此即使某个批次暂时没有出现某一类,也仍然保留完整的 3×3 形状。
import tensorflow as tf

y_true = tf.constant([0, 0, 1, 1, 2, 2, 2, 1])
y_pred = tf.constant([0, 1, 1, 1, 2, 0, 2, 2])

cm = tf.math.confusion_matrix(
    y_true,
    y_pred,
    num_classes=3,
)
print(cm.numpy())
预期输出
[[1 1 0]
 [0 2 1]
 [1 0 2]]
这里的类别编号必须与数据集标签编码一致。如果你的原始标签是字符串,先固定映射关系,例如 cat -> 0、dog -> 1、fox -> 2;训练、评估和绘图阶段都要复用同一份映射,否则矩阵行列会被误读。
用矩阵定位模型问题
排查时先计算每一行的错误率,再找最大的非对角线单元格。若“真实类别 1 → 预测类别 2”占类别 1 样本的 30%,说明这两个类别在特征或标注上高度相似,应优先检查样本质量、类别定义和训练数据覆盖。
只看绝对计数可能被大类别掩盖。若类别 0 有 10000 个样本、类别 2 只有 200 个样本,可以把每行分别除以该行总数,得到按真实类别归一化的比例矩阵;这样 40 个错误在类别 2 中就是 20%,不会被 10000 级别的大类计数淹没。