
机器学习与深度学习 / 系统课时
继承 Model 自定义模型
继承 Model 自定义模型
当网络存在条件分支、共享子层或不适合线性堆叠的前向逻辑时,可以继承 tf.keras.Model 把结构封装成一个可训练对象。完成后,模型既能像函数一样接收张量,也能继续使用 compile()、fit()、evaluate() 与权重保存接口。
学习目标
- 能用
__init__()注册子层,并在call()中组织前向计算。 - 能正确传递
training,让Dropout等层区分训练与推理行为。 - 能通过输出形状和参数量检查自定义模型是否按预期构建。
子类化的职责边界
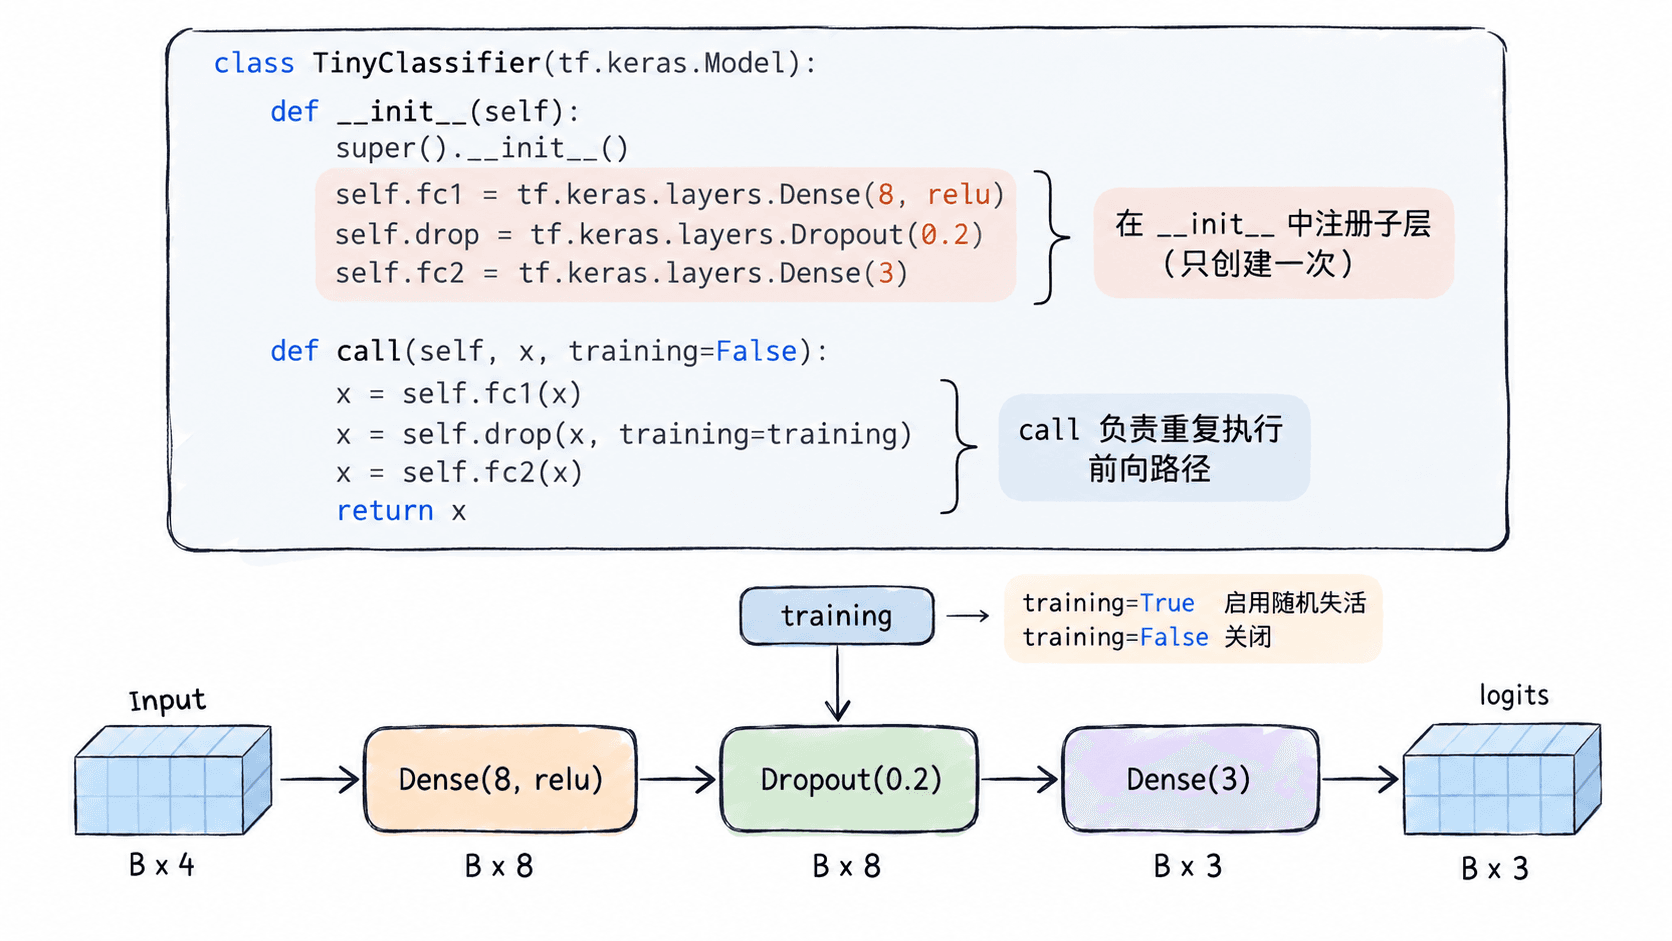
Model 子类通常把“持久结构”和“每次前向计算”分开:子层放在 __init__() 中,数据怎么流过这些层写在 call() 中。把 Dense 等层临时创建在 call() 里,会导致变量管理混乱,也可能在图执行时触发重复创建变量的问题。
实际项目可按这个判断:只是一个可复用计算块、不会直接 fit() 的对象更适合继承 Layer;需要直接训练、评估或保存的顶层网络更适合继承 Model。子层赋给模型属性后,Keras 会递归跟踪这些层及其权重。
用 call 写前向路径
下面示例按 TensorFlow 2.x 的 tf.keras API 编写。输入每条样本有 4 个特征,隐藏层 8 个单元,最后输出 3 个未归一化 logits。第一次调用模型时,Dense 会根据真实输入维度创建权重。
import tensorflow as tf

class TinyClassifier(tf.keras.Model):
    def __init__(self, num_classes=3):
        super().__init__()
        self.hidden = tf.keras.layers.Dense(8, activation="relu")
        self.dropout = tf.keras.layers.Dropout(0.2)
        self.classifier = tf.keras.layers.Dense(num_classes)

    def call(self, inputs, training=False):
        # training 必须继续传给会区分训练/推理行为的子层。
        x = self.hidden(inputs)
        x = self.dropout(x, training=training)
        return self.classifier(x)

model = TinyClassifier(num_classes=3)
x = tf.ones((2, 4), dtype=tf.float32)

logits = model(x, training=False)
print("output shape:", logits.shape)
print("parameter count:", model.count_params())
预期输出
output shape: (2, 3)
parameter count: 67
67 个参数来自两层全连接:第一层为 ,第二层为 。若输出形状不是 (2, 3),先检查最后一层 units;若参数量异常,检查是否意外重复创建了层。
让训练模式沿调用链传递
Dropout、BatchNormalization 这类层在训练和推理阶段行为不同,因此自定义 call() 最好显式接收 training=False,并继续传给相关子层。model.fit() 调用模型时会管理训练模式,而手工推理时可明确写 model(x, training=False)。
错误做法是把 self.dropout(x, training=True) 写死,这会让推理阶段仍随机丢弃激活值;另一种常见错误是在 call() 中写 tf.keras.layers.Dropout(0.2)(x),这会把结构定义和前向执行混在一起。
什么时候选子类化
顺序网络可直接用 Sequential,固定的多输入、多输出有向无环图通常优先考虑 Functional API;当 call() 里需要 Python 条件逻辑、循环、共享路径或复杂张量操作时,再使用 Model 子类化。这样既保留 Keras 训练接口,也不会为了迁就静态结构而拆散真实前向逻辑。
验收时至少检查三件事:用一个最小批次跑通 model(x);确认输出最后一维等于任务类别数或目标维度;在首次调用后查看 model.count_params() 与 model.trainable_variables,确认权重数量与预期结构一致。