
机器学习与深度学习 / 系统课时
处理类别不平衡
处理类别不平衡
当正负样本比例达到 95:5 甚至更极端时,单看 accuracy 很容易误判模型效果。本篇用同一组二分类数据演示类别权重、训练集重采样和决策阈值三种处理方式,并用 Precision、Recall 与 PR 取舍判断是否真的改善了少数类别识别。
学习目标
- 根据训练集类别数量计算并应用
class_weight - 使用重采样构造接近 1:1 的训练批次,同时避免污染验证集
- 在验证集上调整分类阈值,并理解 Precision 与 Recall 的变化方向
先确认不平衡到底影响了什么
假设训练集有 4000 条样本,其中类别 0 有 3800 条,类别 1 只有 200 条,比例为 95:5。一个始终预测类别 0 的模型也能得到 95% accuracy,但类别 1 的 Recall 会是 0,因此不能把 accuracy 当作主要验收指标。
实际项目至少同时观察 Precision、Recall 和 PR-AUC。若业务更怕漏掉少数类,例如欺诈检测或故障预警,应优先约束 Recall;若一次误报代价很高,则需要同时控制 Precision。
| 指标 | 关注的问题 | 不平衡任务中的用途 |
|---|---|---|
| Precision | 判为正类的样本有多少是真的 | 控制误报 |
| Recall | 实际正类有多少被找出来 | 控制漏报 |
| PR-AUC | 不同阈值下 Precision-Recall 综合表现 | 比 accuracy 更适合稀有正类 |
类别权重让少数类错误更贵
Keras 的 model.fit() 可以直接接收 class_weight。常用平衡权重按总样本数除以“类别数 × 当前类别样本数”计算。本例得到类别 0 权重约 0.5263,类别 1 权重为 10.0,也就是漏判一个正类会对损失产生明显更大的影响。
下面的脚本同时训练一个加权模型、扫描三个决策阈值,并构造一个 1:1 重采样批次。示例适用于 TensorFlow 2.x。
import numpy as np
import tensorflow as tf

tf.keras.utils.set_random_seed(42)
rng = np.random.default_rng(42)

def make_split(n0, n1):
    x0 = rng.normal(0.0, 1.0, size=(n0, 2)).astype('float32')
    x1 = rng.normal(1.5, 1.0, size=(n1, 2)).astype('float32')
    x = np.concatenate([x0, x1])
    y = np.concatenate([
        np.zeros(n0, dtype='float32'),
        np.ones(n1, dtype='float32')
    ])
    order = rng.permutation(len(y))
    return x[order], y[order]

x_train, y_train = make_split(3800, 200)
x_val, y_val = make_split(950, 50)

n0 = int(np.sum(y_train == 0))
n1 = int(np.sum(y_train == 1))
class_weight = {
    0: len(y_train) / (2 * n0),
    1: len(y_train) / (2 * n1),
}
print({k: round(v, 4) for k, v in class_weight.items()})

model = tf.keras.Sequential([
    tf.keras.layers.Input(shape=(2,)),
    tf.keras.layers.Dense(8, activation='relu'),
    tf.keras.layers.Dense(1, activation='sigmoid'),
])
model.compile(
    optimizer='adam',
    loss='binary_crossentropy',
    metrics=[
        tf.keras.metrics.Precision(name='precision'),
        tf.keras.metrics.Recall(name='recall'),
        tf.keras.metrics.AUC(curve='PR', name='pr_auc'),
    ],
)
model.fit(
    x_train,
    y_train,
    epochs=5,
    batch_size=128,
    verbose=0,
    class_weight=class_weight,
)

probs = model.predict(x_val, verbose=0).ravel()
for threshold in (0.3, 0.5, 0.7):
    pred = probs >= threshold
    tp = np.sum((pred == 1) & (y_val == 1))
    fp = np.sum((pred == 1) & (y_val == 0))
    fn = np.sum((pred == 0) & (y_val == 1))
    precision = tp / max(tp + fp, 1)
    recall = tp / max(tp + fn, 1)
    print(
        f'threshold={threshold:.1f} '
        f'precision={precision:.3f} recall={recall:.3f}'
    )

neg_ds = tf.data.Dataset.from_tensor_slices(
    (x_train[y_train == 0], y_train[y_train == 0])
).shuffle(1000, seed=42).repeat()
pos_ds = tf.data.Dataset.from_tensor_slices(
    (x_train[y_train == 1], y_train[y_train == 1])
).shuffle(200, seed=42).repeat()

balanced_ds = tf.data.Dataset.sample_from_datasets(
    [neg_ds, pos_ds],
    weights=[0.5, 0.5],
    seed=42,
).batch(128)

_, y_batch = next(iter(balanced_ds))
print(
    'balanced batch positive fraction='
    f'{float(tf.reduce_mean(y_batch)):.3f}'
)
预期输出如下。训练指标和采样批次中的实际正类比例受 TensorFlow 版本、硬件与随机采样影响,因此以 <VALUE> 表示动态值。
{0: 0.5263, 1: 10.0}
threshold=0.3 precision=<VALUE> recall=<VALUE>
threshold=0.5 precision=<VALUE> recall=<VALUE>
threshold=0.7 precision=<VALUE> recall=<VALUE>
balanced batch positive fraction=<VALUE>
通常降低阈值会提高 Recall、降低 Precision;提高阈值则相反。阈值必须在验证集上选择,测试集只用于最终一次评估,不能反复用测试结果调阈值。
重采样改变训练时看到的类别比例
上面的 balanced_ds 从正、负两个无限数据流中分别以 0.5 概率取样,因此一个足够大的 batch 会接近 1:1。若用它训练,可设置 steps_per_epoch=31,因为原训练集 4000 条、batch size 为 128,4000/128 约等于 31。
不要先把全量数据重采样再切验证集。正确顺序是先划分 Train、Validation、Test,只对 Train 做过采样或欠采样;否则同一条少数类记录可能同时进入训练和验证,造成数据泄漏。
三种方法解决的是不同位置的问题
类别权重作用在损失函数,重采样作用在训练数据分布,阈值调整发生在模型输出概率之后。它们不是互相替代的同一个开关,而是训练链路中的三个不同控制点。
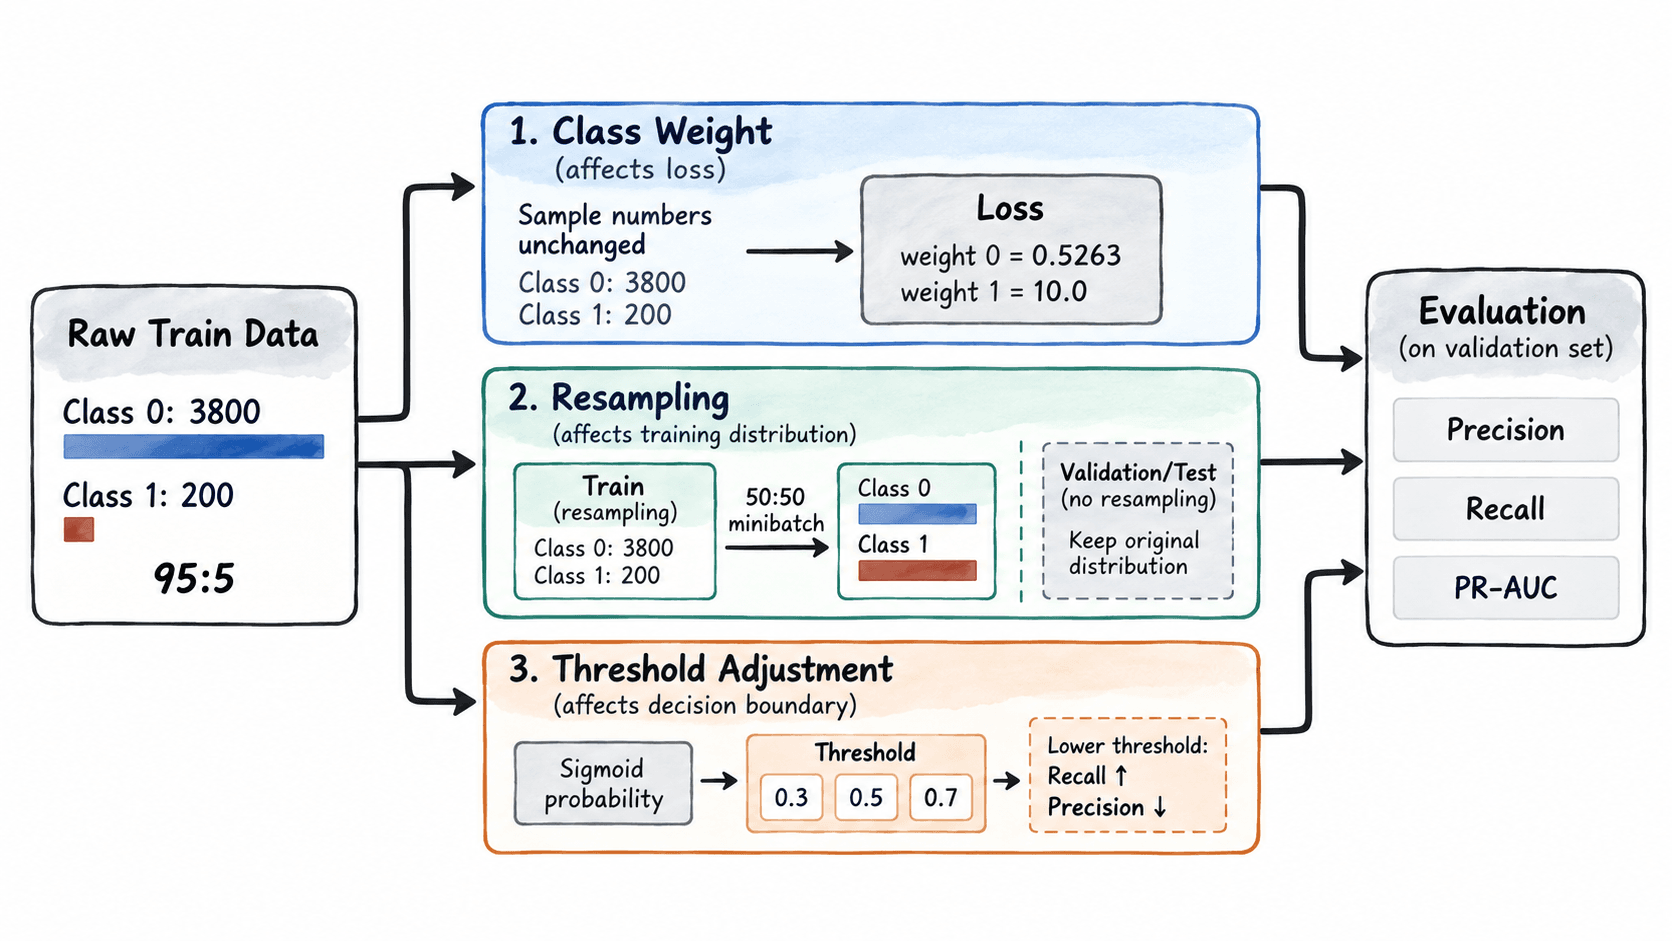
如果少数类只是数量少但数据质量正常,先从 class_weight 开始成本最低;如果训练批次经常完全没有正类,可改用重采样;模型排序能力已经不错但业务漏报或误报比例不合适时,再在验证集上调阈值。最终应以未参与调参的测试集报告 Precision、Recall 和 PR-AUC。