
机器学习与深度学习 / 系统课时
选择微调层范围
选择微调层范围
解冻层数没有通用答案:数据越少、与预训练任务越相似,越应该只动靠近输出端的高层;数据更多或领域差异更大,才有条件逐步向前解冻。本篇给出可执行的候选范围、对照规则和 MobileNetV2 层边界设置方法。
学习目标
- 能用数据规模、领域差异和过拟合风险确定第一组微调候选范围。
- 能按网络块边界而不是随意层号设置
trainable,并核对首个可训练层。 - 能通过同预算对照实验选择最小但足够的微调范围。
先用数据量和领域差异确定候选组
下面的数值适合作为 ImageNet 预训练图像模型的实验起点,而不是固定公式。样本很少时,扩大解冻范围会迅速增加可训练参数和过拟合风险;领域差异大时,只训练分类头又可能无法调整高层语义特征。
| 数据与任务情况 | 第一组候选 | 建议起始学习率 |
|---|---|---|
| 总样本少于约 2,000,且仍是自然图像 | 分类头、尾部约 10~20 层 | 1e-5 |
| 约 2,000~20,000 张,类别外观与 ImageNet 有一定差异 | 尾部约 20 层、60 层 | 5e-6~1e-5 |
| 超过约 20,000 张,且领域差异明显 | 尾部约 60 层、更大范围 | 1e-6~5e-6 |
例如只有 1,200 张商品照片、类别仍由轮廓和纹理区分时,先比较“只训练头部”和“解冻最后 20 层”即可;若是 30,000 张工业表面缺陷图,纹理统计与自然图像差异明显,可以把“最后 60 层”加入候选,但仍不应默认全网解冻。
优先在网络块边界切开
卷积骨干通常由重复模块组成。按任意层号切开虽然能运行,但可能把一个残差或倒残差块拆成前半冻结、后半训练,实验解释会变差。MobileNetV2 可以通过层名找到 block_13_expand 之类的块起点,再从该位置向后解冻。
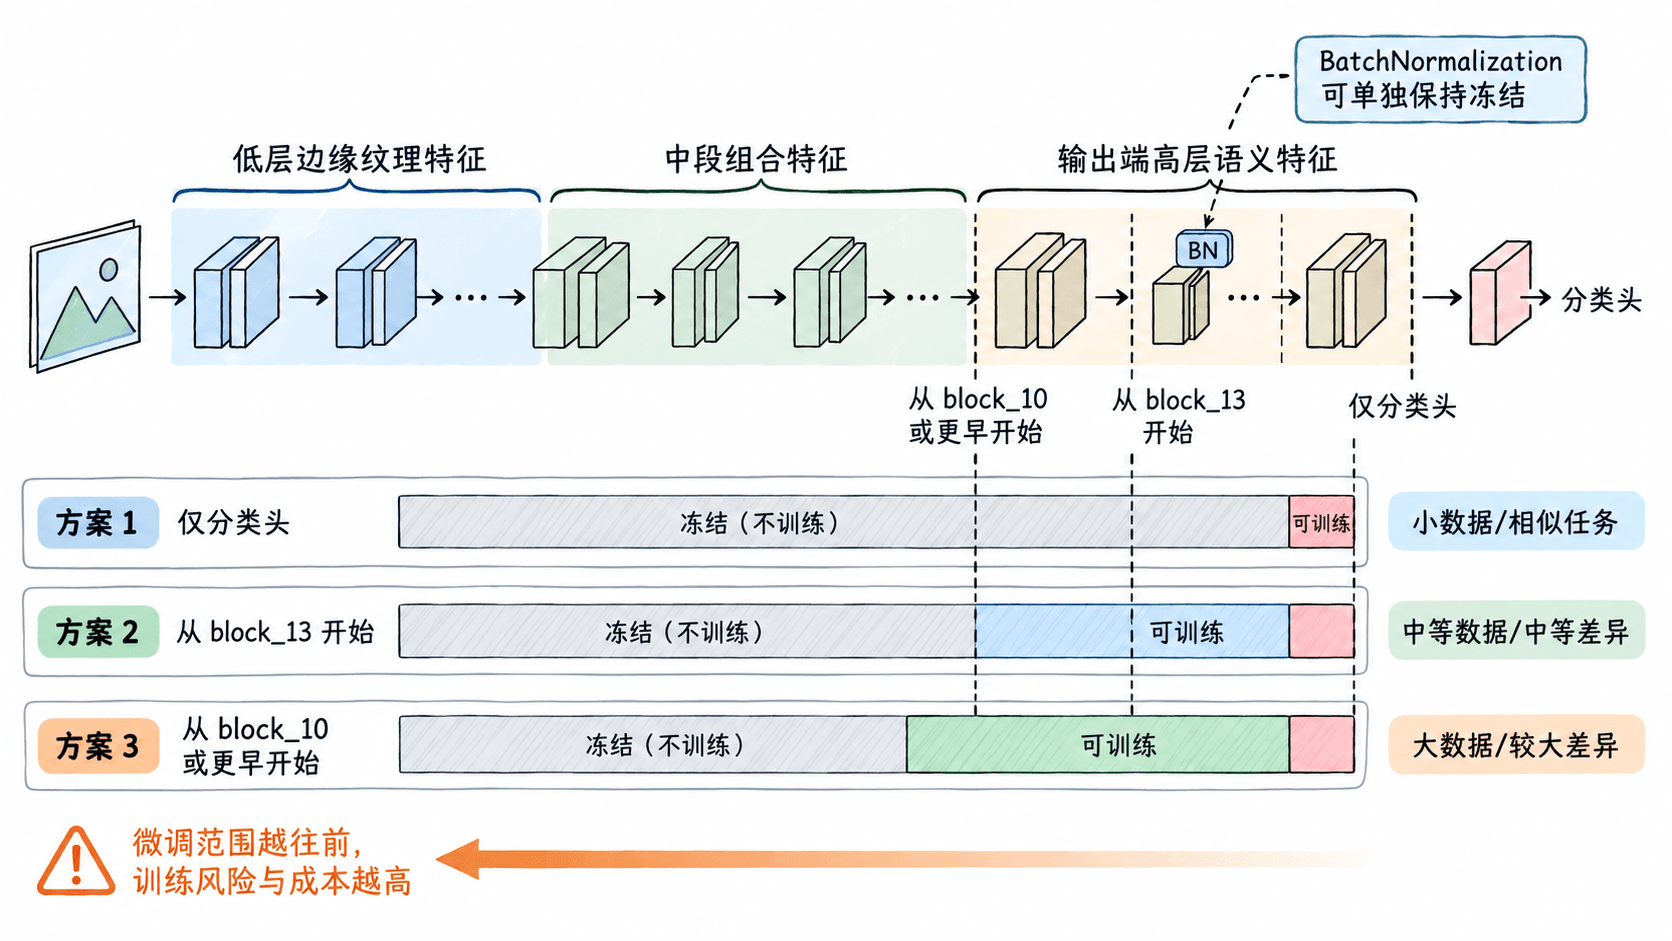
下面的可运行示例加载 ImageNet 预训练 MobileNetV2,从 block_13_expand 开始解冻,同时冻结所有 BatchNormalization,然后打印边界核对结果。层名来自 MobileNetV2 的 Keras 实现;如果更换骨干模型,应先打印当前模型的 layer.name,不要照搬该名称。
from tensorflow import keras

base_model = keras.applications.MobileNetV2(
    input_shape=(96, 96, 3),
    include_top=False,
    weights="imagenet",
)

cut_name = "block_13_expand"
cut_index = next(
    i for i, layer in enumerate(base_model.layers)
    if layer.name == cut_name
)

base_model.trainable = True
for i, layer in enumerate(base_model.layers):
    layer.trainable = (
        i >= cut_index
        and not isinstance(layer, keras.layers.BatchNormalization)
    )

first_weight_layer = next(
    layer.name
    for layer in base_model.layers
    if layer.trainable and layer.trainable_weights
)

print(f"cut={cut_name}")
print(f"first_trainable_weight_layer={first_weight_layer}")
print(
    "bn_trainable="
    + str(any(
        isinstance(layer, keras.layers.BatchNormalization) and layer.trainable
        for layer in base_model.layers
    ))
)
预期输出为:
cut=block_13_expand
first_trainable_weight_layer=block_13_expand
bn_trainable=False
用同预算对照而不是凭感觉选范围
选范围时固定其他变量,只改解冻边界。可以准备三组:A 只训练分类头,B 从 block_13_expand 起解冻,C 从 block_10_expand 起解冻;三组都使用同一训练/验证划分、同一随机种子、学习率 1e-5,最多训练 3 个微调 epoch,并用 patience=1 的验证损失早停。
记录每组的最佳 val_loss、最佳验证准确率、训练准确率与单个 epoch 时间。若 B 的验证准确率为 92.6%,C 为 92.7%,但 C 每个 epoch 慢 35% 且训练/验证差距更大,可以保留 B。一个实用规则是:优先选择“验证准确率距最佳值不超过 0.2 个百分点”的最小解冻范围。
出现这些信号就调整切点
如果扩大范围后,训练准确率明显提高但验证准确率不动,且差距从 3 个百分点扩大到 8 个百分点,说明容量增加没有转化为泛化收益,应把切点向输出端移动。若训练和验证指标都几乎不变,则可能解冻得太少,也可能学习率低到无法有效更新,需要一次只改一个变量验证。
若领域差异很大而小范围微调仍欠拟合,可以依次从 block_13 扩到 block_10、再扩到更早块,每次都重新 compile() 并保持低学习率。不要同时扩大解冻范围、提高学习率和更换数据增强,否则即使结果变好,也无法判断是哪项改动真正有效。