
机器学习与深度学习 / 系统课时
使用 LSTM 与 GRU
使用 LSTM 与 GRU
LSTM 与 GRU 都是在循环状态上加入门控,让模型能选择保留、写入或丢弃信息,从而比普通 RNN 更适合较长依赖。本篇直接比较两者的状态结构、参数量和 Keras 输出,并给出一套可复现的选择方法。
学习目标
- 区分 LSTM 的隐藏状态与记忆状态,以及 GRU 的单状态结构。
- 按输入维度和单元数计算两种循环层的参数规模。
- 用同一输入在 Keras 中验证输出形状和参数量。
门控结构具体差在哪里
LSTM 同时维护隐藏状态 和记忆状态 。遗忘门决定旧记忆保留多少,输入门控制写入多少新信息,输出门决定当前暴露多少记忆。GRU 把状态合并为一个 ,主要使用更新门与重置门,因此结构更紧凑。
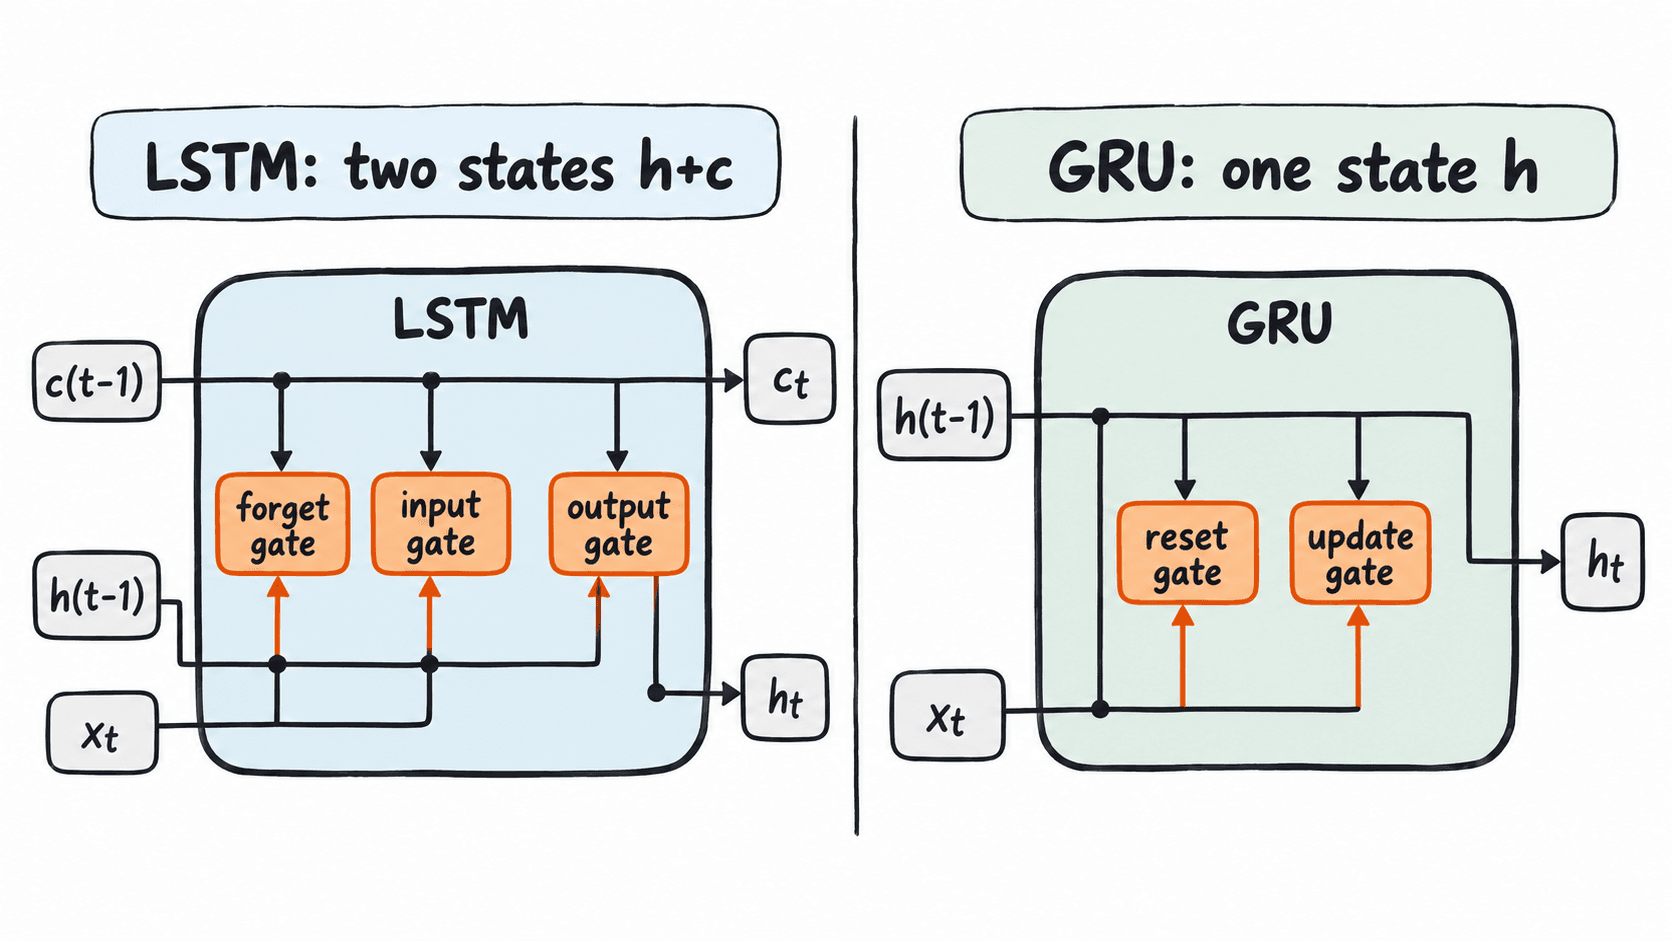
两种结构都不是“越复杂越好”。同样设置 units=8 时,LSTM 有 4 组门相关变换;GRU 通常有 3 组,因此 GRU 参数更少、单步计算也更轻。是否更准仍取决于数据,尤其是序列长度、样本量和依赖跨度。
用参数量做一次可检查的比较
设输入每个时间步有 6 个特征,循环单元数为 8。Keras 的 LSTM 参数量为 480;默认 reset_after=True 的 GRU 参数量为 384。这个差异来自门数量以及 GRU 默认使用的两组偏置。
| 层 | 输入特征 | units | Keras 参数量 |
|---|---|---|---|
LSTM |
6 | 8 | 480 |
GRU |
6 | 8 | 384 |
参数量不是唯一成本。序列长度为 200 时,同一层会执行 200 次循环计算,因此时间维度越长,训练耗时越明显。做基线实验时应保持 embedding 维度、units、batch size 和训练轮数一致,再比较验证指标与每轮耗时。
在 Keras 中直接验证两种层
下面给两种层完全相同的零输入,并开启 return_state=True。LSTM 会返回输出、最终隐藏状态和最终记忆状态;GRU 返回输出与最终隐藏状态。调用后再读取 count_params(),可以核对上面的数字。
import tensorflow as tf

batch = 2
steps = 5
features = 6
units = 8
x = tf.zeros((batch, steps, features))

lstm = tf.keras.layers.LSTM(units, return_state=True)
gru = tf.keras.layers.GRU(units, return_state=True)

lstm_y, lstm_h, lstm_c = lstm(x)
gru_y, gru_h = gru(x)

print(lstm_y.shape, lstm_h.shape, lstm_c.shape)
print(gru_y.shape, gru_h.shape)
print(lstm.count_params(), gru.count_params())
预期输出
(2, 8) (2, 8) (2, 8)
(2, 8) (2, 8)
480 384
如果把 return_sequences=True 也打开,主输出会从 (2, 8) 变为 (2, 5, 8),因为 5 个时间步都会被保留。状态张量仍是 (2, 8),它表示最后一个有效时间步的最终状态。
用同一套实验决定选 LSTM 还是 GRU
实际项目不要只看参数量。可以先固定 units=64、batch size 32、学习率 1e-3、最多训练 10 个 epoch,然后分别替换成 LSTM 与 GRU;使用相同训练集、验证集和随机种子,比较验证损失、目标指标和单轮时间。
如果两者验证指标接近,例如准确率只差 0.2 个百分点,而 GRU 每轮从 42 秒降到 33 秒,可优先考虑 GRU;如果 LSTM 在长文本上稳定多出 2~3 个百分点,再接受其额外计算成本。判断依据应来自同条件验证,而不是“LSTM 一定更强”或“GRU 一定更快”的固定结论。