
机器学习与深度学习 / 系统课时
保存完整模型
保存完整模型
完整模型保存适合需要“一次文件恢复结构、权重、编译配置和优化器状态”的场景。完成本节后,你会使用 Keras 3 的 .keras 格式保存模型,重新加载后验证预测一致,并确认优化器迭代状态能够延续。
学习目标
- 使用
model.save()生成 Keras 3 完整模型文件。 - 通过
load_model()验证结构、权重和 optimizer 状态。 - 区分训练恢复文件与部署导出格式。
.keras 文件实际保存什么
以下流程适用于 TensorFlow 2.16+ 默认使用的 Keras 3。完整 .keras 文件是 Keras 原生模型归档,逻辑上包含模型配置、权重以及已编译模型的 optimizer 状态;因此它比仅保存 .weights.h5 更适合暂停后继续训练。
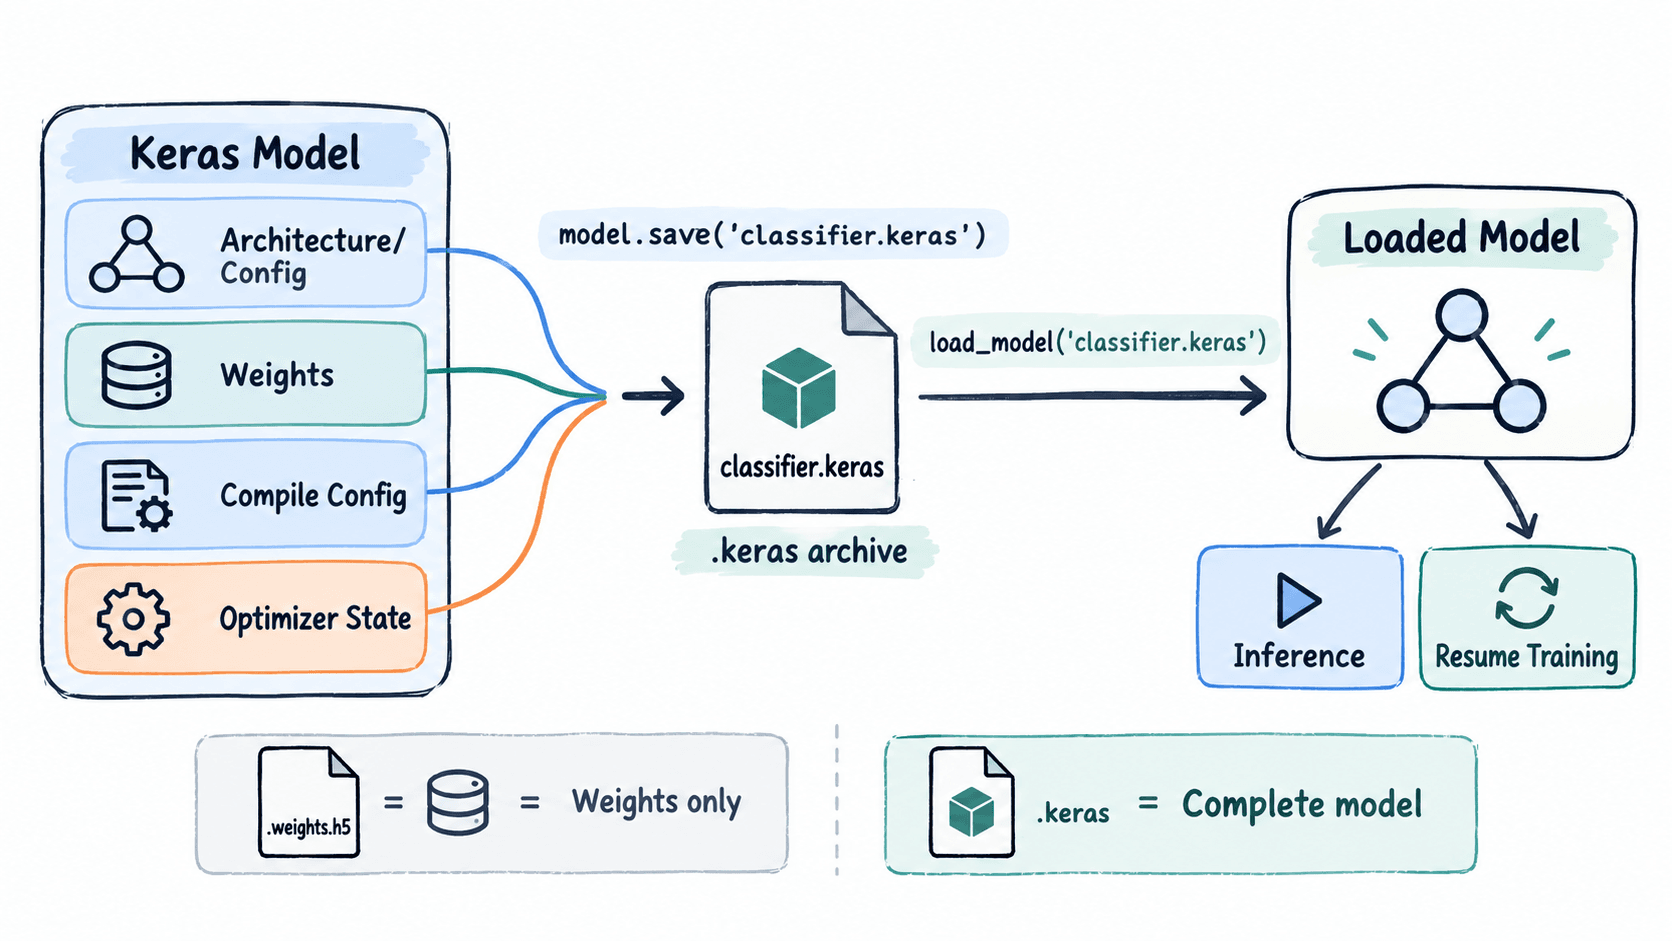
| 保存内容 | 加载后的用途 |
|---|---|
| 模型结构与层配置 | 不必手写同一结构再创建 |
| 模型权重 | 恢复已学习参数 |
| compile 配置 | 默认 compile=True 时恢复训练配置 |
| optimizer 状态 | 可延续 Adam 等优化器的内部状态和迭代计数 |
如果模型包含自定义层或自定义函数,还需要让加载端能识别这些对象;最稳妥的做法是使用 Keras 的可序列化注册机制,而不是假设 .keras 文件会把你的 Python 类源码一起打包。
保存并验证完整模型
下面程序执行一次训练更新后保存模型,再用 tf.keras.models.load_model() 重新加载。验证包含两部分:同一输入的预测应一致,optimizer 的 iteration 也应保持一致;继续训练一次后迭代数应从 1 增加到 2。
import os
import numpy as np
import tensorflow as tf

tf.keras.utils.set_random_seed(11)

# 使用固定数据,让保存前后的预测可以直接做回归比较。
x = np.array(
    [[1.0, 0.0, 2.0], [0.5, 1.5, -1.0]],
    dtype=np.float32,
)
y = np.array([[1.0], [0.0]], dtype=np.float32)

model = tf.keras.Sequential([
    tf.keras.Input(shape=(3,)),
    tf.keras.layers.Dense(6, activation="relu"),
    tf.keras.layers.Dense(1),
])
model.compile(
    optimizer=tf.keras.optimizers.Adam(learning_rate=0.01),
    loss="mse",
)
model.train_on_batch(x, y)

before = model.predict(x, verbose=0)
iteration_before = int(model.optimizer.iterations.numpy())

# .keras 同时保存结构、权重、编译配置和 optimizer 状态。
model_path = "classifier.keras"
model.save(model_path)

loaded = tf.keras.models.load_model(model_path)
after = loaded.predict(x, verbose=0)
iteration_loaded = int(loaded.optimizer.iterations.numpy())

print("model_file_exists:", os.path.exists(model_path))
print("predictions_equal:", np.allclose(before, after, atol=1e-6))
print("optimizer_iterations:", iteration_before, iteration_loaded)

# 再训练一次,验证 optimizer iteration 从保存时的值继续递增。
loaded.train_on_batch(x, y)
print(
    "iteration_after_resume:",
    int(loaded.optimizer.iterations.numpy()),
)
预期输出
model_file_exists: True
predictions_equal: True
optimizer_iterations: 1 1
iteration_after_resume: 2这里的关键验收不是“load_model() 没报错”,而是预测与训练状态都通过检查。生产项目可保留 10~100 条固定回归样本,在发布前逐条比较旧模型与重新加载模型的输出。
处理自定义对象与版本边界
使用内置 Keras 层时,.keras 文件通常可以直接加载。若模型包含自定义 Layer、loss、metric 或 activation,加载端必须能找到对应定义;推荐给自定义对象添加 tf.keras.utils.register_keras_serializable(),或在 load_model() 的 custom_objects 参数中明确传入映射。
团队协作时至少同时记录 TensorFlow/Keras 版本、模型文件和自定义对象代码版本。例如模型由 TensorFlow 2.16+ 的 Keras 3 保存,就应在目标环境先用同一主版本验证加载与回归测试,再升级框架版本。.keras 不会替你保存数据迭代位置、当前 epoch 编号或任意回调对象的外部状态,这些仍需由训练流程单独记录。
不要把训练保存与部署导出混为一谈
.keras 的主要用途是保存和重新加载 Keras 模型;如果目标是 TensorFlow Serving、TFLite 转换或其他推理部署链路,应按目标运行时执行专门导出,而不是把 .keras 文件直接当作服务端模型目录。
在 Keras 3 中,需要导出 TensorFlow SavedModel 推理产物时可使用 model.export("<PATH>");<PATH> 是实际导出目录。部署前应再检查输入 signature、输出张量名与一组固定样本的推理结果,避免“能导出”但服务输入协议不一致。
选择时可以按用途直接判断:只复用参数选 .weights.h5;希望恢复模型、编译配置和优化器状态选 .keras;面向具体推理运行时则使用对应的部署导出流程。