
机器学习与深度学习 / 系统课时
处理序列填充
处理序列填充
文本、点击流和时间序列通常长度不同,但普通批量张量要求同一维度。本课用 pad_sequences 把样本统一到固定长度,再用 Keras 掩码让模型忽略补入的 0,最后明确截断方向与填充值的边界。
学习目标
- 使用
tf.keras.utils.pad_sequences统一变长序列,并验证批次形状。 - 使用
Embedding(mask_zero=True)生成掩码,避免填充值参与后续序列计算。 - 根据任务选择
padding、truncating、maxlen和填充值。
先把变长序列补到同一长度
设三条 token ID 序列长度分别为 3、1、5,而模型希望每条长度都是 4。常见做法是把短序列在末尾补 0,并把过长序列从末尾截断。对自然语言任务,padding="post" 往往更直观,因为真实 token 从位置 0 开始连续排列。
import tensorflow as tf

sequences = [
    [5, 8, 2],
    [7],
    [9, 4, 6, 3, 1],
]

padded = tf.keras.utils.pad_sequences(
    sequences,
    maxlen=4,
    padding="post",
    truncating="post",
    value=0,
)

print(padded)
print("shape:", padded.shape)
预期输出:
[[5 8 2 0]
 [7 0 0 0]
 [9 4 6 3]]
shape: (3, 4)
这里第三条序列的最后一个 token 1 被截掉。如果任务更依赖句尾而不是句首,可改用 truncating="pre" 保留末尾 4 个 token;padding 与 truncating 可以独立设置,不要求方向一致。
用掩码让模型忽略填充值
补齐长度只解决形状问题,0 仍然存在于张量中。对于整数 token ID,最直接的方法是把 0 保留为 padding ID,并让 Embedding 设置 mask_zero=True。Keras 会为非 0 位置产生 True,为 padding 位置产生 False,支持掩码的后续层可据此跳过无效时间步。
import tensorflow as tf

x = tf.constant([
    [5, 8, 2, 0],
    [7, 0, 0, 0],
    [9, 4, 6, 3],
], dtype=tf.int32)

embedding = tf.keras.layers.Embedding(
    input_dim=10,
    output_dim=4,
    mask_zero=True,
)

mask = embedding.compute_mask(x)

print(mask.numpy())
预期输出:
[[ True  True  True False]
 [ True False False False]
 [ True  True  True  True]]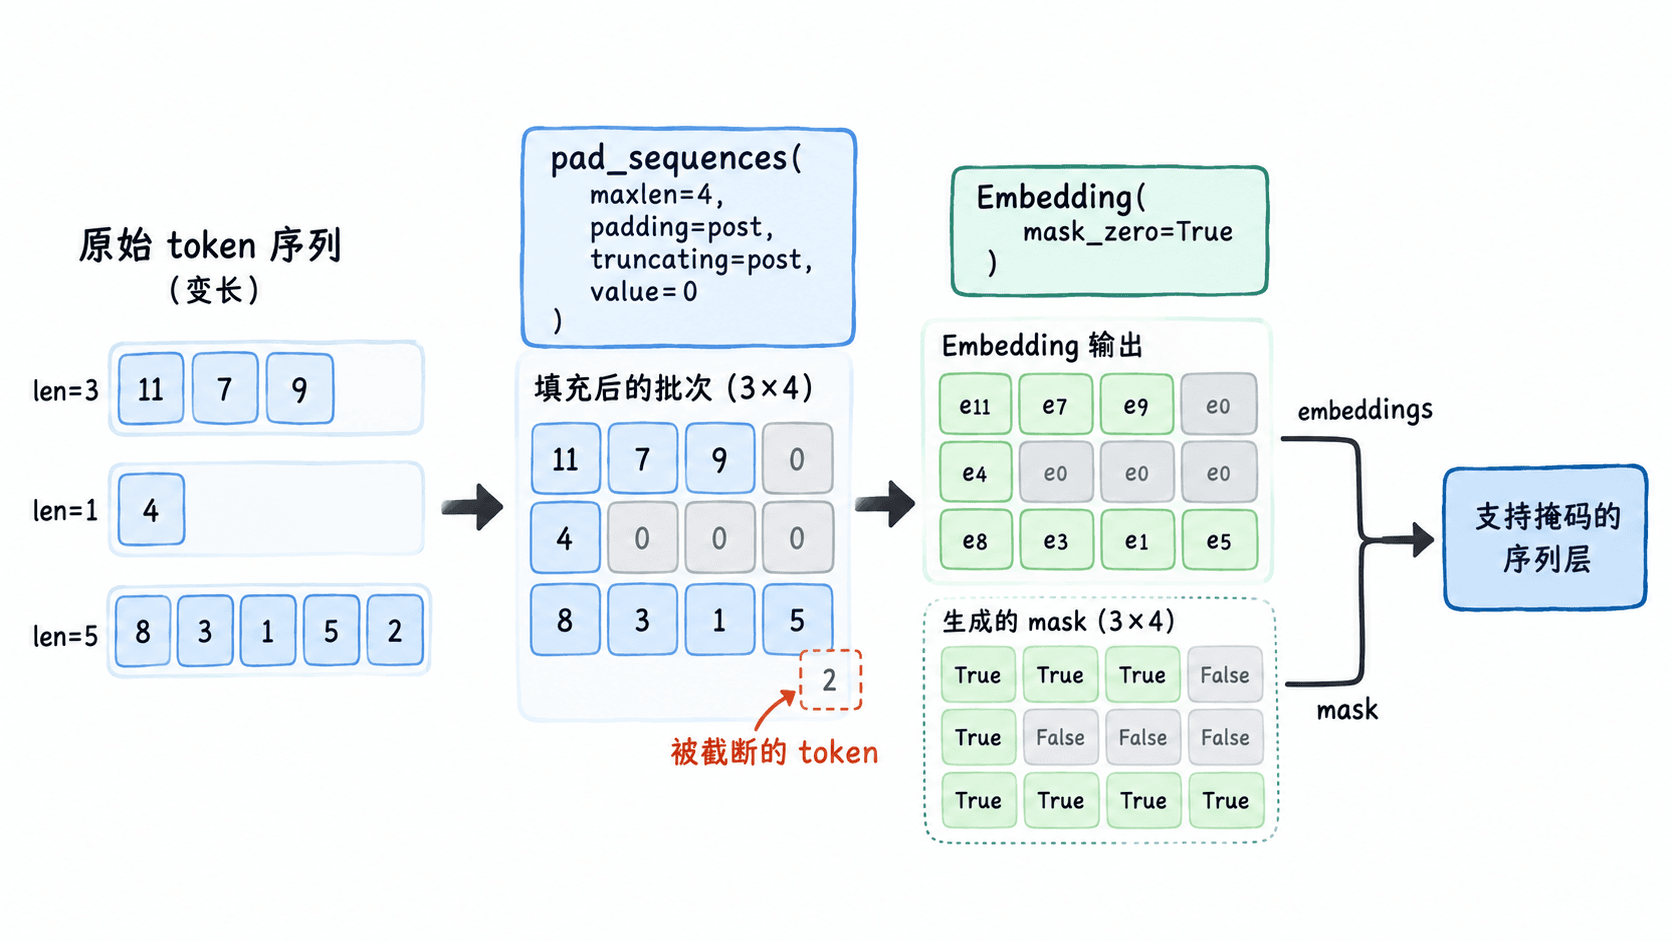
如果 0 本身代表真实词元,mask_zero=True 会把它误当成 padding。此时应先调整词表编号,让真实 token 从 1 开始;input_dim 必须覆盖最大 token ID,例如合法 ID 为 0 到 9999 时,input_dim 至少为 10000。
选择固定长度和截断方向
maxlen 不应凭感觉设置。可以先统计训练集序列长度分位数,例如 P50=42、P90=96、P95=128、P99=310。若显存有限且大多数信息集中在前 128 个 token,可取 maxlen=128;这会完整保留约 95% 的样本,其余样本按所选方向截断。
| 场景 | 建议设置 | 检查点 |
|---|---|---|
| 句子分类,重要信息多在开头 | padding="post",truncating="post" |
长样本被截断后标签语义仍完整 |
| 依赖最近事件的行为序列 | padding="pre",truncating="pre" |
末尾最近事件被完整保留 |
| token ID 使用 0 作为 padding | Embedding(mask_zero=True) |
真实词表不要再占用 ID 0 |
| 连续特征时间步补 0 | Masking(mask_value=0.0) |
被忽略的时间步所有特征都等于 0 |
对于连续特征,Masking(mask_value=0.0) 的判定单位是整个时间步:只有该时间步的所有特征都等于 0.0 才会被标记为无效。因此真实数据可能出现全零向量时,不应直接拿全零作为 padding。
验证掩码是否真的生效
最容易漏掉的错误是“已经补 0,但模型仍把 0 当正常输入”。检查时不要只看张量形状,而要同时确认掩码。一个批次长度为 4 的样本 [7, 0, 0, 0],正确掩码必须是 [True, False, False, False]。
训练前至少抽查一个 batch:确认 padding ID、最大长度、截断方向和布尔 mask 四项完全对应。这样才能保证统一形状没有以“让填充值参与计算”为代价。