
机器学习与深度学习 / 系统课时
使用 Dropout 正则化
使用 Dropout 正则化
Dropout 用训练阶段的随机失活减少网络对少数特征的依赖。本篇用卷积分类器演示 tf.keras.layers.Dropout 的训练与推理差异,并给出 rate 的起始取值、放置位置和判断是否过强的检查方法。
学习目标
- 理解
rate、保留概率和训练期缩放之间的关系。 - 在 Keras 卷积分类器中正确放置并验证 Dropout。
- 根据训练集与验证集的差距调整正则化强度。
Dropout 在训练和推理时做了什么
设 rate=0.5,表示训练时每个输入单元有 50% 概率被置为 0,保留概率为 0.5。被保留的值会乘以 1 / (1 - rate),也就是放大 2 倍,使训练阶段的期望总量与未使用 Dropout 时接近。推理时不会随机丢弃,输入直接通过。
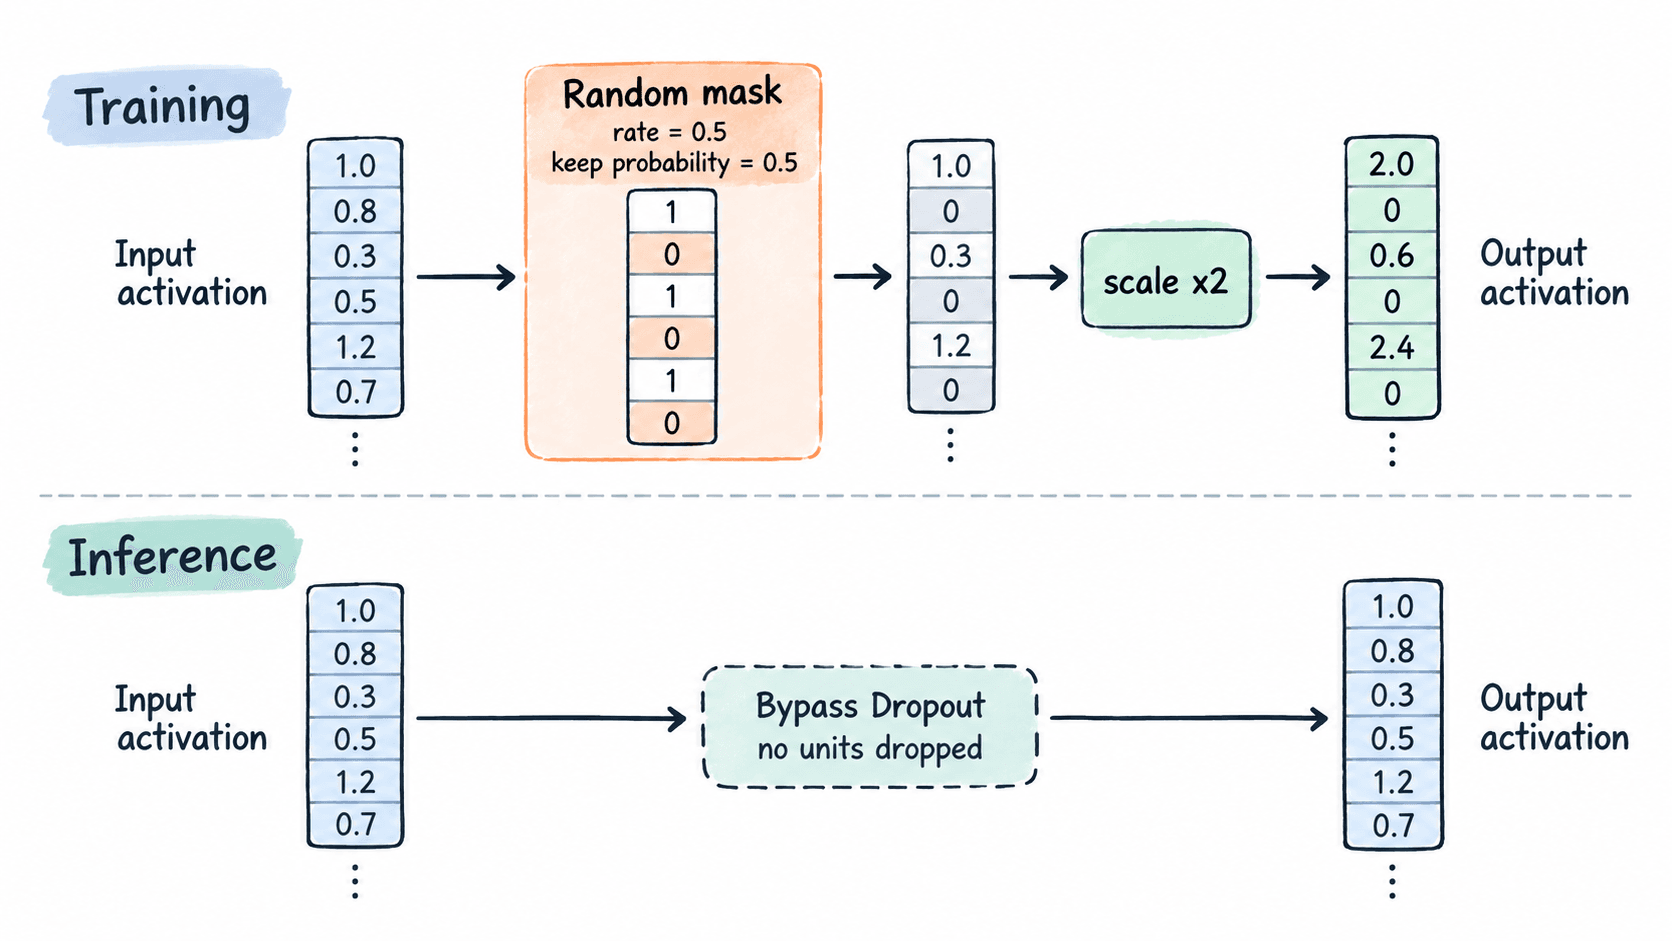
下面的最小示例直接检查这两个行为。training=True 会启用随机失活,training=False 则保持输入不变。
import tensorflow as tf

tf.random.set_seed(7)

x = tf.ones((4096,), dtype=tf.float32)
dropout = tf.keras.layers.Dropout(rate=0.5, seed=7)

y_train = dropout(x, training=True)
y_eval = dropout(x, training=False)

tf.debugging.assert_near(tf.reduce_min(y_train), 0.0)
tf.debugging.assert_near(tf.reduce_max(y_train), 2.0)
tf.debugging.assert_equal(y_eval, x)

print("training values:", sorted(set(y_train.numpy().tolist())))
print("inference unchanged:", bool(tf.reduce_all(y_eval == x).numpy()))
print("output shape:", y_train.shape)
预期输出
training values: [0.0, 2.0]
inference unchanged: True
output shape: (4096,)在卷积分类器中放在哪里
对常见的小型 CNN,可先从分类头的全连接层后加入 Dropout(0.3) 到 Dropout(0.5)。例如卷积部分已经通过池化压缩特征后,Dense(128, activation="relu") 后放 Dropout(0.4),通常比直接在输入图像后丢弃像素更容易控制。
import tensorflow as tf

inputs = tf.keras.Input(shape=(32, 32, 3))
x = tf.keras.layers.Conv2D(32, 3, padding="same", activation="relu")(inputs)
x = tf.keras.layers.MaxPooling2D()(x)
x = tf.keras.layers.Conv2D(64, 3, padding="same", activation="relu")(x)
x = tf.keras.layers.GlobalAveragePooling2D()(x)
x = tf.keras.layers.Dense(128, activation="relu")(x)
x = tf.keras.layers.Dropout(0.4)(x)
outputs = tf.keras.layers.Dense(10)(x)

model = tf.keras.Model(inputs, outputs)
logits = model(tf.zeros((8, 32, 32, 3)), training=False)

print("logits shape:", logits.shape)
print("dropout rate:", model.layers[-2].rate)
预期输出
logits shape: (8, 10)
dropout rate: 0.4
如果希望直接对卷积特征图做正则化,可以比较普通 Dropout 与 SpatialDropout2D。前者按元素随机置零;后者会整张丢弃某些通道,适合相邻像素高度相关、普通逐元素 Dropout 作用偏弱的二维特征图。
用验证曲线选择 rate
不要只因为“模型很大”就固定使用 0.5。先记录无 Dropout 的基线,再观察训练集与验证集的差距。假设第 20 个 epoch 的训练准确率为 98%,验证准确率为 84%,差距达到 14 个百分点,可尝试把分类头设为 Dropout(0.3);若差距仍明显,再增加到 0.4 或 0.5。
| 现象 | 可尝试调整 | 判断依据 |
|---|---|---|
| 训练 98%,验证 84% | rate 从 0 提到 0.3 |
验证指标上升且差距缩小 |
| 训练 91%,验证 89% | 保持 0.2~0.3 | 两者接近且验证性能稳定 |
| 训练 72%,验证 70% | 降低或移除 Dropout | 训练集也学不动,可能正则过强 |
同一次比较应保持数据划分、优化器、学习率和训练轮数不变,否则无法判断性能变化究竟来自 Dropout 还是其他因素。
识别过强和错误用法
rate 太高时,常见信号是训练损失长期偏高、训练准确率也明显低于无 Dropout 基线。对一个只有几万参数的小模型直接使用 Dropout(0.8),每次训练只保留 20% 单元,往往会让有效容量下降过多。
另一个常见错误是在评估代码里显式调用 model(x, training=True)。这样会让预测带随机性,同一张图片多次推理可能得到不同结果。验证、测试和正式推理应使用 training=False,或直接调用 model.predict。