
机器学习与深度学习 / 系统课时
构建文本分类模型
构建文本分类模型
本课把已经转换为整数 token ID 的文本序列接成一个可训练的二分类模型:先用 Embedding 学习词向量,再用双向 LSTM 汇总上下文,最后用 Sigmoid 输出类别概率,并明确 padding 掩码、张量尺寸和训练参数怎样对应。
学习目标
- 能把定长 token 序列接入
Embedding、Bidirectional(LSTM)和分类头。 - 能说明
mask_zero=True对 padding ID 0 的作用,并检查各层张量形状。 - 能根据词表规模、序列长度和类别数调整模型容量与损失函数。
从整数序列到分类概率
假设每条文本已经被编码为长度 6 的整数序列,0 只用于 padding,真实词元使用 1 到 7。输入形状因此是 (batch, 6);Embedding 把每个 ID 变成 8 维向量,得到 (batch, 6, 8),循环层再把整条序列压成一个分类向量。
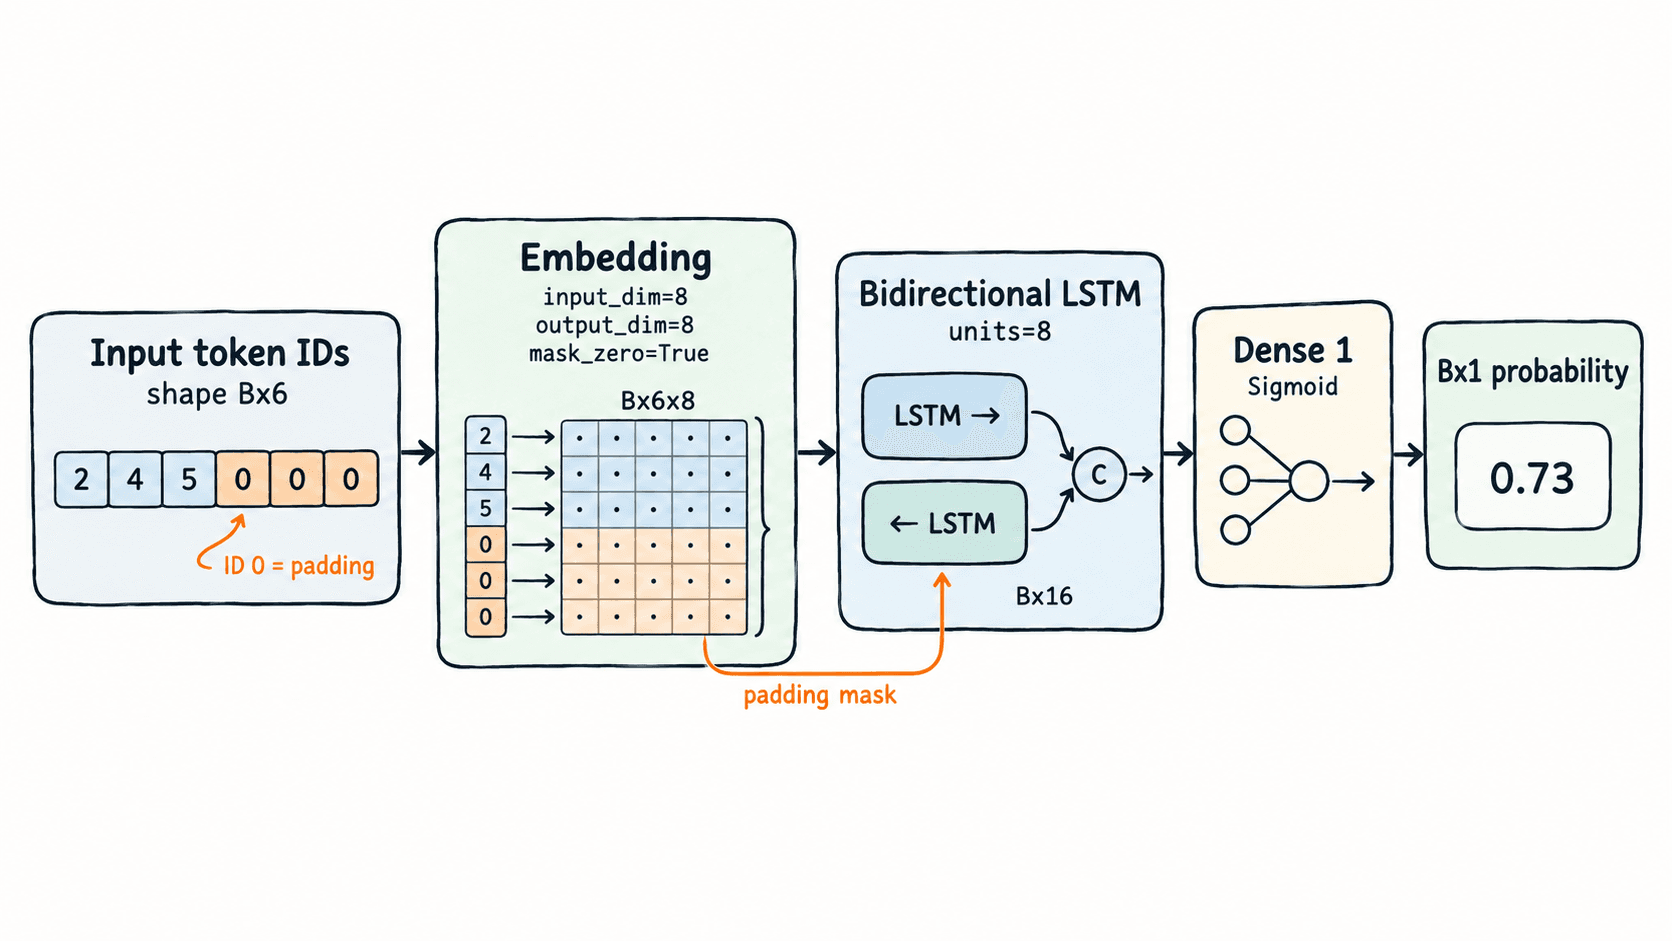
这里选择双向 LSTM,是因为分类时整段文本通常已经完整可见,模型可以同时利用当前位置之前和之后的上下文。若任务是在线逐 token 生成或严格因果预测,就不应使用双向结构,因为它会读取“未来”位置的信息。
组装可训练的模型
下面示例可直接运行,训练数据故意很小,只用于验证模型连接、掩码和输出范围。input_dim=8 表示合法 ID 必须小于 8;mask_zero=True 会把 0 视为 padding,因此不要再把 0 分配给真实词元。
import numpy as np
import tensorflow as tf

tf.keras.utils.set_random_seed(7)

x_train = np.array([
    [2, 4, 5, 0, 0, 0],
    [2, 6, 4, 5, 0, 0],
    [3, 7, 6, 0, 0, 0],
    [3, 5, 7, 6, 0, 0],
    [2, 4, 6, 5, 7, 0],
    [3, 7, 5, 4, 0, 0],
    [2, 5, 4, 0, 0, 0],
    [3, 6, 7, 5, 4, 0],
], dtype=np.int32)
y_train = np.array([1, 1, 0, 0, 1, 0, 1, 0], dtype=np.float32)

inputs = tf.keras.Input(shape=(6,), dtype=tf.int32)
x = tf.keras.layers.Embedding(
    input_dim=8,
    output_dim=8,
    mask_zero=True,
)(inputs)
x = tf.keras.layers.Bidirectional(
    tf.keras.layers.LSTM(8)
)(x)
outputs = tf.keras.layers.Dense(1, activation="sigmoid")(x)

model = tf.keras.Model(inputs, outputs)
model.compile(
    optimizer=tf.keras.optimizers.Adam(learning_rate=0.01),
    loss=tf.keras.losses.BinaryCrossentropy(),
    metrics=["accuracy"],
)
model.fit(x_train, y_train, epochs=20, batch_size=4, verbose=0)

probs = model(x_train, training=False)
print(model.output_shape)
print(tuple(probs.shape))
print(bool(tf.reduce_all((probs >= 0.0) & (probs <= 1.0)).numpy()))
预期输出
(None, 1)
(8, 1)
True
这里不把训练后的具体概率写成固定值,因为随机初始化、硬件内核和 TensorFlow 版本都可能带来细小差异;可稳定验证的是输出形状为每条样本一个概率,且 Sigmoid 结果位于 0 到 1 之间。
看懂掩码和张量尺寸
Embedding(mask_zero=True) 会为非零位置生成有效掩码,支持 masking 的 LSTM 会忽略 padding 位置。默认的 Bidirectional 使用 merge_mode="concat",所以单向 LSTM 的 8 维最终状态会拼成 16 维,再送入一个输出单元。
| 层 | 输入形状 | 输出形状 | 本例关键参数 |
|---|---|---|---|
| Input | (B, 6) |
(B, 6) |
dtype=int32 |
| Embedding | (B, 6) |
(B, 6, 8) |
input_dim=8, mask_zero=True |
| Bidirectional LSTM | (B, 6, 8) |
(B, 16) |
每个方向 units=8 |
| Dense | (B, 16) |
(B, 1) |
activation="sigmoid" |
一个常见错误是把 padding 0 当作普通词继续训练,这会让模型把“补齐了几个位置”误当成文本特征。另一个错误是设置了 mask_zero=True,却把 ID 0 同时分配给某个真实词;这会导致该词在循环层中被当作 padding 跳过。
按真实任务调整容量
实际情感分类可以先从 max_tokens=20000、序列长度 128、Embedding 维度 128、LSTM 单向 64 单元起步。仅 Embedding 参数量就是 20000 × 128 = 2,560,000,若使用 float32,权重约占 9.8 MiB;扩大词表时应先确认内存和训练收益。
二分类保持 Dense(1, activation="sigmoid") 与 BinaryCrossentropy。若改成 5 类主题分类,则把输出改成 Dense(5, activation="softmax"),整数标签配 SparseCategoricalCrossentropy。不要只改输出单元数量却继续使用二元交叉熵。
训练时应保留独立验证集,例如 80% 训练、10% 验证、10% 测试,并让 model.fit 只看到训练与验证数据。若训练准确率继续上升而验证损失连续数轮变差,可先减小 LSTM 单元数、增加 Dropout(0.2),或使用早停,而不是继续堆叠更大的循环层。