
机器学习与深度学习 / 系统课时
部署模型推理服务
部署模型推理服务
在线部署要把训练产物变成稳定的请求契约:进程启动时只加载一次模型,接口校验输入,推理后返回类别与置信度,并用健康检查和错误请求证明服务真的可用。本课用 Keras 模型加 FastAPI 完成一个可直接调用的最小在线服务。
学习目标
- 导出可加载的 Keras 模型与标签文件,并明确服务制品边界。
- 构建带输入校验、健康检查和结构化响应的
/predict接口。 - 用端到端请求验证正常预测与错误输入,建立上线前验收项。
定义服务契约与制品
以下示例采用 Keras 3 原生 .keras 模型文件:model.save() 可保存完整模型,load_model() 可恢复模型;若后续要交给 SavedModel 消费方,可改用 Model.export(..., format="tf_saved_model")。Keras FastAPI 则使用 Pydantic 模型声明 JSON 请求体并执行类型校验。FastAPI
| 制品或接口 | 约定 |
|---|---|
artifacts/classifier.keras |
模型结构与权重 |
artifacts/labels.json |
类别索引到业务标签的映射 |
app.py |
服务入口,进程启动时加载模型 |
GET /health |
返回服务状态、模型版本和类别数 |
POST /predict |
接收 4 个 float 特征,返回类别、置信度和完整分数 |
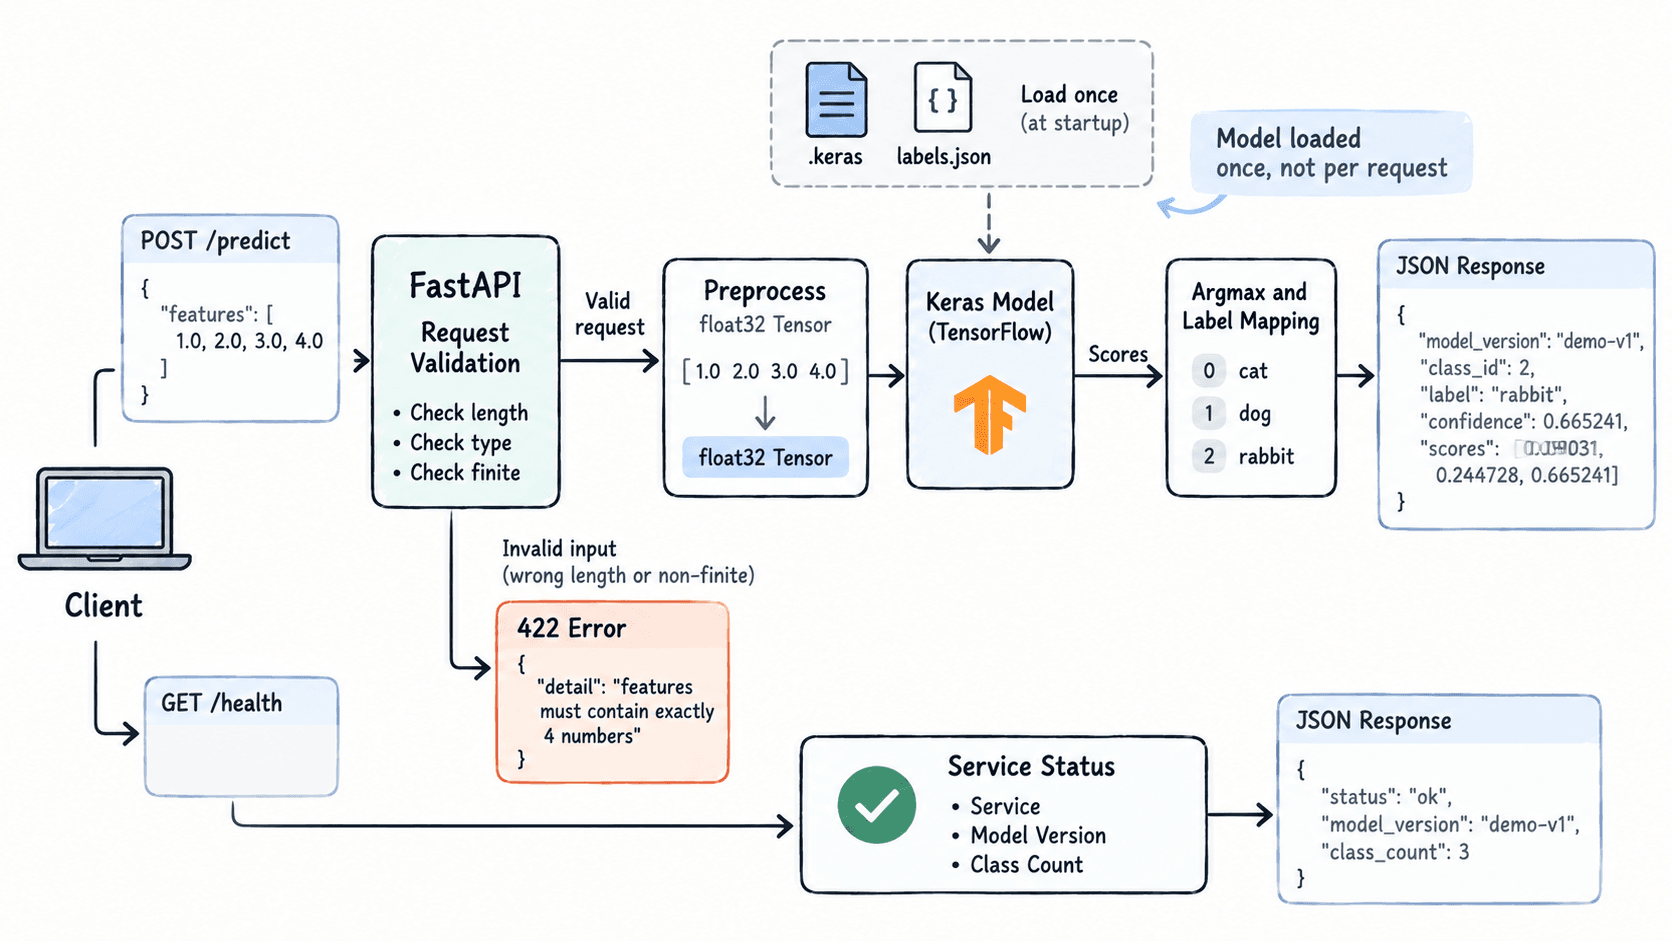
这条链路至少要把“输入结构、预处理、模型版本、标签映射、错误状态码”固定下来。否则同一个模型文件被不同客户端以不同字段顺序、数值范围或标签表调用时,离线指标再高也无法保证在线结果一致。
导出可加载的 Keras 模型
下面用固定权重创建一个 4 特征、3 分类的可复现模型,目的是让接口输出可精确验证。真实项目中可以直接把这里的演示模型替换成训练完成的最佳模型,但仍然保留同样的 .keras 与 labels.json 制品契约。
from pathlib import Path
import json

import numpy as np
import tensorflow as tf

artifact_dir = Path("artifacts")
artifact_dir.mkdir(exist_ok=True)

model = tf.keras.Sequential(
    [
        tf.keras.Input(shape=(4,), name="features"),
        tf.keras.layers.Dense(3, activation="softmax", name="classifier"),
    ]
)

# 先构建变量,再写入固定权重,使演示接口拥有稳定输出。
model(np.zeros((1, 4), dtype=np.float32))
kernel = np.zeros((4, 3), dtype=np.float32)
bias = np.array([0.0, 1.0, 2.0], dtype=np.float32)
model.layers[0].set_weights([kernel, bias])

model.save(artifact_dir / "classifier.keras")
(artifact_dir / "labels.json").write_text(
    json.dumps(["cat", "dog", "rabbit"], ensure_ascii=False),
    encoding="utf-8",
)

print("saved: artifacts/classifier.keras")
print("saved: artifacts/labels.json")
预期输出(TensorFlow 自身的环境初始化日志可能因机器不同而额外出现):
saved: artifacts/classifier.keras
saved: artifacts/labels.json
生产模型如果包含自定义 Layer 或自定义函数,应在导出前确保其可序列化;服务侧不要为了“先跑起来”而关闭安全加载约束或临时复制训练代码来重建网络。
构建 FastAPI 推理接口
课程环境通常已经安装 TensorFlow,只需补齐 Web 服务依赖。下面命令可在独立虚拟环境中执行:
python -m pip install fastapi "uvicorn[standard]" numpy预期结果:
安装命令以退出码 0 结束;具体版本号与下载日志取决于当前软件源。把下面内容保存为 app.py。模型与标签在模块导入阶段加载一次,请求处理函数只做校验、张量转换和前向推理。
from pathlib import Path
import json

import numpy as np
import tensorflow as tf
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel

ARTIFACT_DIR = Path("artifacts")
MODEL_PATH = ARTIFACT_DIR / "classifier.keras"
LABELS_PATH = ARTIFACT_DIR / "labels.json"
MODEL_VERSION = "demo-v1"

model = tf.keras.models.load_model(MODEL_PATH, compile=False)
labels = json.loads(LABELS_PATH.read_text(encoding="utf-8"))

app = FastAPI(title="TensorFlow Inference Service")

class PredictRequest(BaseModel):
    features: list[float]

@app.get("/health")
def health() -> dict:
    return {
        "status": "ok",
        "model_version": MODEL_VERSION,
        "class_count": len(labels),
    }

@app.post("/predict")
def predict(request: PredictRequest) -> dict:
    if len(request.features) != 4:
        raise HTTPException(
            status_code=422,
            detail="features must contain exactly 4 numbers",
        )

    x = np.asarray([request.features], dtype=np.float32)
    if not np.isfinite(x).all():
        raise HTTPException(
            status_code=422,
            detail="features must contain only finite numbers",
        )

    scores = model(x, training=False).numpy()[0]
    class_id = int(np.argmax(scores))

    return {
        "model_version": MODEL_VERSION,
        "class_id": class_id,
        "label": labels[class_id],
        "confidence": round(float(scores[class_id]), 6),
        "scores": [round(float(value), 6) for value in scores],
    }
预期结果:Uvicorn 导入 app.py 时成功加载模型;如果模型文件缺失或不兼容,进程会在启动阶段失败,而不是等到第一个业务请求才暴露问题。
启动并做端到端验收
在项目根目录启动服务,固定监听本机 8000 端口:
uvicorn app:app --host 127.0.0.1 --port 8000预期输出的关键行如下,其他启动日志可能因 Uvicorn 版本不同而略有差异:
INFO: Uvicorn running on http://127.0.0.1:8000保持服务运行,在第二个终端依次验证健康检查、合法预测和长度错误。第三条命令只打印 HTTP 状态码,用来确认接口拒绝错误输入。
curl -s http://127.0.0.1:8000/health
echo
curl -s -X POST http://127.0.0.1:8000/predict -H "Content-Type: application/json" -d '{"features":[1.0,2.0,3.0,4.0]}'
echo
curl -s -o /dev/null -w "%{http_code}\n" -X POST http://127.0.0.1:8000/predict -H "Content-Type: application/json" -d '{"features":[1.0,2.0,3.0]}'
预期输出:
{"status":"ok","model_version":"demo-v1","class_count":3}
{"model_version":"demo-v1","class_id":2,"label":"rabbit","confidence":0.665241,"scores":[0.090031,0.244728,0.665241]}
422
这三个检查分别证明“进程已加载制品”“推理与标签映射一致”“输入边界会返回明确错误”。真正上线前再把同一组固定请求做成冒烟测试,模型升级时即可快速比较响应结构和数值是否发生意外变化。
处理上线边界
当前接口是一请求一条样本,适合最小服务和低延迟调用。若改成批量接口,可先把单批上限设为 32,再根据显存或内存占用压测;不要接受无限长度数组。CPU 部署可以从单 worker 开始测吞吐,GPU 部署也应先用 --workers 1,因为每个独立 worker 通常都会各自加载一份模型,盲目增加进程可能先耗尽显存。
上线验收可先设一组明确但可按业务调整的门槛,例如正常请求成功率不低于 99.9%、p95 延迟不高于 100 ms、非法输入必须返回 4xx、健康检查不执行真实大批量推理。若生产消费方要求 TensorFlow SavedModel,而不是 Python 进程直接加载 .keras,应在制品层切换为 Keras 3 的 Model.export 路径,而不是让 FastAPI 运行时做格式转换。Keras