
机器学习与深度学习 / 系统课时
优化模型效果
优化模型效果
模型优化要在固定基线之上做可归因的实验,而不是同时改十几个参数。这里把优化拆成三类:用 ImageNet 预训练 MobileNetV2 替代从零训练的特征提取器,用 Dropout 与 L2 控制过拟合,再用小规模候选搜索选择头部参数,最后只对骨干尾部做低学习率微调。
学习目标
- 把迁移学习、正则化和超参数搜索放进同一套验证集实验流程
- 用具体搜索空间选择 Dropout、L2 和学习率,而不是凭感觉调参
- 正确解冻预训练骨干尾部,并用低学习率完成微调验收
只改验证集能证明的变量
以下示例使用 CIFAR-10,保留官方测试集不参与搜索,从 50000 个训练样本中固定抽出 5000 个作为验证集。第一阶段冻结 MobileNetV2 骨干,只搜索分类头;第二阶段只对选中的配置做微调。这样每个候选的变化来源明确,也不会把测试集变成隐形验证集。
先把搜索范围限制在能解释的 3 组配置,而不是一次扫几十个值:
| 候选 | Dropout | L2 | 头部学习率 | 适用判断 |
|---|---|---|---|---|
| A | 0.20 | 1e-4 |
3e-4 |
较弱正则,先看上限 |
| B | 0.35 | 1e-4 |
1e-4 |
训练集明显领先验证集时 |
| C | 0.20 | 5e-4 |
1e-4 |
权重过拟合较明显时 |
每个候选只训练 3 个 epoch 用于筛选,再把验证准确率最高的配置重新训练 8 个 epoch。若两个候选差异小于 0.3 个百分点,不要把它当成确定性胜负;可以增加重复运行次数,或者优先选择参数更少、训练更稳定的方案。
迁移学习和正则化组合
MobileNetV2 的 include_top=False 可作为图像特征提取骨干,输入需要按该模型的预处理方式缩放到 [-1, 1]。分类头使用 GlobalAveragePooling2D、Dropout 和带 L2 的 Dense 层;Dropout 只在训练阶段丢弃激活,而 L2 惩罚会加入优化目标。
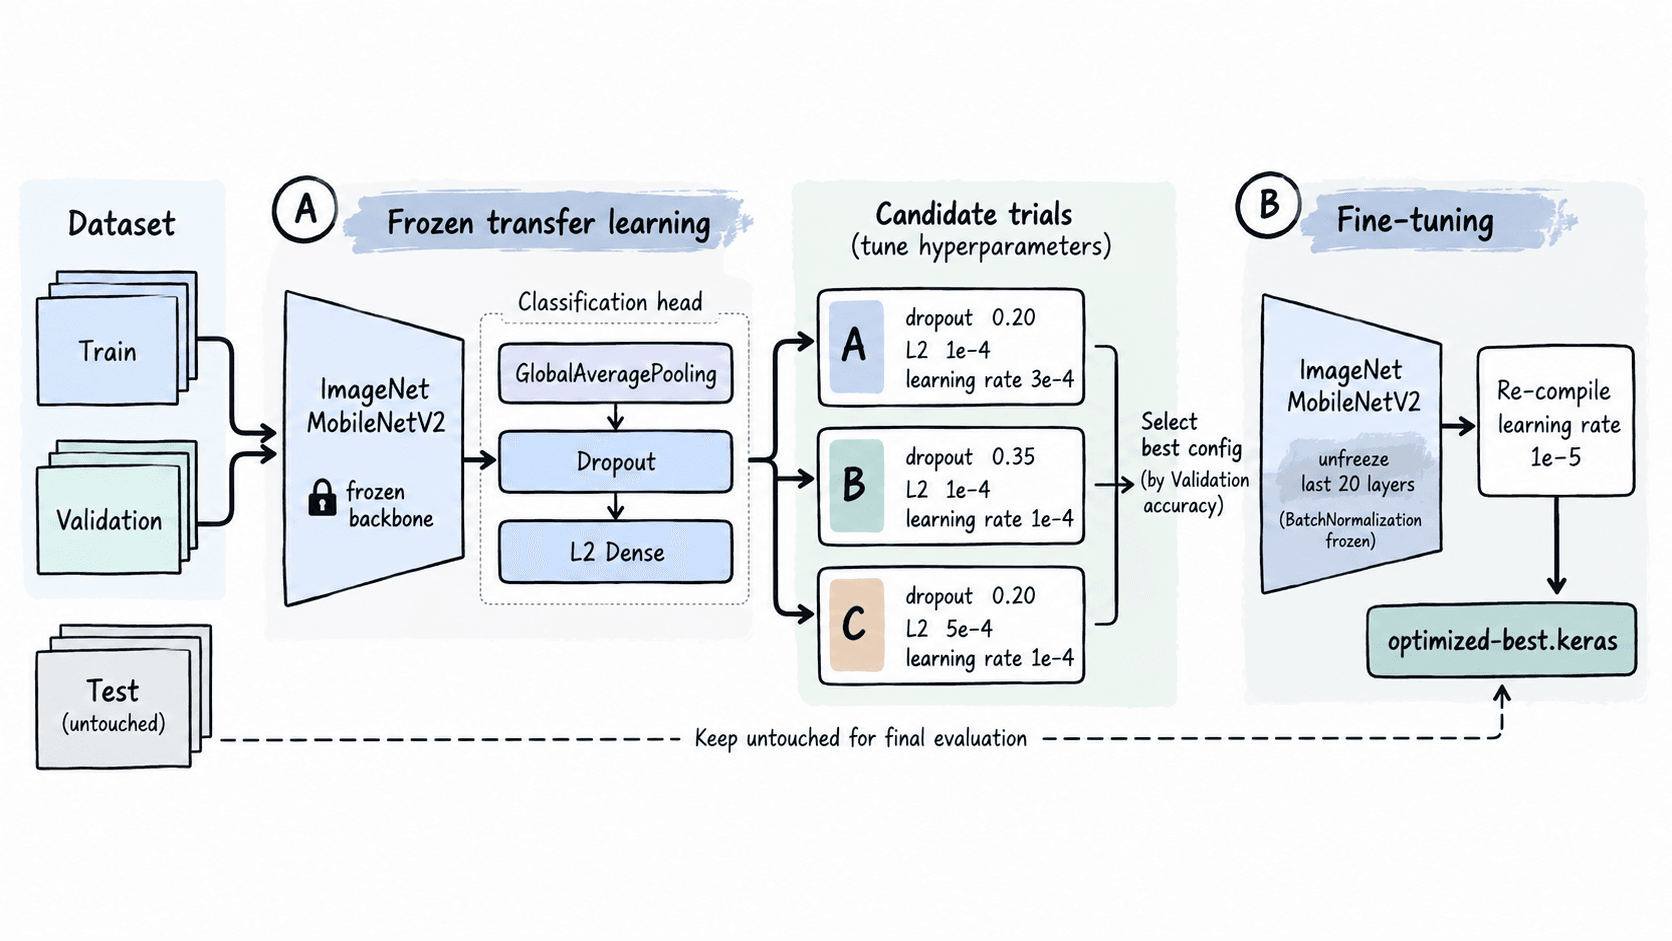
迁移学习并不是把整个骨干一开始就解冻。对于只有几万张图的小数据集,先冻结骨干能避免随机初始化的分类头在早期训练时破坏预训练特征;等头部已经能稳定分类,再解冻末端少量层并把学习率降到 1e-5 量级,通常更容易控制训练漂移。
用小搜索空间选配置
下面的主示例可直接运行。它会下载 CIFAR-10 和 MobileNetV2 的 ImageNet 权重,固定验证集切分,依次试 3 组头部参数;选出最佳配置后重新训练,并只解冻骨干最后 20 层中的非 BatchNormalization 层做微调。每次修改 trainable 后都重新 compile(),确保优化器按新的可训练变量集合工作。
from pathlib import Path

import numpy as np
import tensorflow as tf

SEED = 42
OUT = Path("artifacts/optimized")
OUT.mkdir(parents=True, exist_ok=True)
tf.keras.utils.set_random_seed(SEED)

(x_all, y_all), (x_test, y_test) = tf.keras.datasets.cifar10.load_data()
y_all = y_all.squeeze(-1)
order = np.random.default_rng(SEED).permutation(len(x_all))
val_idx, train_idx = order[:5000], order[5000:]

x_train, y_train = x_all[train_idx], y_all[train_idx]
x_val, y_val = x_all[val_idx], y_all[val_idx]

candidates = [
    {"name": "A", "dropout": 0.20, "l2": 1e-4, "lr": 3e-4},
    {"name": "B", "dropout": 0.35, "l2": 1e-4, "lr": 1e-4},
    {"name": "C", "dropout": 0.20, "l2": 5e-4, "lr": 1e-4},
]

def build_model(dropout, l2, lr):
    base = tf.keras.applications.MobileNetV2(
        include_top=False,
        weights="imagenet",
        input_shape=(96, 96, 3),
    )
    base.trainable = False

    inputs = tf.keras.Input((32, 32, 3))
    x = tf.keras.layers.Resizing(96, 96)(inputs)
    x = tf.keras.applications.mobilenet_v2.preprocess_input(x)
    x = base(x, training=False)
    x = tf.keras.layers.GlobalAveragePooling2D()(x)
    x = tf.keras.layers.Dropout(dropout)(x)
    outputs = tf.keras.layers.Dense(
        10,
        activation="softmax",
        kernel_regularizer=tf.keras.regularizers.L2(l2),
    )(x)

    model = tf.keras.Model(inputs, outputs)
    model.compile(
        optimizer=tf.keras.optimizers.Adam(lr),
        loss=tf.keras.losses.SparseCategoricalCrossentropy(),
        metrics=["accuracy"],
    )
    return model, base

scores = []
for cfg in candidates:
    tf.keras.backend.clear_session()
    tf.keras.utils.set_random_seed(SEED)
    model, _ = build_model(cfg["dropout"], cfg["l2"], cfg["lr"])
    history = model.fit(
        x_train,
        y_train,
        validation_data=(x_val, y_val),
        epochs=3,
        batch_size=128,
        verbose=0,
    )
    score = max(history.history["val_accuracy"])
    scores.append((score, cfg))
    print(f"candidate={cfg['name']} val_accuracy={score:.4f}")

best_cfg = max(scores, key=lambda item: item[0])[1]
print(f"best_config={best_cfg}")

tf.keras.backend.clear_session()
tf.keras.utils.set_random_seed(SEED)
model, base = build_model(
    best_cfg["dropout"],
    best_cfg["l2"],
    best_cfg["lr"],
)

model.fit(
    x_train,
    y_train,
    validation_data=(x_val, y_val),
    epochs=8,
    batch_size=128,
    callbacks=[
        tf.keras.callbacks.EarlyStopping(
            monitor="val_accuracy",
            mode="max",
            patience=2,
            restore_best_weights=True,
        )
    ],
    verbose=0,
)

base.trainable = True
for layer in base.layers[:-20]:
    layer.trainable = False
for layer in base.layers[-20:]:
    if isinstance(layer, tf.keras.layers.BatchNormalization):
        layer.trainable = False

model.compile(
    optimizer=tf.keras.optimizers.Adam(1e-5),
    loss=tf.keras.losses.SparseCategoricalCrossentropy(),
    metrics=["accuracy"],
)

history = model.fit(
    x_train,
    y_train,
    validation_data=(x_val, y_val),
    epochs=5,
    batch_size=128,
    callbacks=[
        tf.keras.callbacks.EarlyStopping(
            monitor="val_accuracy",
            mode="max",
            patience=2,
            restore_best_weights=True,
        ),
        tf.keras.callbacks.ModelCheckpoint(
            OUT / "optimized-best.keras",
            monitor="val_accuracy",
            mode="max",
            save_best_only=True,
        ),
    ],
    verbose=0,
)

best_val = max(history.history["val_accuracy"])
print(f"fine_tune_best_val_accuracy={best_val:.4f}")
print(f"saved={OUT / 'optimized-best.keras'}")
print(f"test_samples_reserved={len(x_test)}")
预期输出
candidate=A val_accuracy=<VALUE>
candidate=B val_accuracy=<VALUE>
candidate=C val_accuracy=<VALUE>
best_config={'name': '<A|B|C>', 'dropout': <VALUE>, 'l2': <VALUE>, 'lr': <VALUE>}
fine_tune_best_val_accuracy=<VALUE>
saved=artifacts/optimized/optimized-best.keras
test_samples_reserved=10000
各个 <VALUE> 由硬件、TensorFlow 版本和训练结果决定。真正需要核对的是:只有验证集参与候选选择;选中配置后才进入微调;保存路径存在;测试样本数量仍为 10000 且没有出现在调参逻辑中。
微调后按门槛验收
优化是否有效要和基线用同一验证协议比较。例如基线 val_accuracy=0.820,优化后为 0.861,绝对提升 4.1 个百分点,可以进入最终测试;如果只从 0.820 提升到 0.823,而训练时间翻倍,就不应仅凭一次运行认定方案有效,应再复跑 2~3 次确认波动范围。
微调阶段最容易犯的错误是把所有预训练层直接解冻并继续使用 1e-3。这种组合会快速改写已经学到的通用特征。这里把可训练范围限制到尾部 20 层,并把学习率降到 1e-5;同时显式冻结 BatchNormalization,避免小批量数据在微调时改写其统计量。
最终只有在模型结构、数据切分和选择规则都冻结后,才加载 optimized-best.keras 对官方测试集做一次性验收。测试集如果不达标,应回到验证集重新定义实验,而不是根据 Test 结果继续试参数,否则测试集就失去独立验收意义。