
机器学习与深度学习 / 系统课时
比较迁移学习效果
比较迁移学习效果
比较迁移学习不能只看“最高准确率”,还要把数据划分、骨干网络、输入尺寸、训练轮数和计时口径固定下来。本节用同一份 CIFAR-10 子集对比从零训练、冻结特征提取和微调,并给出可直接复用的验收标准。
学习目标
- 能设计一个让三种训练策略处在同一实验口径下的对比。
- 能同时记录验证准确率、可训练参数量和训练耗时,而不是只看单个指标。
- 能判断微调带来的提升是否值得额外计算成本,并识别常见的不公平比较。
先固定实验口径
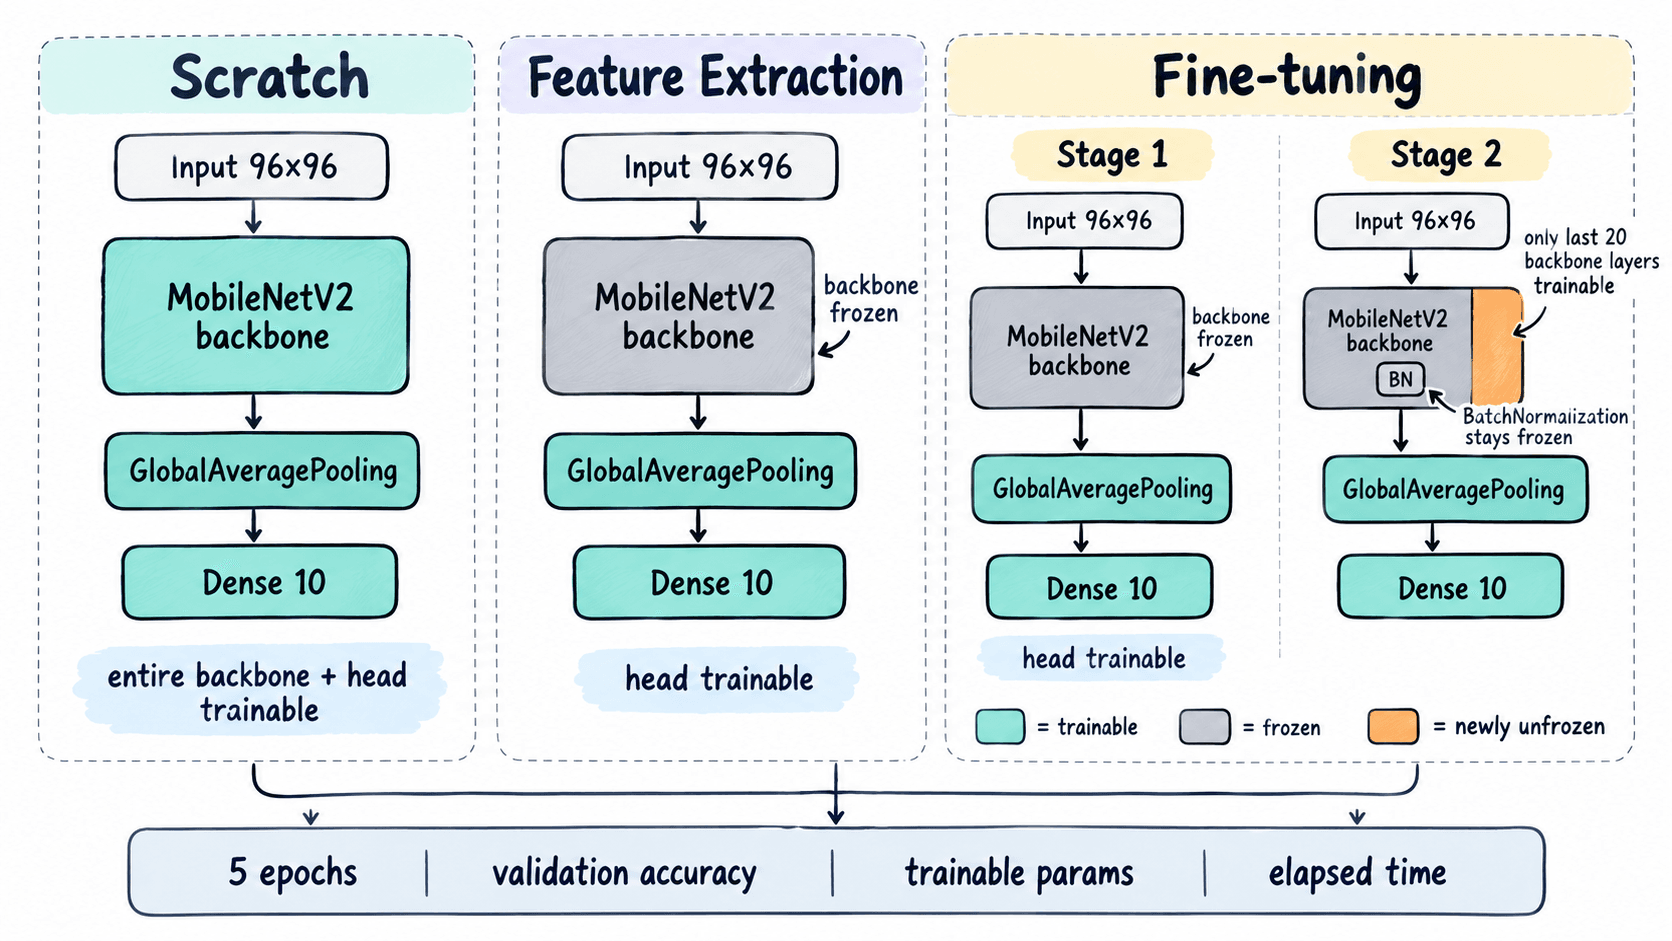
下面的最小实验统一使用 MobileNetV2、96×96 输入、CIFAR-10 的 10000 个训练样本和 2000 个验证样本,批大小为 64。三种策略都使用 5 个 epoch 的总预算,避免“微调多训几轮所以更高”这种无效比较。
| 策略 | 初始化 | 前 3 个 epoch | 后 2 个 epoch | 学习率 |
|---|---|---|---|---|
| 从零训练 | 随机权重 | 全主干可训练 | 全主干可训练 | 1e-3 |
| 特征提取 | ImageNet | 主干冻结 | 主干冻结 | 1e-3 |
| 微调 | ImageNet | 主干冻结 | 只解冻最后 20 层,BN 保持冻结 | 1e-3 → 1e-5 |
微调不是另起一份随机分类头,而是先训练头部,再从这份已经收敛的模型继续解冻。改变 trainable 状态后必须重新 compile,否则优化器不会按新的可训练变量集合工作。
跑一遍可重复的三策略实验
下面脚本只依赖 TensorFlow 和 NumPy。首次运行会下载 CIFAR-10 与 ImageNet 预训练权重;准确率和耗时受 TensorFlow 版本、CPU/GPU 和随机性影响,因此输出用占位值表示,但字段和比较口径固定。
import time
import numpy as np
import tensorflow as tf

tf.keras.utils.set_random_seed(42)

(x_all, y_all), _ = tf.keras.datasets.cifar10.load_data()
y_all = y_all.squeeze()

x_train, y_train = x_all[:10000], y_all[:10000]
x_val, y_val = x_all[10000:12000], y_all[10000:12000]

train_ds = (
    tf.data.Dataset.from_tensor_slices((x_train, y_train))
    .shuffle(10000, seed=42, reshuffle_each_iteration=True)
    .batch(64)
    .prefetch(tf.data.AUTOTUNE)
)
val_ds = (
    tf.data.Dataset.from_tensor_slices((x_val, y_val))
    .batch(64)
    .prefetch(tf.data.AUTOTUNE)
)

def build_model(weights, base_trainable, keep_bn_inference):
    base = tf.keras.applications.MobileNetV2(
        input_shape=(96, 96, 3),
        include_top=False,
        weights=weights,
    )
    base.trainable = base_trainable

    inputs = tf.keras.Input(shape=(32, 32, 3), dtype=tf.uint8)
    x = tf.keras.layers.Resizing(96, 96)(inputs)
    x = tf.keras.layers.Rescaling(1.0 / 127.5, offset=-1.0)(x)

    if keep_bn_inference:
        x = base(x, training=False)
    else:
        x = base(x)

    x = tf.keras.layers.GlobalAveragePooling2D()(x)
    outputs = tf.keras.layers.Dense(10)(x)
    return tf.keras.Model(inputs, outputs), base

def fit_for(model, epochs, lr):
    model.compile(
        optimizer=tf.keras.optimizers.Adam(lr),
        loss=tf.keras.losses.SparseCategoricalCrossentropy(from_logits=True),
        metrics=["accuracy"],
    )
    start = time.perf_counter()
    history = model.fit(
        train_ds,
        validation_data=val_ds,
        epochs=epochs,
        verbose=0,
    )
    elapsed = time.perf_counter() - start
    return history.history["val_accuracy"][-1], elapsed

def trainable_params(model):
    return int(sum(np.prod(v.shape) for v in model.trainable_weights))

scratch, _ = build_model(
    weights=None,
    base_trainable=True,
    keep_bn_inference=False,
)
scratch_acc, scratch_time = fit_for(scratch, epochs=5, lr=1e-3)

feature, _ = build_model(
    weights="imagenet",
    base_trainable=False,
    keep_bn_inference=True,
)
feature_acc, feature_time = fit_for(feature, epochs=5, lr=1e-3)

fine, fine_base = build_model(
    weights="imagenet",
    base_trainable=False,
    keep_bn_inference=True,
)
_, head_time = fit_for(fine, epochs=3, lr=1e-3)

fine_base.trainable = True
for layer in fine_base.layers[:-20]:
    layer.trainable = False
for layer in fine_base.layers[-20:]:
    if isinstance(layer, tf.keras.layers.BatchNormalization):
        layer.trainable = False

fine_acc, tune_time = fit_for(fine, epochs=2, lr=1e-5)
fine_time = head_time + tune_time

print("strategy          val_acc  trainable_params  elapsed_s")
print(
    f"scratch           {scratch_acc:.4f}   "
    f"{trainable_params(scratch):>16}  {scratch_time:.1f}"
)
print(
    f"feature_extract   {feature_acc:.4f}   "
    f"{trainable_params(feature):>16}  {feature_time:.1f}"
)
print(
    f"fine_tune         {fine_acc:.4f}   "
    f"{trainable_params(fine):>16}  {fine_time:.1f}"
)
预期输出
strategy          val_acc  trainable_params  elapsed_s
scratch           <ACC>    <PARAMS>          <TIME>
feature_extract   <ACC>    <PARAMS>          <TIME>
fine_tune         <ACC>    <PARAMS>          <TIME>
<ACC> 会随硬件、库版本和训练随机性变化,<TIME> 是本机秒数;首次下载时间不应计入训练耗时。真正比较时至少重复 3 个随机种子,并记录三次验证准确率的均值和标准差,避免把一次偶然波动当成策略优势。
用三个指标一起做判断
准确率只回答“效果怎样”,可训练参数量和耗时才回答“代价多大”。例如三次重复后,特征提取验证准确率为 0.812±0.004,微调为 0.829±0.006,而总训练时间从 70 秒增加到 150 秒,就意味着约 1.7 个百分点提升换来约 2.1 倍训练时间。
可以先给项目设一个明确门槛:微调至少提升 2 个百分点,且训练时间不超过特征提取的 3 倍,才进入候选方案;若提升不足 1 个百分点,就优先保留冻结主干版本。门槛不是通用真理,但必须在跑实验前写下,避免看到结果后再改标准。
排除不公平比较
最常见的问题不是代码跑错,而是三组实验并不在同一条件下。以下任意一项不同,都可能让结论失真:训练/验证划分、输入尺寸、数据增强、epoch 数、批大小、分类头结构、学习率调度和早停规则。
微调还有两个专属检查点。第一,解冻后要重新 compile;第二,包含 BatchNormalization 的预训练主干应在前向调用时保持 training=False,避免小数据集重新估计批统计量。若微调训练损失继续下降但验证准确率连续 2 个 epoch 下降,应停止并减少解冻层数或降低学习率。
最后把三种策略的代码、随机种子、数据切分索引和指标表一起保存。只有在这些条件可复现时,“迁移学习更快”或“微调更准”才是可审查的实验结论,而不是一次训练日志里的偶然数字。