
机器学习与深度学习 / 系统课时
构建二分类模型
构建二分类模型
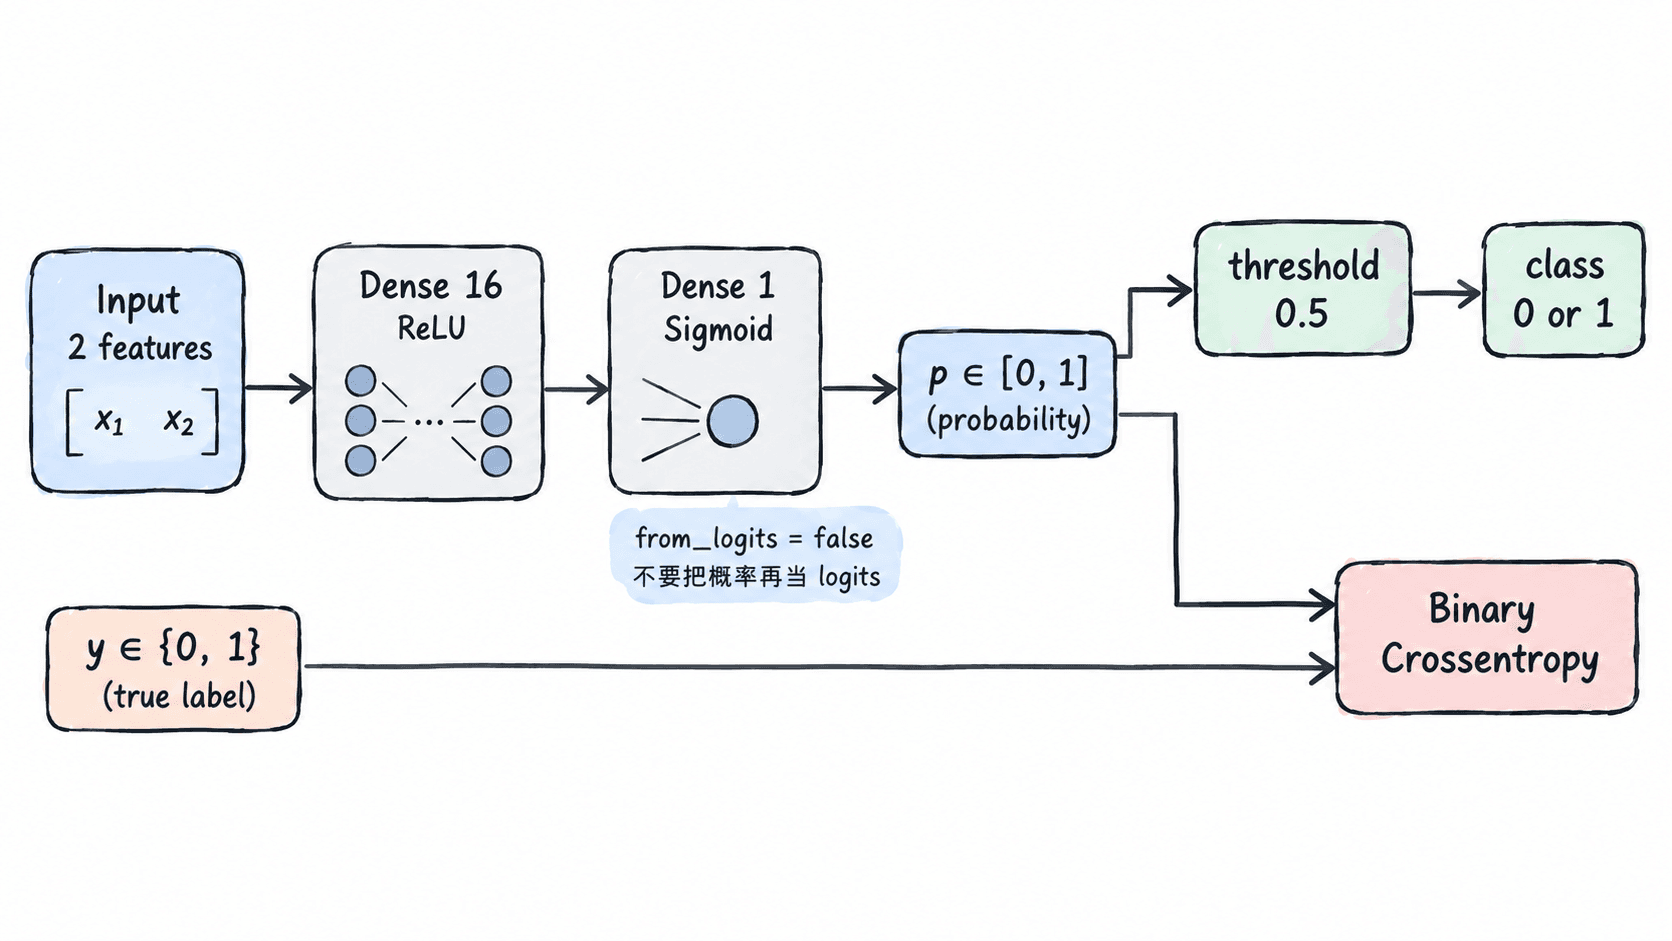
二分类模型要把每个样本映射为“属于正类的概率”。本课用 Dense(1, activation="sigmoid") 输出单个概率,并用二元交叉熵训练;完成后再用 0.5 阈值转成 0/1 类别,同时检查输出形状与损失配置是否匹配。
学习目标
- 能为 0/1 标签配置 Sigmoid 输出层与
BinaryCrossentropy - 能完成一次可运行的二分类训练、评估与预测
- 能识别
from_logits、标签形状和分类阈值的常见配错
输出层与损失必须成对
互斥的二分类只需要一个输出单元。Dense(1, activation="sigmoid") 会把输出限制在 0 到 1,可直接解释为正类概率,因此损失应使用 BinaryCrossentropy(from_logits=False)。训练标签建议使用 float32 的 0/1,并保持为 (N, 1) 与模型输出一致。
| 模型输出 | 损失配置 | 标签示例 |
|---|---|---|
Dense(1, activation="sigmoid") |
BinaryCrossentropy(from_logits=False) |
0.0、1.0 |
Dense(1) |
BinaryCrossentropy(from_logits=True) |
0.0、1.0 |
运行一个最小二分类训练
下面构造 1000 个二维样本,以 x0 + 0.7*x1 > 0 作为真实分类规则。前 800 个样本用于训练,后 200 个样本用于测试;训练集内部再留出 20% 作为验证集。示例适用于 TensorFlow 2.x 的 tf.keras API。
import numpy as np
import tensorflow as tf

tf.keras.utils.set_random_seed(7)
rng = np.random.default_rng(7)

# 生成可分的 0/1 标签,并保持标签形状为 (N, 1)。
x = rng.normal(size=(1000, 2)).astype("float32")
y = (x[:, 0] + 0.7 * x[:, 1] > 0).astype("float32").reshape(-1, 1)

x_train, x_test = x[:800], x[800:]
y_train, y_test = y[:800], y[800:]

model = tf.keras.Sequential([
    tf.keras.layers.Input(shape=(2,)),
    tf.keras.layers.Dense(16, activation="relu"),
    tf.keras.layers.Dense(1, activation="sigmoid"),
])

# Sigmoid 已输出概率,所以 from_logits 必须为 False。
model.compile(
    optimizer=tf.keras.optimizers.Adam(learning_rate=1e-3),
    loss=tf.keras.losses.BinaryCrossentropy(from_logits=False),
    metrics=[tf.keras.metrics.BinaryAccuracy(name="binary_accuracy", threshold=0.5)],
)

model.fit(
    x_train,
    y_train,
    validation_split=0.2,
    epochs=10,
    batch_size=32,
    verbose=0,
)

test_loss, test_acc = model.evaluate(x_test, y_test, verbose=0)
prob = model.predict(x_test[:5], verbose=0)
pred = (prob >= 0.5).astype("int32")

print("output_shape:", model.output_shape)
print("prob_shape:", prob.shape)
print("prob_range_ok:", bool(np.all((prob >= 0.0) & (prob <= 1.0))))
print("pred_shape:", pred.shape)
print("eval_finite:", bool(np.isfinite(test_loss) and np.isfinite(test_acc)))
预期输出
output_shape: (None, 1)
prob_shape: (5, 1)
prob_range_ok: True
pred_shape: (5, 1)
eval_finite: True
训练结束后,先确认输出维度是 1,再确认预测值都位于 [0, 1]。示例不固定打印准确率数值,因为不同 TensorFlow 版本、设备和底层计算实现可能造成轻微差异;eval_finite: True 可用于确认损失与指标没有出现 NaN 或无穷值。
从概率得到类别
Sigmoid 的输出是概率,不是最终类别。最常见的规则是 p >= 0.5 判为 1,否则判为 0;如果漏检正类的代价更高,可以在验证集上把阈值调低,例如 0.3,再比较 Precision 与 Recall。阈值只影响推理判定,不需要改动输出层。
不要用测试集反复挑阈值,否则测试集会参与模型决策。实际项目中应在验证集确定阈值,最后只在测试集做一次最终评估。若类别极度不均衡,单看 BinaryAccuracy 可能失真,应额外记录 Precision、Recall 或 AUC。
常见配错及修正
最危险的错误是输出与损失对概率的解释不一致。Sigmoid 后再设置 from_logits=True,等于把 0 到 1 的概率误当成未归一化 logits;反过来,线性输出配 from_logits=False 也不匹配。两种写法任选一种,但必须成对。
| 错误做法 | 后果 | 修正 |
|---|---|---|
Sigmoid + from_logits=True |
损失解释错误 | 改为 False |
无激活 + from_logits=False |
线性值被当作概率 | 改为 True 或加 Sigmoid |
标签使用 -1/1 |
不符合标准 BCE 目标 | 先映射为 0/1 |
| 把 0.5 阈值写进训练标签 | 概率学习被破坏 | 阈值只用于预测阶段 |
当输出层、损失和标签语义一致后,二分类模型的训练链路就完整了:网络学习一个正类概率,交叉熵负责优化概率分布,阈值负责把概率转换为业务需要的离散类别。