
机器学习与深度学习 / 系统课时
构建图像数据增强
构建图像数据增强
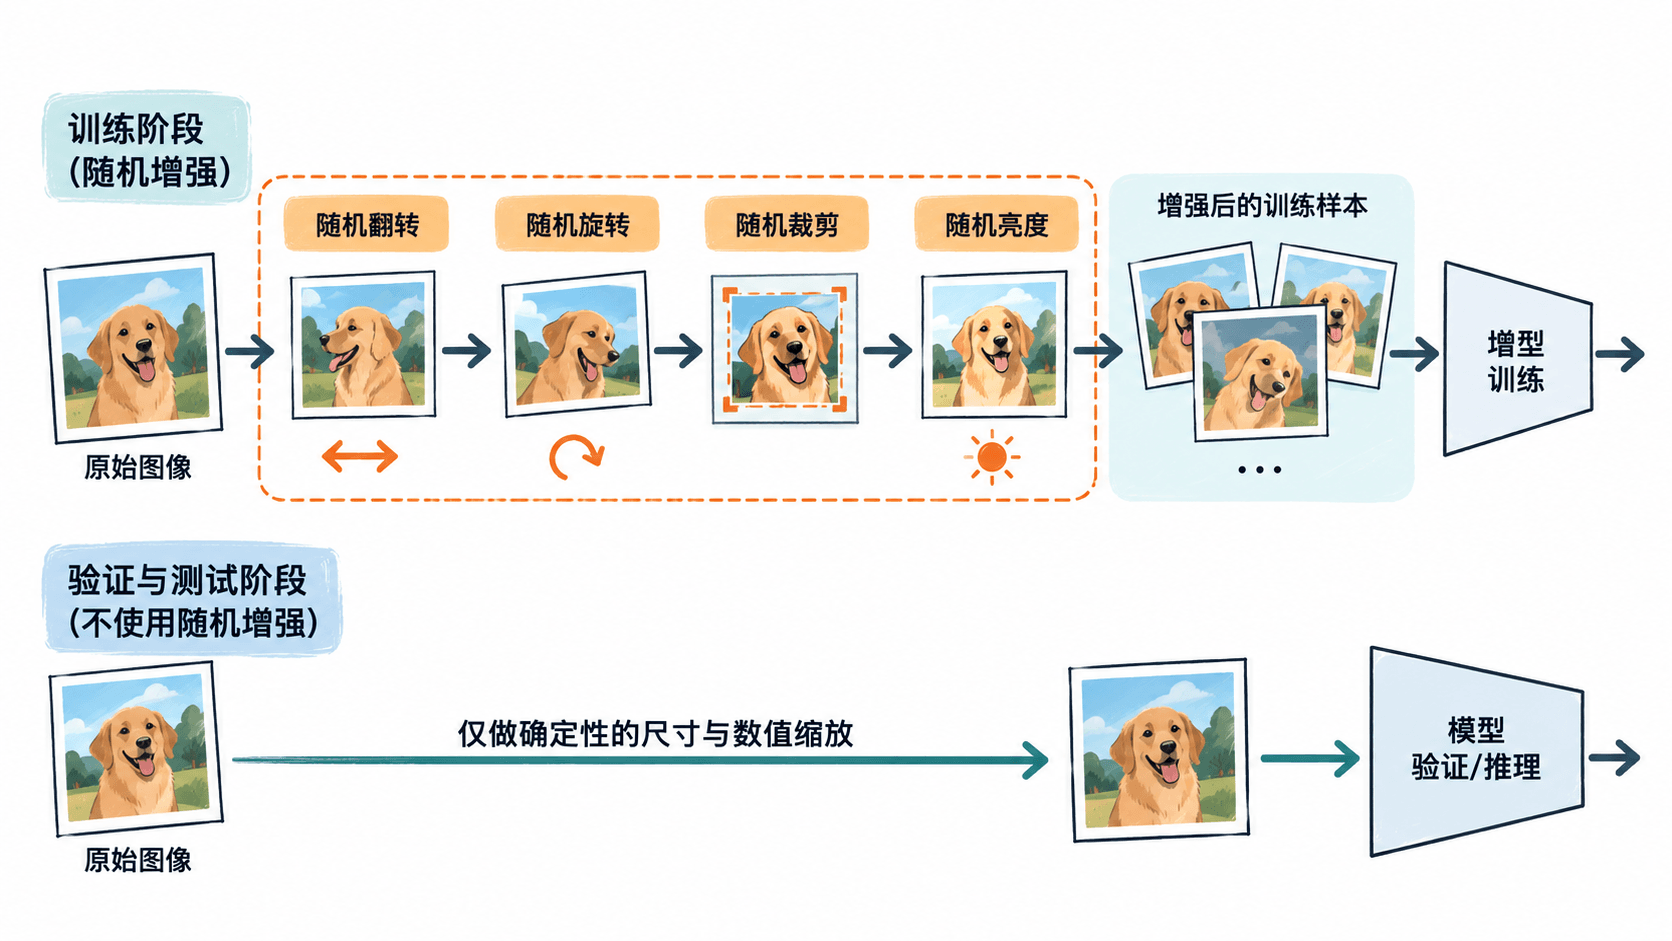
图像增强通过保持标签语义的随机变换增加训练样本多样性。本课用 Keras 随机层建立训练增强,并验证推理路径保持确定;你还会用非均匀输入检查开关,避免全白图片掩盖配置错误。
学习目标
- 按标签语义选择增强幅度
- 使用 Keras 随机增强层并检查 training 开关
- 让验证与推理保持同一预处理契约
选择增强
常见操作包括水平翻转、轻微旋转、缩放、裁剪和颜色扰动。猫狗图片通常可水平翻转,但数字 6 与 9、医学图像方向等场景可能不能随意翻转。
完整示例
在已安装 TensorFlow 的 Python 环境运行。输入使用有空间变化的数值网格,便于确认增强确实改变了内容;全白或全黑图像经过旋转翻转后仍可能相同,不适合单独验证随机增强。
import tensorflow as tf

augmentation = tf.keras.Sequential([
    tf.keras.layers.RandomFlip("horizontal", seed=1),
    tf.keras.layers.RandomRotation(0.05, seed=2),
    tf.keras.layers.RandomZoom(0.1, seed=3),
], name="augmentation")

# 用非均匀图案测试;像素值约定为 [0, 1]。
images = tf.reshape(tf.range(192, dtype=tf.float32) / 191.0, (1, 8, 8, 3))
train_output = augmentation(images, training=True)
inference_output = augmentation(images, training=False)

print("train shape:", train_output.shape)
print("inference shape:", inference_output.shape)
print("inference unchanged:", bool(tf.reduce_all(inference_output == images)))
预期输出:
train shape: (1, 8, 8, 3)
inference shape: (1, 8, 8, 3)
inference unchanged: True
放置位置
增强层可放在模型开头并随模型保存,也可放在训练 Dataset。验证集和测试集不执行随机增强,只做与训练一致的必要尺寸和数值处理。增强放在模型内时由 training 控制;放在 Dataset.map 中并明确传 training=True 时,每次迭代都会增强,不能复用同一个增强后的 Dataset 作为验证集。
随机与复现
种子有助于调试,但不应把某一张随机结果当唯一正确输出,也不能要求每次调用都产生完全相同图像。RandomRotation(0.05) 的幅度是整圈的比例,即约正负 18 度,不是 0.05 度;RandomZoom 的参数则是相对缩放范围。具体语义见 RandomRotation 参考。应验证形状、值域、标签不变性和 training 开关。
效果验收
先可视化增强样本,确认没有裁掉关键目标或制造不可能数据;再比较无增强与有增强的验证指标。训练准确率略降但验证提升可能是合理正则化。
若任务是目标检测或分割,几何变换必须同步作用到框、掩码或关键点;只变图像会让标签与内容错位。分类任务虽然只输出类别,也要检查旋转裁剪是否移除了决定标签的目标。先抽看每类若干样本,再选幅度;不要因为某个变换在猫狗分类有效就直接用于带方向语义的数据。
验收包含三个层次:代码层检查输出形状、有限值和值域,数据层检查图像与标签关系,实验层使用相同数据划分和训练预算比较验证指标。一次种子带来的小幅提升不足以证明泛化改善,必要时重复几次并记录均值。例子只能证明增强层可调用,不代表已经选出适合真实数据的增强策略。