
机器学习与深度学习 / 系统课时
构建图像分类网络
构建图像分类网络
本课解决如何把局部特征提取连接到最终类别预测的问题。你将构建一个完整 CNN 骨架,沿途核对空间尺寸、通道和参数量,再通过概率与标签契约检查它能否进入训练。
学习目标
- 组合卷积与池化层形成分类器
- 正确匹配多分类输出与损失
- 用形状、概率和参数量验收模型
网络的三段结构
基础图像分类器通常包含三段:卷积层提取局部模式,池化层逐步缩小特征图,分类头把高级特征映射为类别概率。输入尺寸和类别数属于任务契约,不能在部署时随意改变。
分类头可使用 GlobalAveragePooling2D 把每个通道汇总为一个值,再接 Dense 输出。它通常比直接 Flatten 更节省参数。
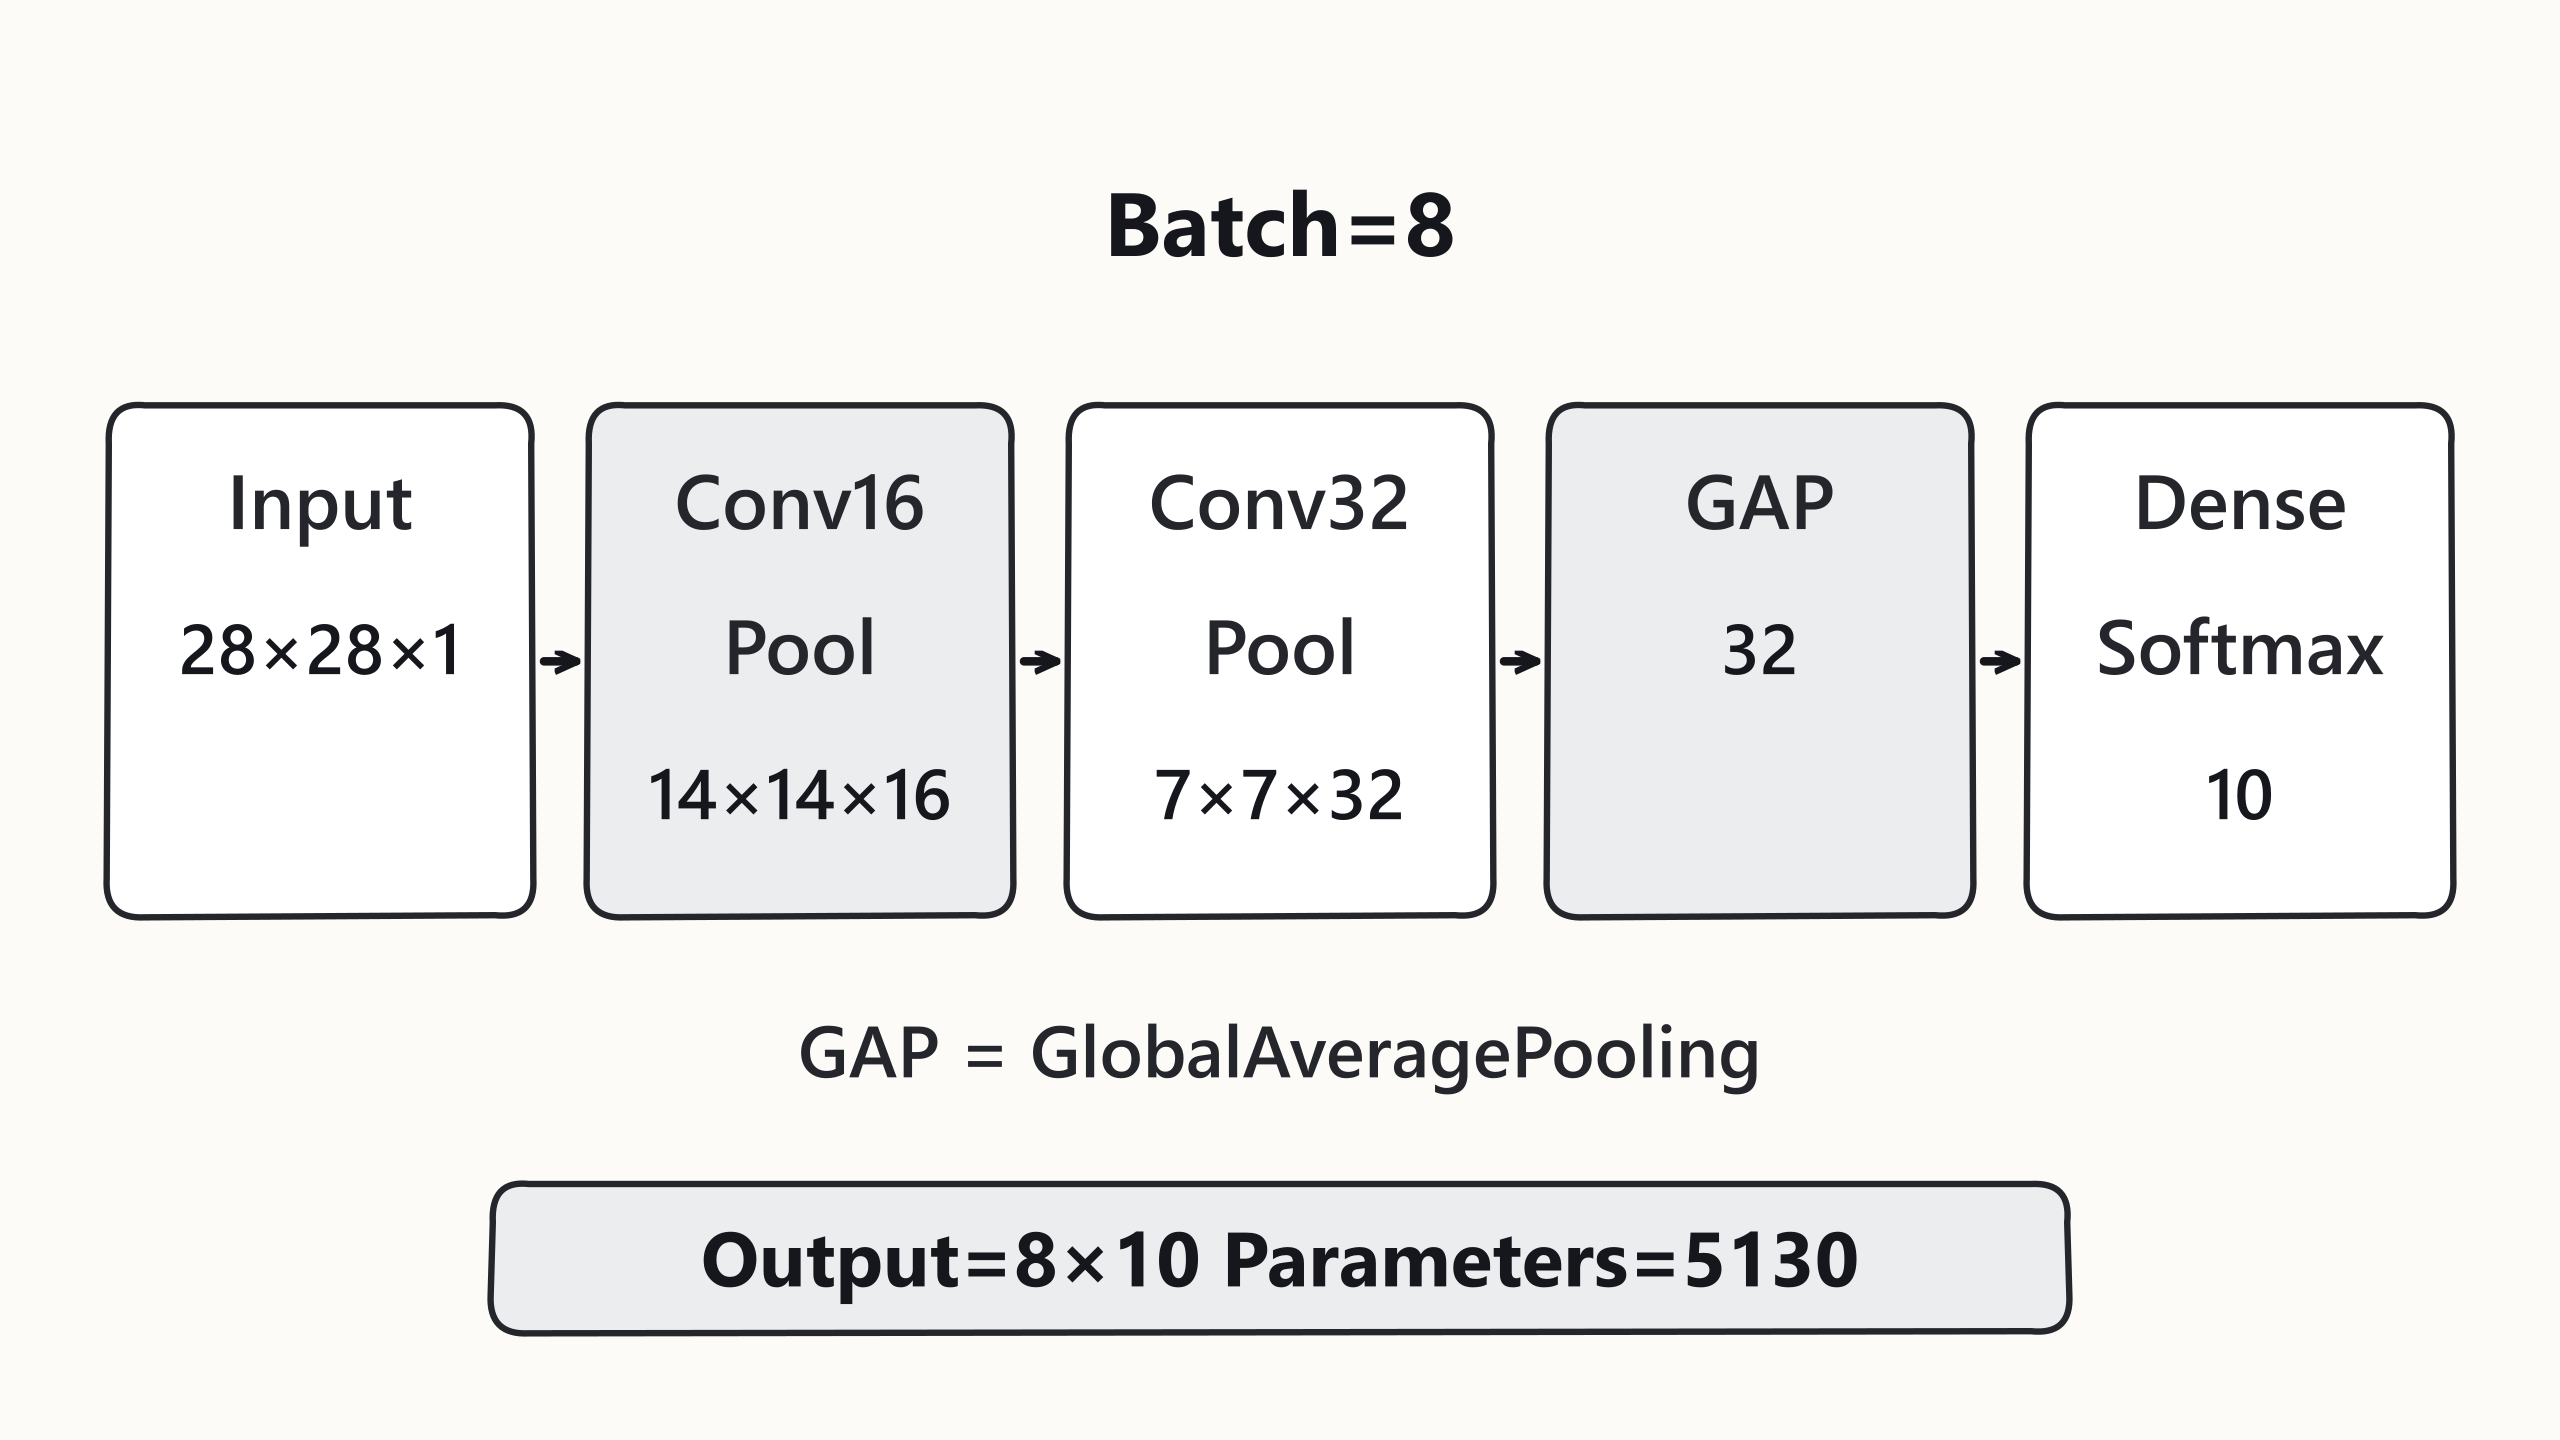
搭建可运行 CNN
在已安装 TensorFlow 的 Python 环境运行示例。输入契约是 28×28 单通道、像素范围 0~255;Rescaling 把它转换为浮点小数。若数据集已经归一化到 0~1,就不应再次除以 255,否则有效信号会被缩小。
import tensorflow as tf

num_classes = 10

model = tf.keras.Sequential([
    tf.keras.Input(shape=(28, 28, 1)),
    # 输入是 0~255,归一化只执行一次。
    tf.keras.layers.Rescaling(1.0 / 255),
    tf.keras.layers.Conv2D(16, 3, padding="same", activation="relu"),
    tf.keras.layers.MaxPooling2D(),
    tf.keras.layers.Conv2D(32, 3, padding="same", activation="relu"),
    tf.keras.layers.MaxPooling2D(),
    tf.keras.layers.GlobalAveragePooling2D(),
    tf.keras.layers.Dense(num_classes, activation="softmax")
])

batch = tf.zeros((8, 28, 28, 1), dtype=tf.uint8)
probabilities = model(batch)

print("输出形状:", probabilities.shape)
print("概率归一化:", bool(tf.reduce_all(tf.abs(tf.reduce_sum(probabilities, axis=1) - 1.0) < 1e-6)))
print("参数量:", model.count_params())
预期输出:
输出形状: (8, 10)
概率归一化: True
参数量: 5130
两次 same 卷积保留空间尺寸,两次默认 2×2 池化把 28 降为 14 再降为 7。最后得到 7×7×32 的特征图;全局平均池化按空间位置求平均,保留 32 个通道值,Dense 再映射为 10 类。它不是把整张图只压成一个数字。GlobalAveragePooling2D 参考说明了输入输出形状。
参数量也能手算:第一卷积为 (3×3×1+1)×16=160,第二卷积为 (3×3×16+1)×32=4640,Dense 为 (32+1)×10=330,总计 5130;池化与缩放不增加可训练参数。计数不符时先查通道、bias 和分类头。
编译配置
整数类别标签使用 sparse_categorical_crossentropy,独热标签使用 categorical_crossentropy。若输出层不使用 Softmax,而是直接输出 logits,应把损失的 from_logits 设置为 True。指标可先使用准确率,再根据类别分布补充宏平均 F1 和混淆矩阵。
训练前验收
用一个小批次先执行前向计算,确认输入类型、输出形状、概率和与参数量。再用少量样本尝试过拟合:若模型连几十个训练样本都学不会,应先检查标签、预处理、损失配置和学习率,而不是投入完整训练。
本例未训练,零输入下得到的概率只是网络输出形式,不说明模型认识任何图片。整数标签还必须在 0~9 范围内,批次标签与图像一一对应;把外部类别编号 1~10 直接交给损失会造成错位或越界。
进入正式训练前,先用固定的小样本检查损失可以计算、梯度有限且参数确实更新,再尝试小样本过拟合。即使训练集表现很好,也需要独立验证集评估泛化;输出概率和为 1 只证明 Softmax 的数学约束,并不证明预测可信或类别均衡。