
机器学习与深度学习 / 系统课时
配置模型编译参数
配置模型编译参数
model.compile() 不会开始训练,它先定义训练时采用的优化器、损失函数和评价指标。配置正确的关键是让模型输出形式、标签编码与损失函数彼此匹配,并把“用于反向传播的 loss”和“只用于观察效果的 metrics”区分开。
学习目标
- 能根据任务选择
optimizer、loss与metrics的实际对象和参数。 - 能判断 logits、概率、整数标签与 one-hot 标签应配哪一种交叉熵。
- 能用一次确定性的评估检查编译配置是否生效。
compile 建立的训练契约
对监督学习来说,loss 把 y_true 与模型输出 y_pred 变成标量损失;优化器根据该损失产生的梯度更新可训练权重;metrics 同样读取标签和预测,但默认只负责累计与报告指标,不直接决定梯度方向。
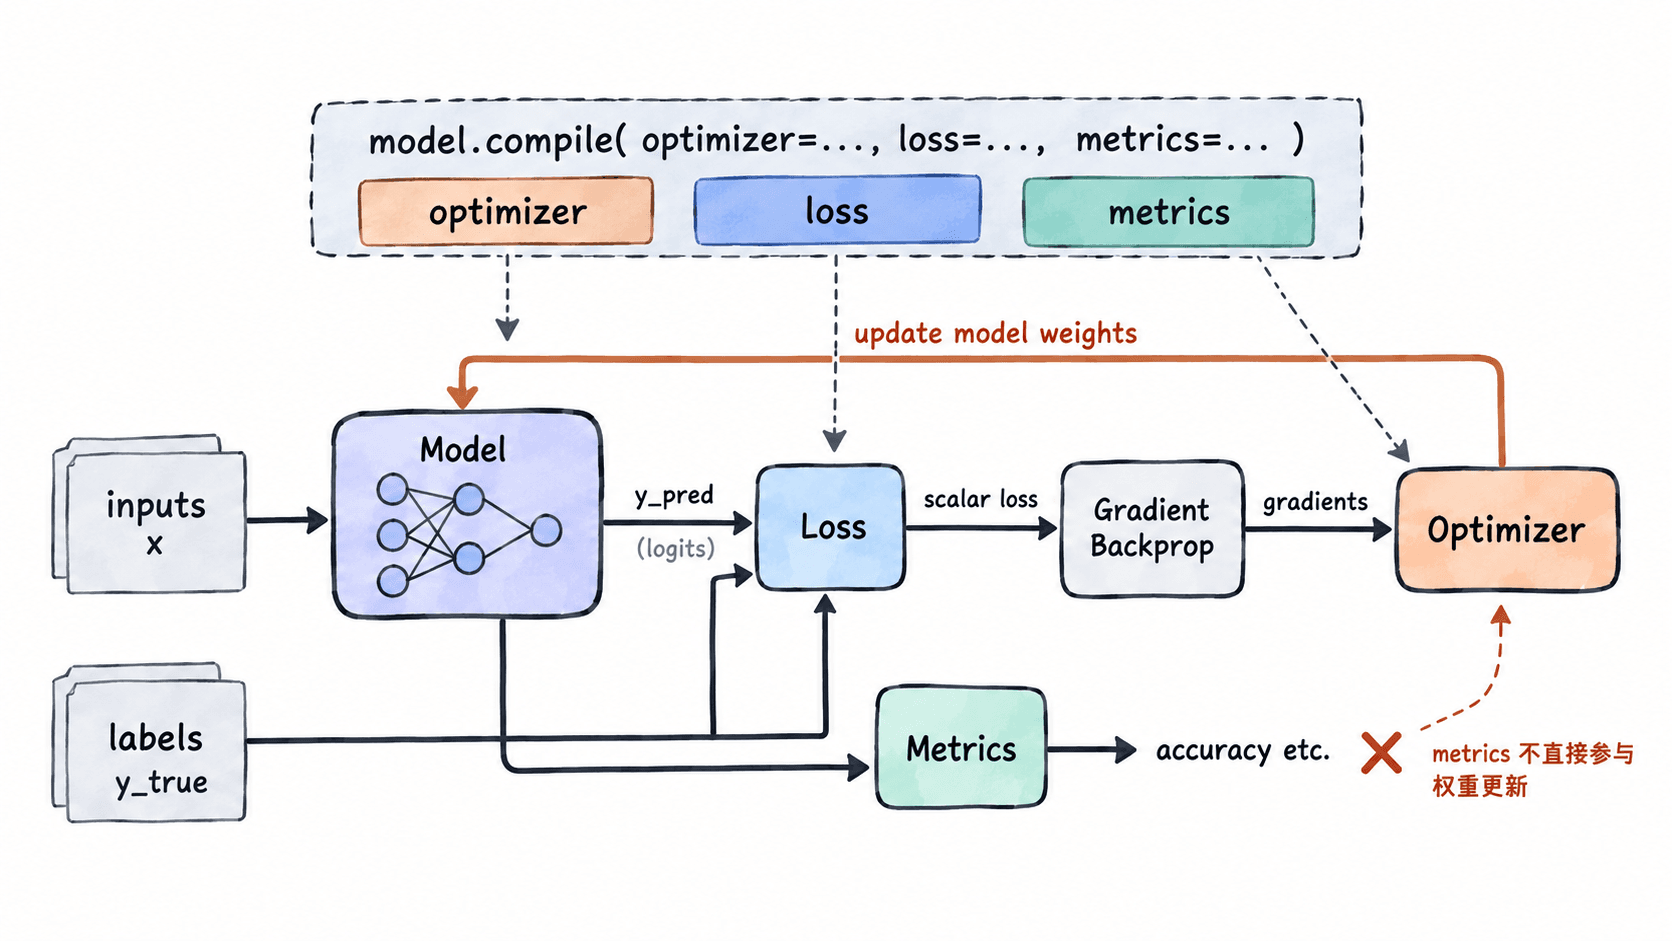
分类任务中,一套常用起点是 Adam 学习率 1e-3。学习率不是越大越快:若 loss 大幅震荡,可先尝试降到 3e-4 或 1e-4;若收敛稳定但过慢,再结合批大小和学习率调度器调整,而不是只换优化器名称。
用确定性样本验证配置
下面构造一个 3 分类模型,并把最后一层权重和偏置都初始化为 0,因此四条样本的 logits 全为 [0, 0, 0]。这样可以得到可核对的损失和准确率,而不会受随机初始化影响。
import tensorflow as tf

model = tf.keras.Sequential([
    tf.keras.Input(shape=(4,)),
    tf.keras.layers.Dense(
        3,
        kernel_initializer="zeros",
        bias_initializer="zeros",
    ),
])

model.compile(
    optimizer=tf.keras.optimizers.Adam(learning_rate=1e-3),
    loss=tf.keras.losses.SparseCategoricalCrossentropy(from_logits=True),
    metrics=[tf.keras.metrics.SparseCategoricalAccuracy(name="accuracy")],
)

x = tf.zeros((4, 4), dtype=tf.float32)
y = tf.constant([0, 1, 2, 0], dtype=tf.int32)

result = model.evaluate(x, y, verbose=0, return_dict=True)
print(f"loss: {result['loss']:.4f}")
print(f"accuracy: {result['accuracy']:.2f}")
print(f"learning rate: {float(model.optimizer.learning_rate.numpy()):.3f}")
预期输出
loss: 1.0986
accuracy: 0.50
learning rate: 0.001
因为三类 logits 都相同,交叉熵为 ;argmax 会选索引 0,而四个标签中有两个是 0,所以准确率为 0.50。这个检查同时验证了损失、指标和优化器学习率是否按配置生效。
对齐输出、标签与损失
最容易出错的是 from_logits 与标签编码。最后一层没有 softmax,输出是 logits,就让交叉熵内部完成数值稳定的 softmax 计算;如果模型已经输出概率,则保持 from_logits=False。
| 模型输出 | 标签形式 | 推荐损失 |
|---|---|---|
Dense(C) logits |
整数 0..C-1 |
SparseCategoricalCrossentropy(from_logits=True) |
Dense(C, activation="softmax") |
整数 0..C-1 |
SparseCategoricalCrossentropy(from_logits=False) |
Dense(C) logits |
one-hot 长度 C |
CategoricalCrossentropy(from_logits=True) |
| 单个二分类 logit | 0/1 |
BinaryCrossentropy(from_logits=True) |
指标也要与标签形式对应。整数类别标签用 SparseCategoricalAccuracy 最直接;one-hot 标签用 CategoricalAccuracy。指标名称可以自定义,例如 name="accuracy",这样训练日志和 History.history 中的键更稳定。
编译选项怎样用于排错
在 TensorFlow 2.16 对应的 tf.keras API 中,compile() 还提供 run_eagerly、steps_per_execution 与 jit_compile 等执行选项。常规训练可保持 run_eagerly=False;自定义层报错位置难定位时,可临时改成 run_eagerly=True 观察 Python 级堆栈,定位后再关闭。
steps_per_execution=1 是最容易调试的设置;把它调大可能减少 Python 调度开销,但回调的 batch 级触发频率也会随之变化。jit_compile="auto" 可让支持的模型尝试编译优化,不应在还没确认数值正确前把性能选项当成首要变量。
配置完成后的验收顺序很明确:先用一个小批次 evaluate() 或 train_on_batch() 验证标签形状和 loss 能正常计算,再开始完整 fit();如果一上来就出现 shape mismatch 或 loss 为 nan,先检查输出维度、标签编码和 from_logits,再检查学习率。