
机器学习与深度学习 / 系统课时
认识人工智能与深度学习
认识人工智能与深度学习
人工智能、机器学习和深度学习经常被混在一起使用,但它们解决问题的方式并不相同。本课先建立三者的包含关系,再用具体任务判断什么情况值得采用深度学习,以及模型训练时数据、误差和参数怎样形成闭环。
学习目标
- 区分人工智能、机器学习与深度学习的范围和关系
- 理解深度学习通过数据、损失和参数更新完成训练的基本过程
- 能根据数据规模与数据类型判断是否适合采用深度学习
三者是什么关系
人工智能是最宽的概念,只要系统表现出感知、推理、规划或决策能力,都可以归入这个范围。机器学习是其中一类方法:不把全部规则手工写死,而是让程序从样本中估计参数。深度学习又是机器学习的一部分,主要使用多层神经网络从数据中学习表示。
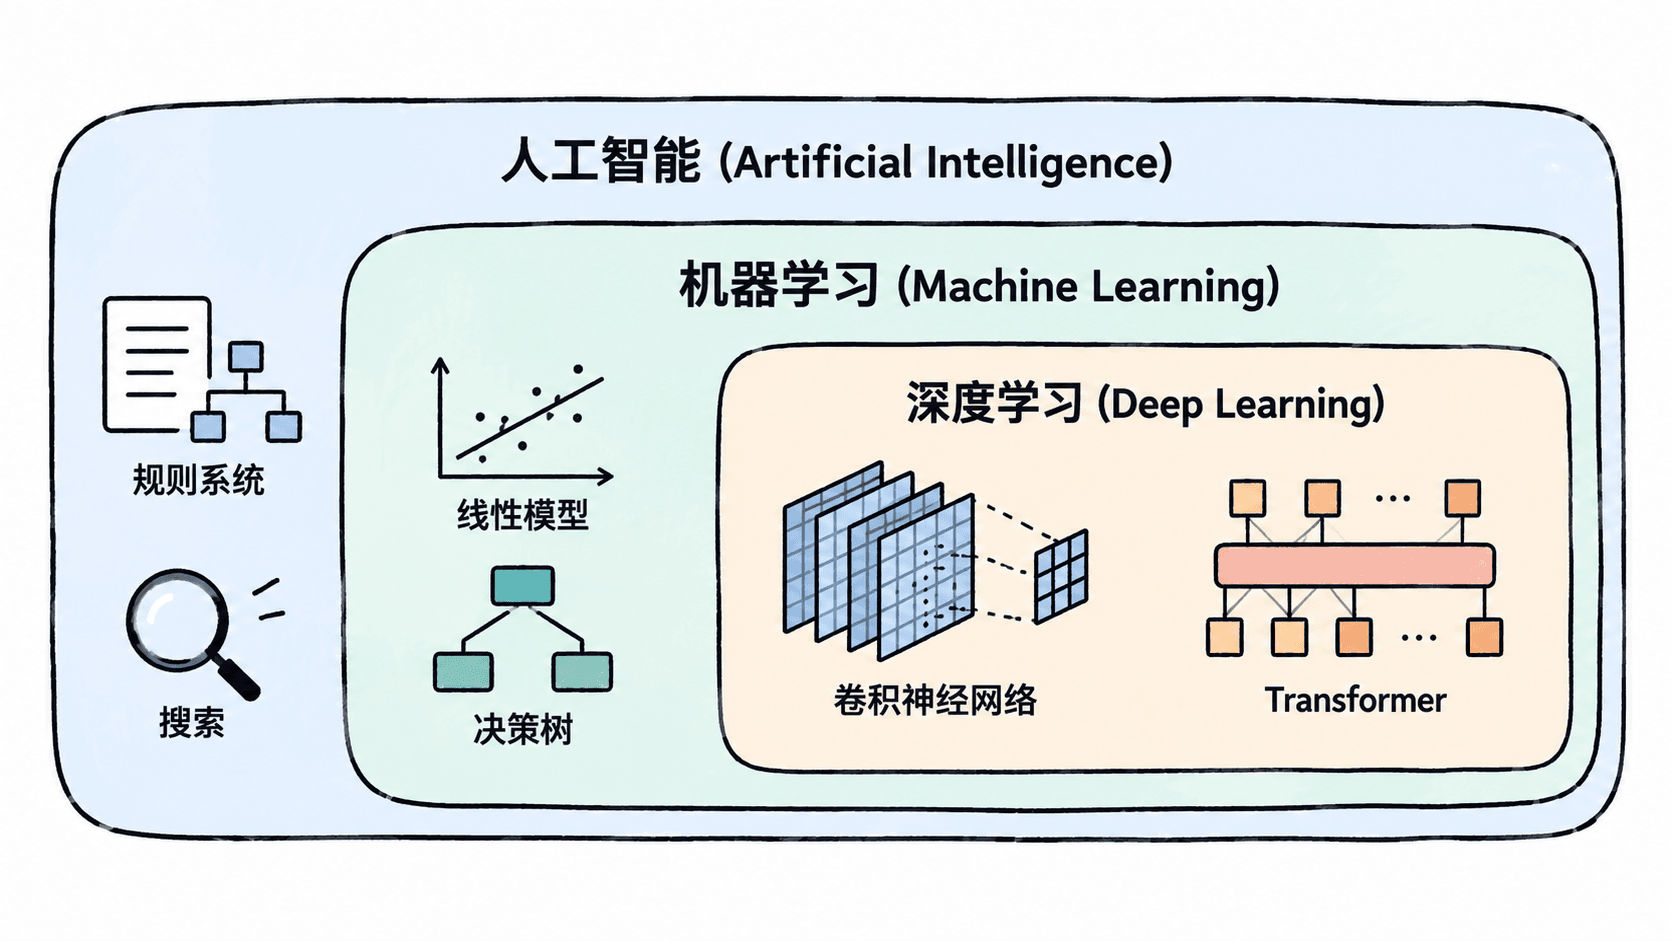
判断时可以看“规则从哪里来”。例如游戏角色按“距离小于 5 米就攻击”执行,这是人工编写规则;垃圾邮件分类器从带标签邮件中学习权重,属于机器学习;图像分类网络从像素中自动学习边缘、纹理和物体特征,则属于深度学习。
| 问题 | 更典型的方法 | 判断依据 |
|---|---|---|
| 固定税率计算 | 普通程序规则 | 公式明确,无需从数据学习 |
| 20 个结构化字段预测违约 | 传统机器学习也常适用 | 特征已经结构化 |
| 数万张照片识别缺陷 | 深度学习常适用 | 输入高维且视觉特征难手工定义 |
| 长文本分类与生成 | 深度学习常适用 | 需要从大量序列数据学习表示 |
深度学习怎样学到参数
训练并不是把样本“记住”,而是不断比较预测结果与正确答案,再调整网络中的权重。假设有 60000 个训练样本、批大小为 64,一个 epoch 大约需要 次参数更新;训练 10 个 epoch 就会经历约 9380 个批次。
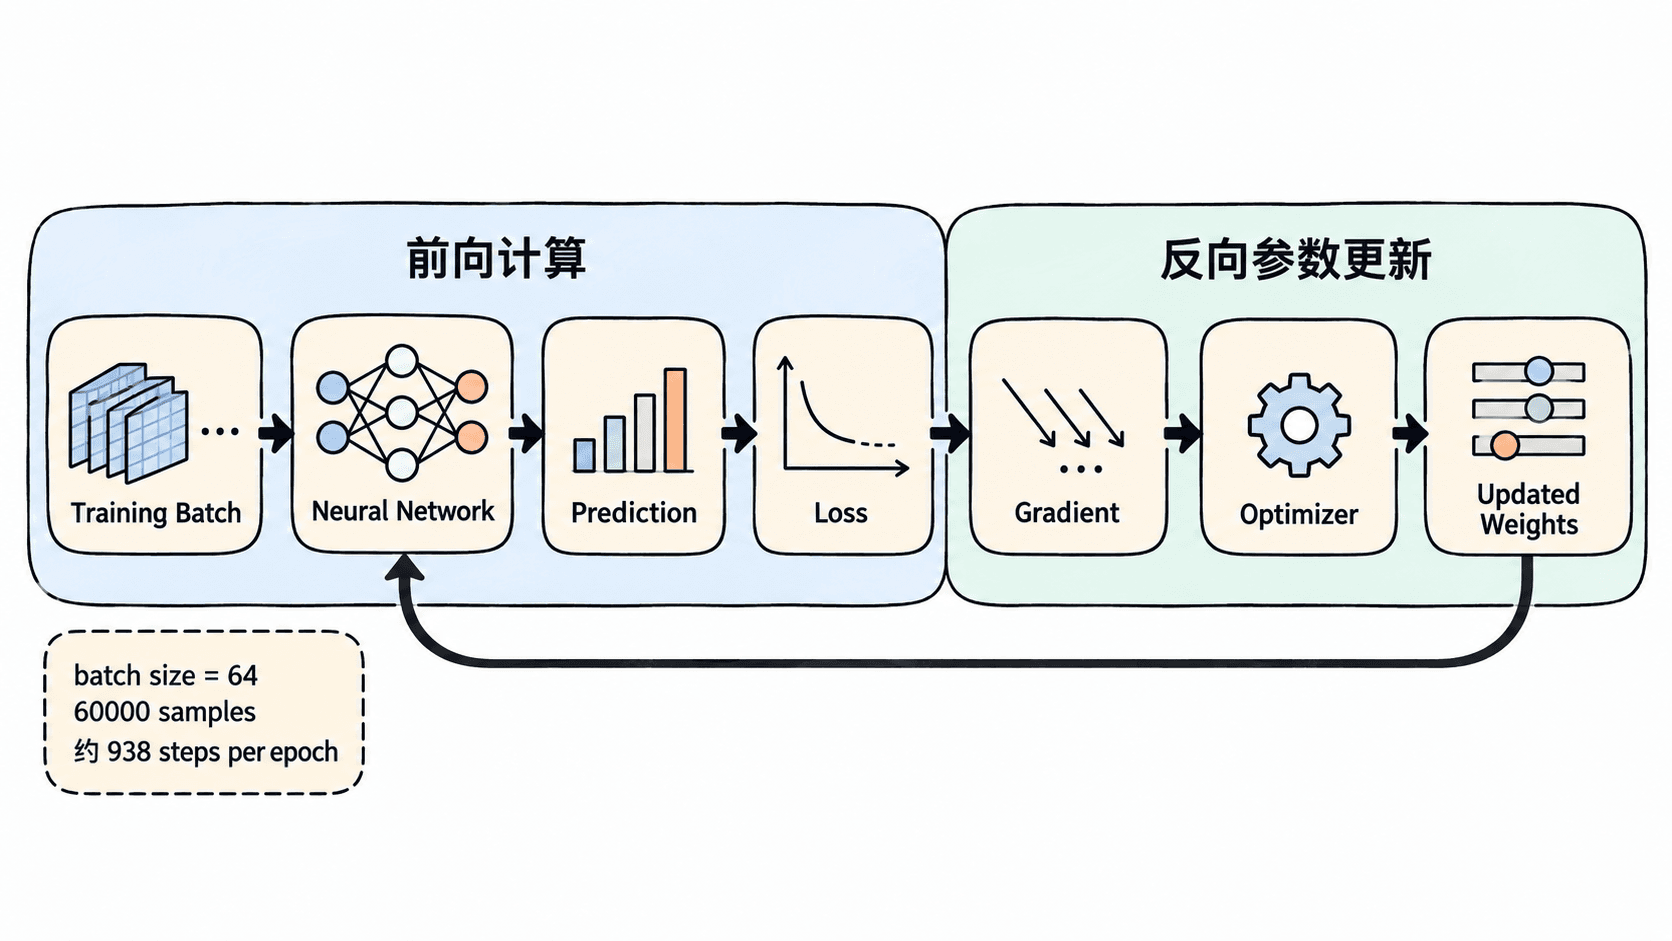
一次更新通常先让当前网络完成前向计算,得到预测值;随后用损失函数衡量预测与标签的差异,再通过自动微分得到各参数对损失的影响方向,最后由优化器更新参数。重复这一过程后,训练集损失通常下降,但仍要用未参与参数更新的验证数据检查泛化能力。
哪些问题值得使用深度学习
深度学习特别适合图像、语音、文本等非结构化数据,以及特征本身很难人工设计的问题。例如需要识别 50000 张工业照片中的裂纹时,让卷积网络直接学习视觉特征通常比人工定义几十条纹理规则更有扩展性。
反过来,如果只有 500 行数据、20 个已经整理好的数值字段,先尝试逻辑回归、梯度提升树等方法通常更容易训练和解释。这里的 500 行与 50000 张只是实践中的对比例子,不是硬门槛;最终应通过验证集指标、训练成本和推理要求决定方案。
选择模型时可以先做三个检查:输入是否包含大量难以手工编码的模式,是否有足够可靠的训练样本,以及模型提升是否值得额外的计算和部署成本。只有三项都成立时,深度学习的复杂度才更可能带来实际收益。