
机器学习与深度学习 / 系统课时
归一化数值特征
归一化数值特征
数值特征的量纲差异会直接影响梯度更新。这里用 TensorFlow 把年龄、金额等不同尺度的特征统一到可训练范围,并重点处理最容易造成数据泄漏的问题:均值、方差、最小值和最大值只能从训练集拟合,再原样应用到验证集、测试集和线上数据。
学习目标
- 区分 Z-score 标准化与 Min-Max 缩放的适用方式。
- 使用
tf.keras.layers.Normalization从训练数据拟合均值和方差。 - 检查缩放后的数值范围,并避免验证集或测试集参与统计量计算。
先选缩放方式
Z-score 标准化把每个特征变换为 ,通常适合没有固定上下界的连续特征。Min-Max 缩放使用 ,训练区间内的数据会映射到 0~1,更适合明确希望控制输入范围的场景。
| 原始特征 | 示例范围 | 推荐起点 | 处理后的典型尺度 |
|---|---|---|---|
| 年龄 | 18~80 | Z-score | 均值约 0、标准差约 1 |
| 年收入 | 20000~500000 | Z-score | 均值约 0、标准差约 1 |
| 百分比 | 0~100 | Min-Max | 0~1 |
| 已在 0~1 内的概率 | 0~1 | 通常不再缩放 | 0~1 |
不要仅因为数值大就使用 Min-Max。例如收入存在少量极端值时,最大值会显著压缩其他样本;这类数据可以先检查异常值,再选择 Z-score、对数变换或截断策略。
只用训练集拟合统计量
预处理统计量属于模型训练结果的一部分。正确顺序是先划分数据,再用训练集计算均值、方差或边界;验证集和测试集只能读取这些已经冻结的参数。若先在全量数据上调用 adapt(),模型虽然没有直接看到测试标签,却已经利用了测试特征分布。
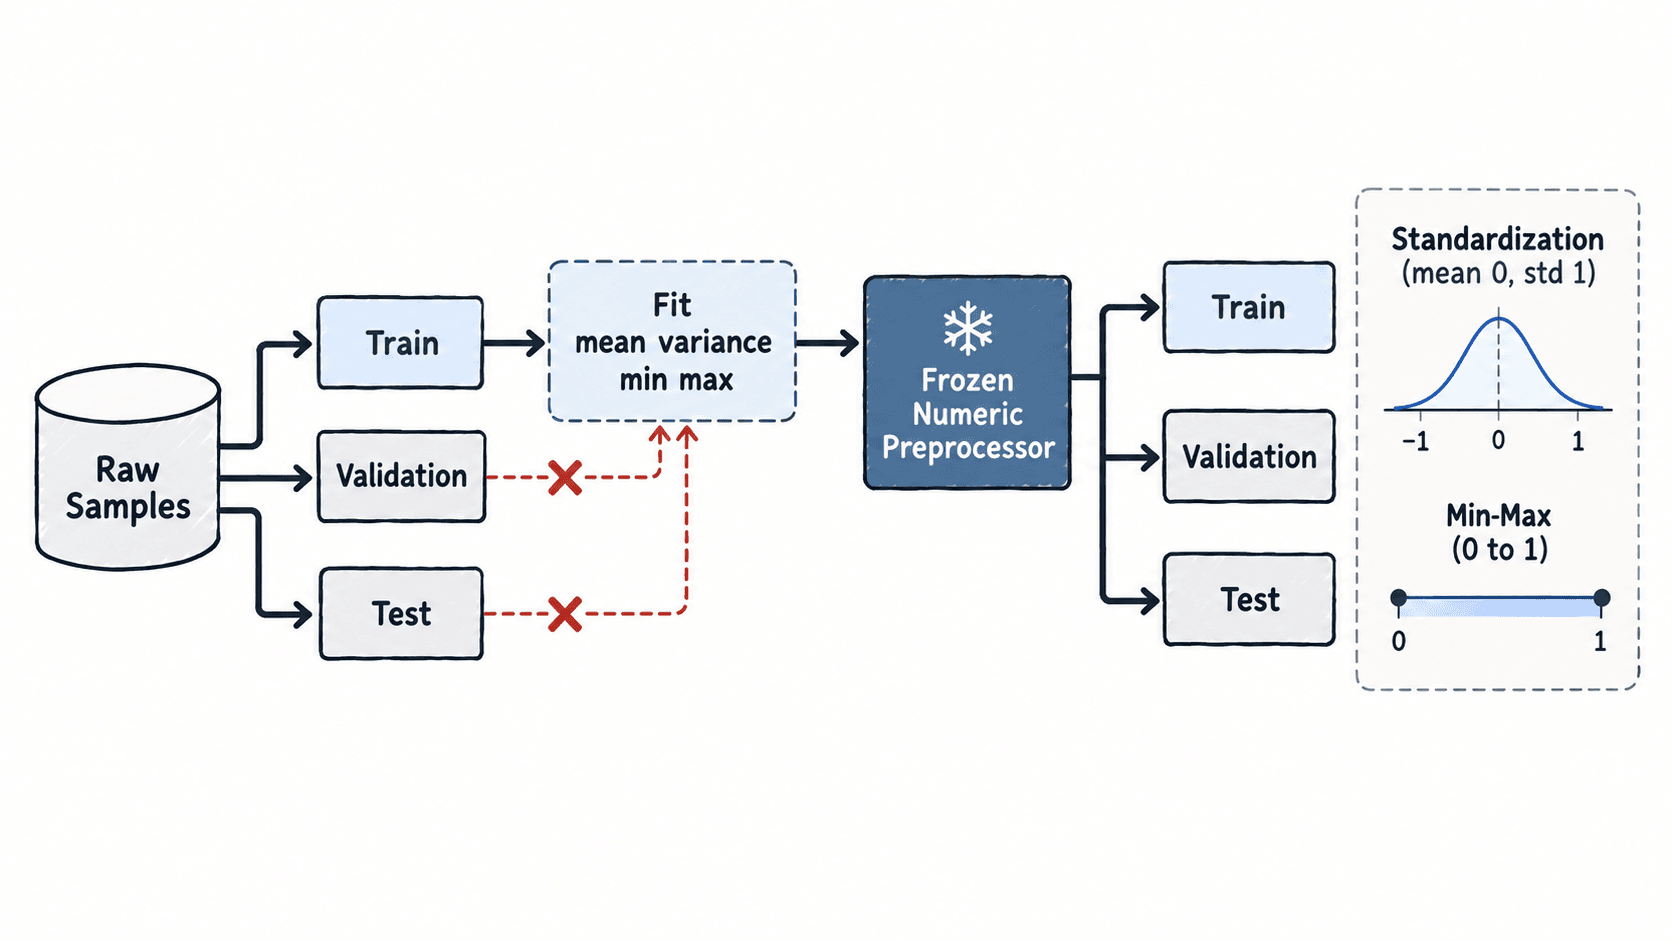
真实项目中可以把 Normalization 层直接放进 Keras 模型,让导出的 SavedModel 保留同一套预处理。无论预处理写在模型内部还是输入流水线中,关键约束都一样:只对训练分片执行拟合。
用 TensorFlow 完成两种缩放
下面用 4 条训练样本拟合统计量,再处理两条未参与拟合的样本。Normalization.adapt() 会按特征维计算均值和方差;Min-Max 示例则显式保存训练集的最小值与最大值。
import numpy as np
import tensorflow as tf

np.set_printoptions(precision=3, suppress=True)

x_train = np.array([
    [20.0, 2000.0],
    [30.0, 3000.0],
    [40.0, 4000.0],
    [50.0, 5000.0],
], dtype=np.float32)

x_eval = np.array([
    [25.0, 2500.0],
    [45.0, 4500.0],
], dtype=np.float32)

# 只从训练集学习统计量。
standardizer = tf.keras.layers.Normalization(axis=-1)
standardizer.adapt(x_train)

print('mean:', standardizer.mean.numpy().reshape(-1))
print('z-score:')
print(standardizer(x_eval).numpy())

# Min-Max 的上下界同样只能来自训练集。
feature_min = tf.constant(x_train.min(axis=0), dtype=tf.float32)
feature_max = tf.constant(x_train.max(axis=0), dtype=tf.float32)
scaled = (tf.constant(x_eval) - feature_min) / (feature_max - feature_min)

print('min-max:')
print(scaled.numpy())
预期输出
mean: [  35. 3500.]
z-score:
[[-0.894 -0.894]
 [ 0.894  0.894]]
min-max:
[[0.167 0.167]
 [0.833 0.833]]
两个原始特征相差约 100 倍,但标准化后进入相近数量级。Min-Max 的结果也保持了样本在训练区间中的相对位置,例如年龄 25 对应 。
检查边界和异常值
Min-Max 并不保证未来样本永远落在 0~1。若训练集年龄最大值为 50,而线上出现 60,则结果是 。只有业务明确要求硬限制时,才额外使用 tf.clip_by_value(value, 0.0, 1.0);否则保留超界值更容易暴露数据分布漂移。
还要处理常量特征。如果某列训练数据的最大值等于最小值,Min-Max 分母就是 0,应删除这类无信息特征,或在实现中对分母设置保护值。验证时至少记录每列训练均值、标准差、最小值和最大值,并抽查验证集变换结果是否出现 NaN、Inf 或异常大的绝对值。
模型上线后应继续复用训练阶段冻结的统计量,而不是按单个请求重新计算均值和方差。重新训练时可以重新拟合预处理参数;单纯推理时则必须保持参数不变,否则同一个原始数值会随请求批次变化而得到不同输入。