
机器学习与深度学习 / 系统课时
理解模型开发生命周期
理解模型开发生命周期
一个可上线的深度学习模型不是“训练完成”就结束,而是要让数据、训练、评估、导出与线上推理形成可追踪闭环。本节用一个最小 TensorFlow 模型走完整流程,并明确每一阶段应该留下什么可验证产物。
学习目标
- 能按数据准备、模型构建、训练、评估、导出、部署的顺序组织一次模型迭代
- 能为每个阶段设置可检查的输入、输出和回退条件
- 能用 TensorFlow 2.16+ 完成一次训练、导出与重新加载验证
生命周期不是六个孤立步骤
工程中常用的主链路是 Data → Build → Train → Evaluate → Export → Deploy,但评估不通过时应回到数据或模型阶段,线上指标异常时也应回流到数据与评估。比如验证集准确率目标为 0.90,实际只有 0.84,就不应该继续部署。
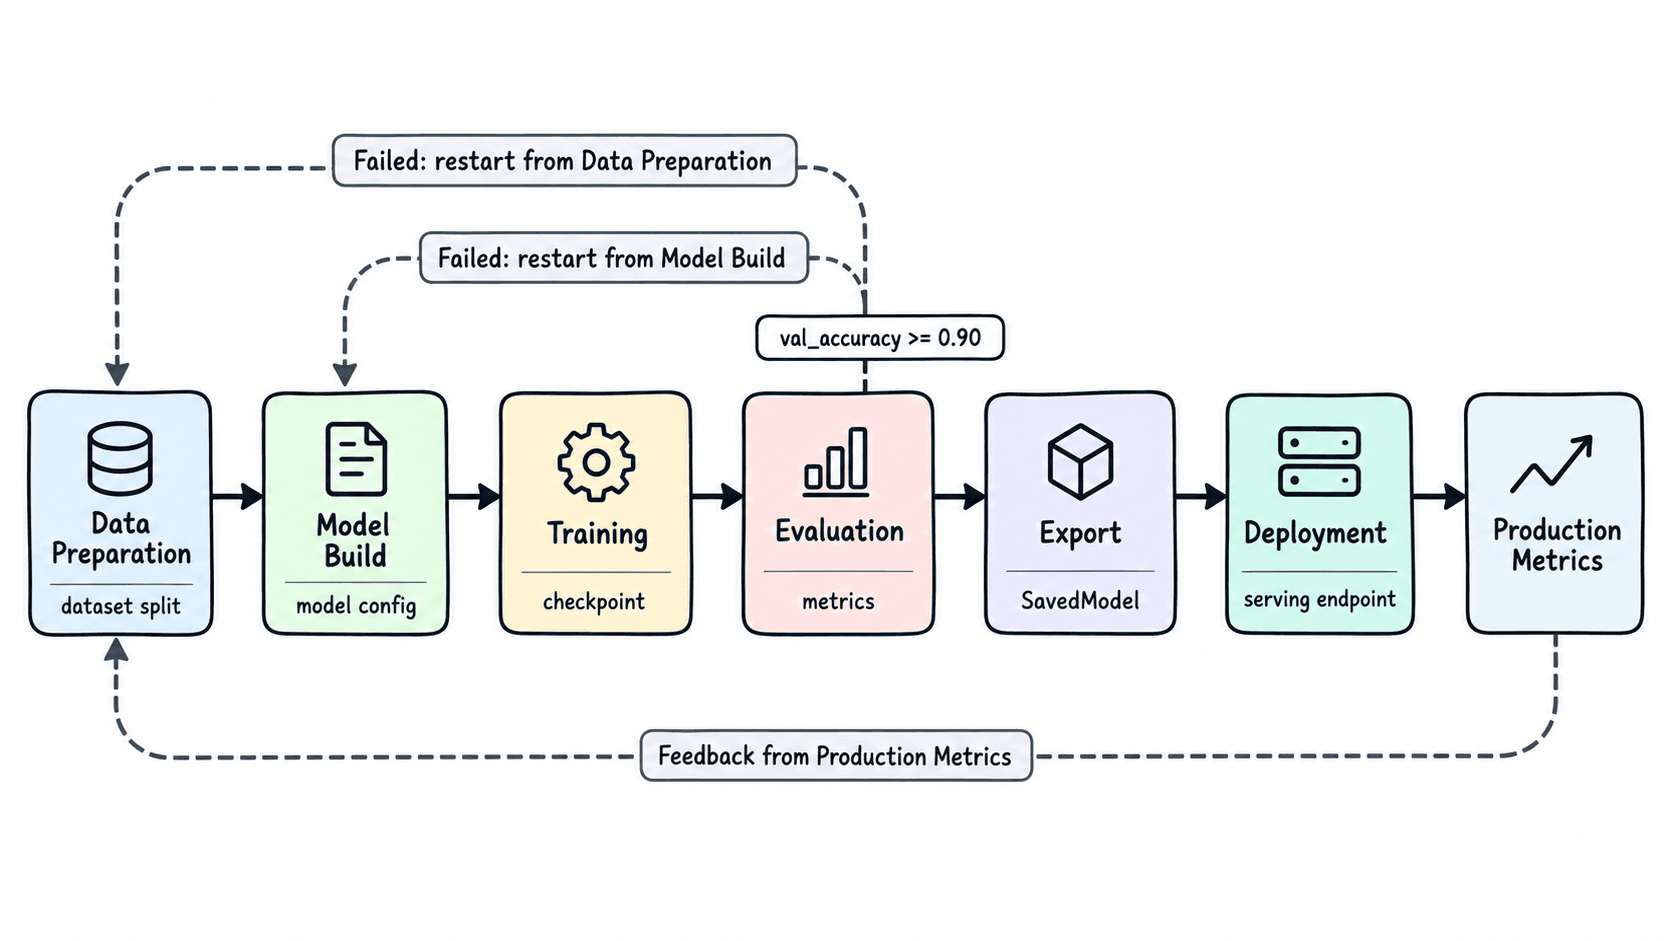
实际项目还要给数据版本和代码版本绑定标识。最少应记录训练数据版本、随机种子、模型超参数与评估结果;否则同一个“模型版本”无法复现,出现线上回归时也很难判断是数据、代码还是参数发生了变化。
用最小模型走完一次闭环
下面示例适用于 TensorFlow 2.16+ 默认使用的 Keras 3。它用 8 条二维样本完成训练和评估,再通过 model.export() 导出 SavedModel,最后重新加载导出物并执行一次推理,从而验证“训练产物真的可部署读取”。
import os
from pathlib import Path

os.environ["TF_CPP_MIN_LOG_LEVEL"] = "2"

import numpy as np
import tensorflow as tf

tf.keras.utils.set_random_seed(7)

x = np.array([
    [0.0, 0.0], [0.0, 1.0], [1.0, 0.0], [1.0, 1.0],
    [0.2, 0.1], [0.1, 0.9], [0.9, 0.1], [0.8, 0.9],
], dtype=np.float32)
y = np.array([0, 1, 1, 1, 0, 1, 1, 1], dtype=np.float32)

x_train, x_test = x[:6], x[6:]
y_train, y_test = y[:6], y[6:]

model = tf.keras.Sequential([
    tf.keras.layers.Input(shape=(2,)),
    tf.keras.layers.Dense(4, activation="relu"),
    tf.keras.layers.Dense(1, activation="sigmoid"),
])
model.compile(
    optimizer=tf.keras.optimizers.Adam(learning_rate=0.01),
    loss="binary_crossentropy",
    metrics=["accuracy"],
)

model.fit(x_train, y_train, epochs=30, batch_size=2, verbose=0)
loss, accuracy = model.evaluate(x_test, y_test, verbose=0)

export_dir = Path("artifacts/saved_model")
export_dir.parent.mkdir(parents=True, exist_ok=True)
model.export(export_dir)

reloaded = tf.saved_model.load(str(export_dir))
predictions = reloaded.serve(tf.constant(x_test))

print("train_shape=", x_train.shape)
print("evaluation_finite=", bool(np.isfinite(loss) and np.isfinite(accuracy)))
print("prediction_shape=", tuple(predictions.shape))
print("saved_model_exists=", (export_dir / "saved_model.pb").exists())预期输出(model.export() 还会打印导出端点说明,最后几行应包含):
train_shape= (6, 2)
evaluation_finite= True
prediction_shape= (2, 1)
saved_model_exists= True
如果使用 TensorFlow 2.15 或更早版本,不要直接照搬 model.export();旧版 tf.keras 的 SavedModel 保存接口与 Keras 3 不同,应按项目锁定的 TensorFlow 版本选择对应导出方式。
每个阶段该留下什么
生命周期能否复现,取决于阶段产物是否明确。一个小型分类项目至少应保留:数据切分清单、模型结构与超参数、最佳权重或 checkpoint、验证指标、可部署导出物,以及部署版本到模型版本的映射。
| 阶段 | 最小输入 | 应留下的产物 | 通过条件示例 |
|---|---|---|---|
| 数据准备 | 原始样本 | train/val/test 切分与版本 | 三份数据无重复 ID |
| 模型构建 | 输入形状、任务定义 | 模型配置 | model.output_shape 符合任务 |
| 训练 | train、超参数 | checkpoint、训练日志 | loss 无 NaN/Inf |
| 评估 | 固定验证集 | 指标文件 | val_accuracy >= 0.90 |
| 导出 | 已通过评估的模型 | SavedModel | 存在 saved_model.pb |
| 部署 | 导出物、推理约定 | 服务版本 | 冒烟请求返回正确张量形状 |
不要把测试集反复用于调参,否则测试集会逐渐变成“第二验证集”。常见做法是日常迭代只看训练集和验证集,最终候选模型确定后再在测试集上做一次独立验收。
什么时候回退而不是继续部署
评估失败时先判断问题属于数据、模型还是训练过程。比如训练准确率 0.99、验证准确率 0.78,优先检查过拟合与数据分布;训练和验证都只有 0.60,则先检查特征、标签和模型容量,而不是盲目增加 epoch。
线上也要设置回退门槛。假设离线 AUC 从 0.91 提升到 0.93,但上线后 P95 推理延迟从 45 ms 升到 110 ms,而服务预算是 80 ms,这个版本仍应回滚或重新优化。模型生命周期的完成条件,是质量、可复现性和部署约束同时通过,而不是单一指标变好。