
机器学习与深度学习 / 系统课时
划分训练验证测试集
划分训练验证测试集
数据集划分决定了模型能否被公平评估。本课用固定随机种子完成 70%/15%/15% 的分层划分,并明确预处理统计量只能从训练集拟合,避免同一对象、未来信息或测试集统计量提前泄漏到训练过程。
学习目标
- 能按训练集、验证集、测试集的职责设计划分比例,并让结果可复现。
- 能对分类数据做分层划分,并识别重复对象、时间穿越和预处理泄漏。
- 能把划分结果转换为
tf.data.Dataset,并用数量与类别分布做验收。
先确定样本边界与划分规则
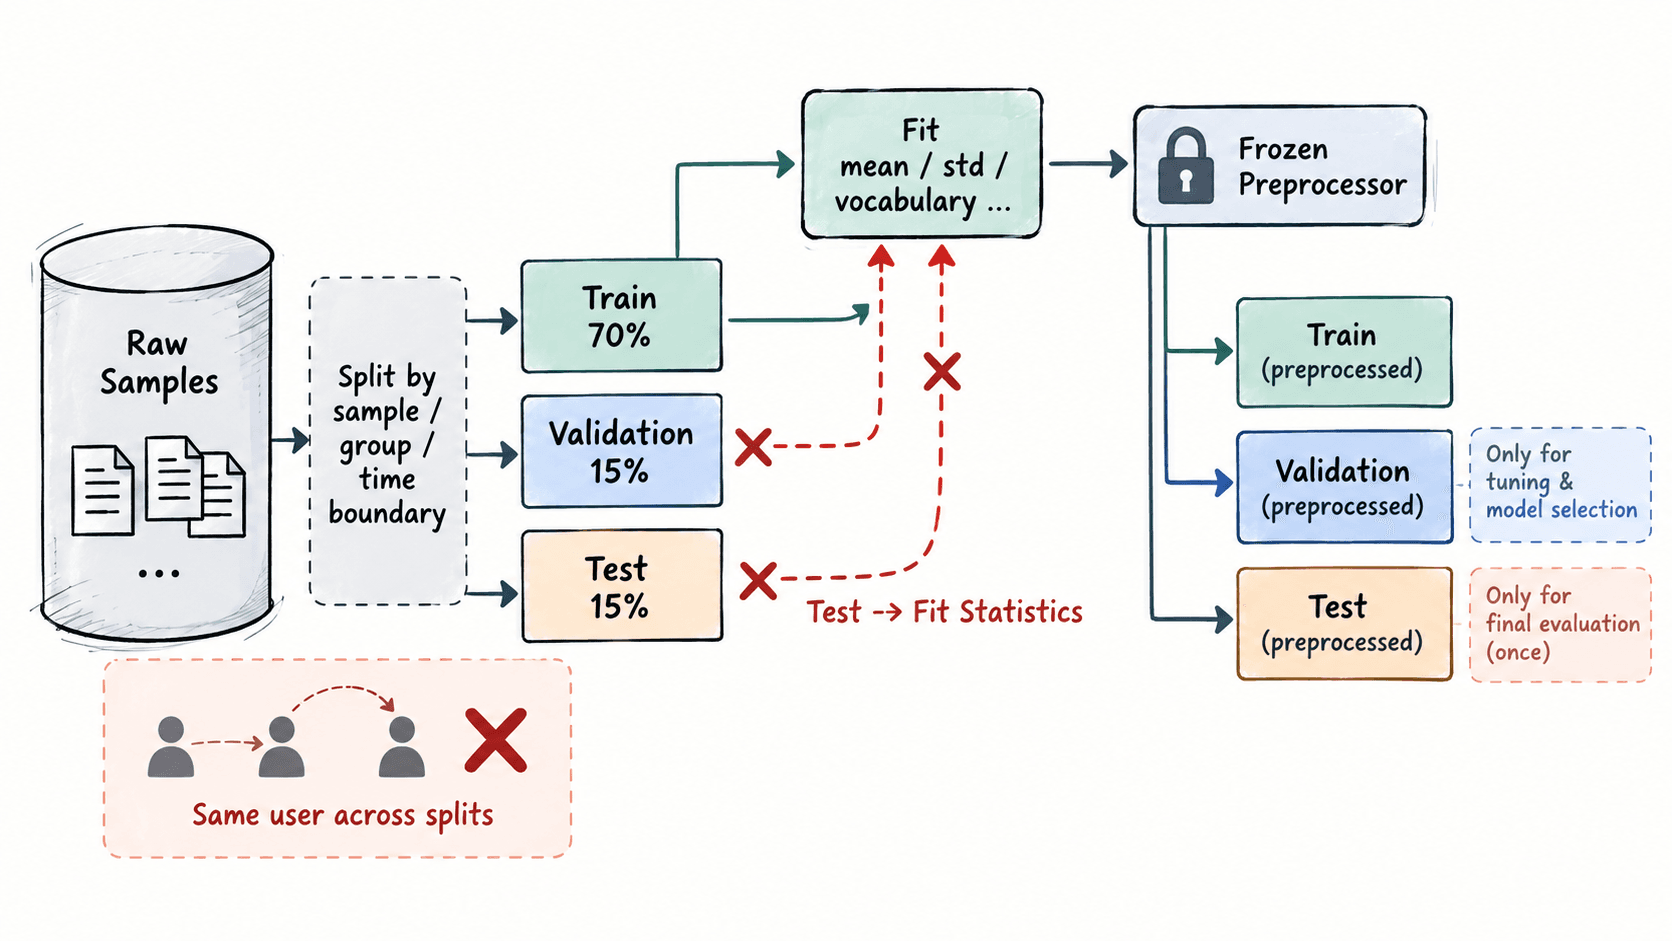
最常见的起点是训练集 70%、验证集 15%、测试集 15%。训练集用于拟合参数,验证集用于调超参数和选择模型,测试集只在方案冻结后做最终评估。若同一用户有多条记录,应按 user_id 整组划分;若数据有时间顺序,则应按时间切分,不能随机把“未来”样本混进训练集。
以 100 个二分类样本为例,类别 0 有 80 个、类别 1 有 20 个。若按类别分别做 70%/15%/15% 划分,可得到训练集 56/14、验证集 12/3、测试集 12/3,使少数类在三个集合中都保留 20% 的占比。
用固定随机种子做分层划分
下面的示例只依赖 NumPy 与 TensorFlow 2.x。它先在每个类别内部打乱索引,再分别切出 70%、15%、15%,最后把训练集包装成 tf.data.Dataset。固定 seed=42 后,同一份输入会得到一致的划分。
import numpy as np
import tensorflow as tf

x = np.arange(100, dtype=np.float32).reshape(-1, 1)
y = np.array([0] * 80 + [1] * 20, dtype=np.int32)
rng = np.random.default_rng(42)

splits = {"train": [], "val": [], "test": []}

for cls in np.unique(y):
    idx = np.where(y == cls)[0]
    rng.shuffle(idx)

    n = len(idx)
    n_train = int(n * 0.70)
    n_val = int(n * 0.15)

    splits["train"].extend(idx[:n_train])
    splits["val"].extend(idx[n_train:n_train + n_val])
    splits["test"].extend(idx[n_train + n_val:])

for name in splits:
    splits[name] = np.array(splits[name], dtype=np.int32)

for name, idx in splits.items():
    counts = np.bincount(y[idx], minlength=2)
    print(
        f"{name}: samples={len(idx)}, "
        f"class0={counts[0]}, class1={counts[1]}"
    )

train_ds = tf.data.Dataset.from_tensor_slices(
    (x[splits["train"]], y[splits["train"]])
)
train_ds = train_ds.shuffle(
    buffer_size=len(splits["train"]),
    seed=42,
    reshuffle_each_iteration=False,
).batch(16)

print("train batches=", train_ds.cardinality().numpy())
预期输出
train: samples=70, class0=56, class1=14
val: samples=15, class0=12, class1=3
test: samples=15, class0=12, class1=3
train batches= 5
当样本数很少时,直接取整可能让某个小类别在验证集或测试集中变成 0 个。实际项目应先检查每个类别的样本量;例如某类只有 4 个样本,就不适合机械地按 15% 切出测试集,而应扩大数据量或使用交叉验证。
把预处理拟合限制在训练集
划分必须发生在“学习统计量”之前。标准化的均值和标准差、词表、缺失值填充值、目标编码规则,都只能由训练集计算,再以冻结参数作用于验证集和测试集。否则验证或测试样本的信息会影响训练输入,评估值通常会偏乐观。
例如训练集某特征均值为 10、标准差为 2,验证集样本值为 14,则标准化结果应是 。即使把验证集一起统计后得到均值 11,也不能重新拟合,因为这已经让验证数据参与了预处理参数的确定。
用三项检查确认没有串集
交付数据管线前至少做三项检查:三个集合的样本 ID 交集应为空;分类任务各集合的类别占比应与原始数据接近;按用户、设备、病人或视频来源等存在强相关性的样本,应检查分组 ID 没有跨集合出现。
对于时间序列,再额外验证 max(train_time) < min(val_time) < min(test_time)。如果验证集已经被反复用于模型选择很多轮,它就不再是“未见数据”;最终泛化能力仍应以从未参与调参的测试集为准。